同一批命令喂给三个版本:Percona 实测 MongoDB 9.0 只比 8.0 快 6%,而且只在 CPU 打满时
MongoDB 9.0 发布时官方晒了一组很好看的数字,但没人说得清测试是怎么跑的——Percona 的 Ivan Groenewold 在上一篇里就此吐槽过,并且留下一句”永远要自己跑一遍基准”。这次他决定兑现自己的话:三套一模一样的三节点副本集、同一个负载生成器、同一个随机种子,把 MongoDB Community 9.0.4、Percona Server for MongoDB 8.0.34-15、PSMDB 8.3.13-4 放在同一条起跑线上。
先说清楚边界:这是一次”快速首测”,不是完整评测——一个负载、一种硬件、三种数据规模。作者自己建议把这些数字当成早期信号,而不是结论。但它的过程是干净的,结论也足够具体。
怎么测的:三套环境只差一个版本号
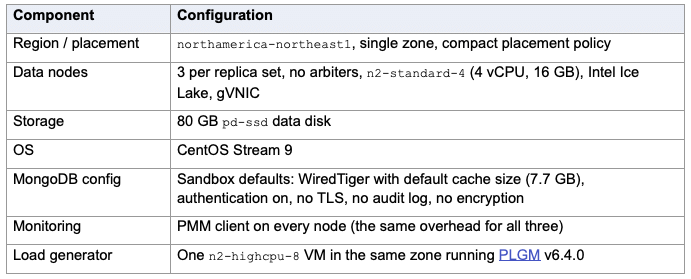
图:三套副本集的唯一差别是 MongoDB 包版本(图源:Percona 官方博客)
全部用 PSMDB Sandbox 部署在 Google Cloud,每个版本一个三节点副本集,无仲裁节点:
- – 数据节点:n2-standard-4(4 vCPU / 16 GB),Intel Ice Lake,GVNIC,每节点 80 GB pd-ssd 数据盘,CentOS Stream 9
- – 数据库配置:Sandbox 默认值——WiredTiger 默认缓存 7.7 GB,开认证、不开 TLS/审计/加密
- – 监控:每个节点都装 PMM 客户端(三份开销相同,不构成偏差)
- – 压测机:同可用区一台 n2-highcpu-8,跑 PLGM v6.4.0
负载用的是 PLGM 内置的 “flights” 场景(airline.flights 集合,7 个二级索引):60% 查询、20% 更新、10% 删除、10% 插入(10 条一批),16 个 worker 无思考时间——上一条命令一返回就发下一条。写操作走服务端默认 write concern,因此包含复制开销。每轮开始前集合都会删掉重建。
三种数据规模是这次测试真正的变量:
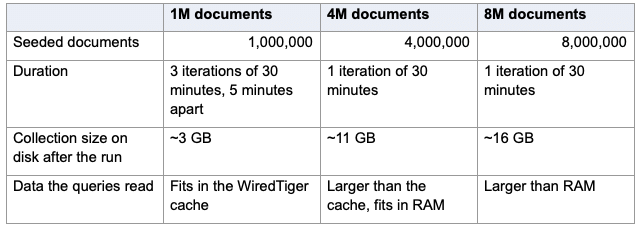
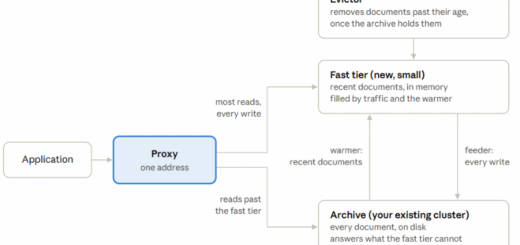
图:1M / 4M / 8M 三档,分别对应”装得进缓存””装不进缓存但装得进内存””连内存都装不下”(图源:Percona 官方博客)
- – 1M 文档(跑完约 3 GB):数据装得进 WiredTiger 缓存,缓存命中基本不落盘
- – 4M 文档(约 11 GB):大于缓存、装得进操作系统页缓存,缓存未命中通常也不用读盘
- – 8M 文档(约 16 GB):连内存都装不下;压缩比约 2:1,所以只有约 25% 的文档能待在 WT 缓存里
最值钱的设计是”确定性”:每条命令都由固定种子(178477)+ 迭代号 + worker 号 + 操作序号生成,所以三个版本收到的是完全相同的命令、相同的取值、相同的顺序,每个 worker 每轮 25 万条。1M 和 4M 两档里每个版本都跑完了至少一整轮,PLGM 的流量指纹对得上(1M 是 c0a88fae…,4M 是 9734a782…)。8M 档服务器慢到 30 分钟跑不完一轮,于是各家都只发了同一序列的前 270–280 万条——因为命令仍然一致,作者还是逐操作做了对比。
结果:CPU 是瓶颈时差距最大,内存富余时几乎抹平
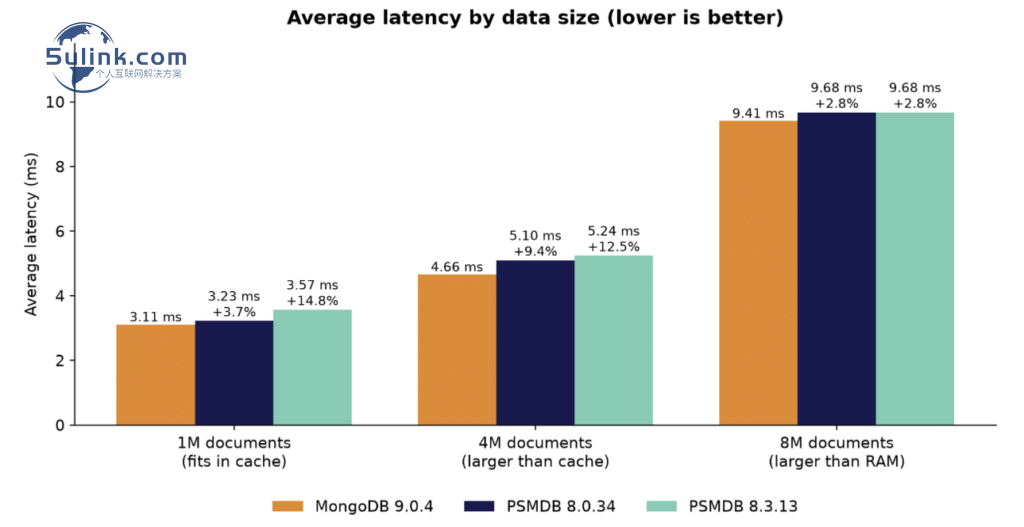
图:平均延迟对比——4M 档差距最明显(图源:Percona 官方博客)
| 数据规模 | 吞吐(命令/秒) | 平均延迟(ms) |
|---|---|---|
| 1M(装得进缓存) | 9.0.4 3,667 / 8.0.34 3,581(-2.3%)/ 8.3.13 3,342(-8.9%) | 9.0.4 3.11 / 8.0.34 3.23(+3.7%)/ 8.3.13 3.57(+14.8%) |
| 4M(大于缓存) | 9.0.4 2,759 / 8.0.34 2,585(-6.3%)/ 8.3.13 2,530(-8.3%) | 9.0.4 4.66 / 8.0.34 5.10(+9.4%)/ 8.3.13 5.24(+12.5%) |
| 8M(大于内存) | 9.0.4 1,546 / 8.0.34 1,510(-2.3%)/ 8.3.13 1,510(-2.3%) | 9.0.4 9.41 / 8.0.34 9.68(+2.8%)/ 8.3.13 9.68(+2.8%) |
一句话总结这张表:9.0 在每一档上的每操作 CPU 用量都比 8.0 和 8.3 低,所以 CPU 成为瓶颈时(4M 档)它领先约 6%,而当数据能舒舒服服放在内存里、或者瓶颈已经落到磁盘上时,领先只剩约 2%。有意思的是”中间版本” 8.3 在凡是 CPU 参与瓶颈的地方都是三者最慢的——按直觉”版本号更新就更快”来选版本,这次会翻车。
时间曲线:缓存装得下时三家咬得最紧
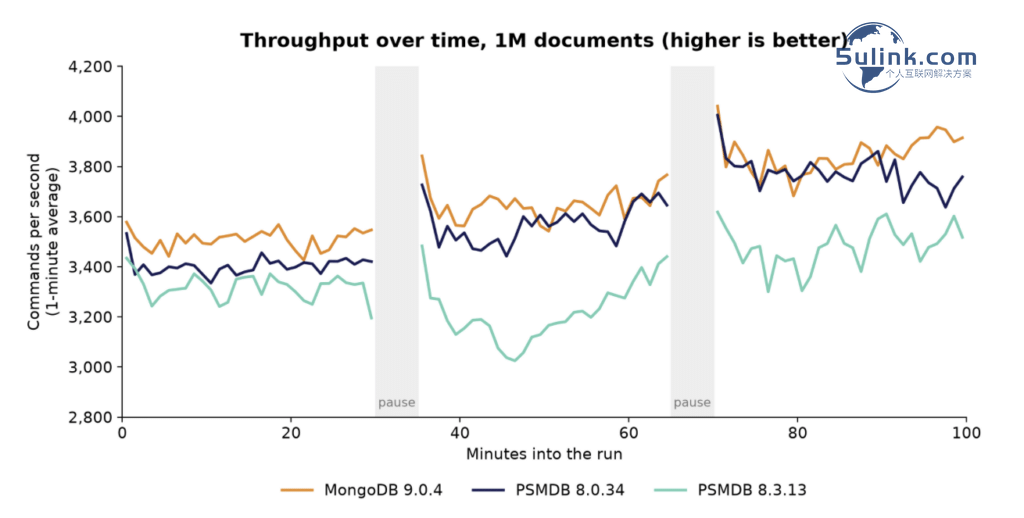
图:1M 档,1 分钟平均吞吐,每条线按自己的运行时钟绘制(图源:Percona 官方博客)
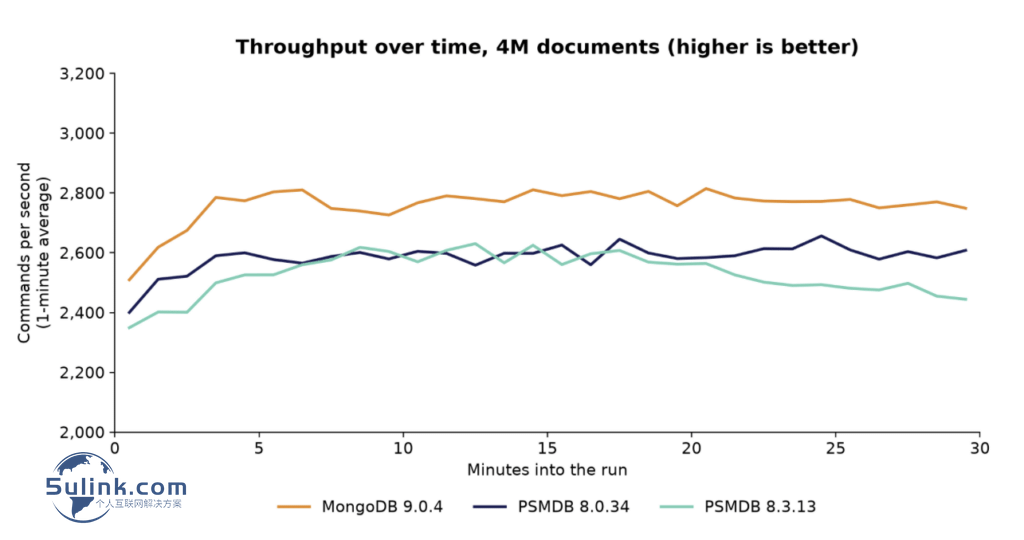
图:4M 档,9.0 全程保持领先(图源:Percona 官方博客)
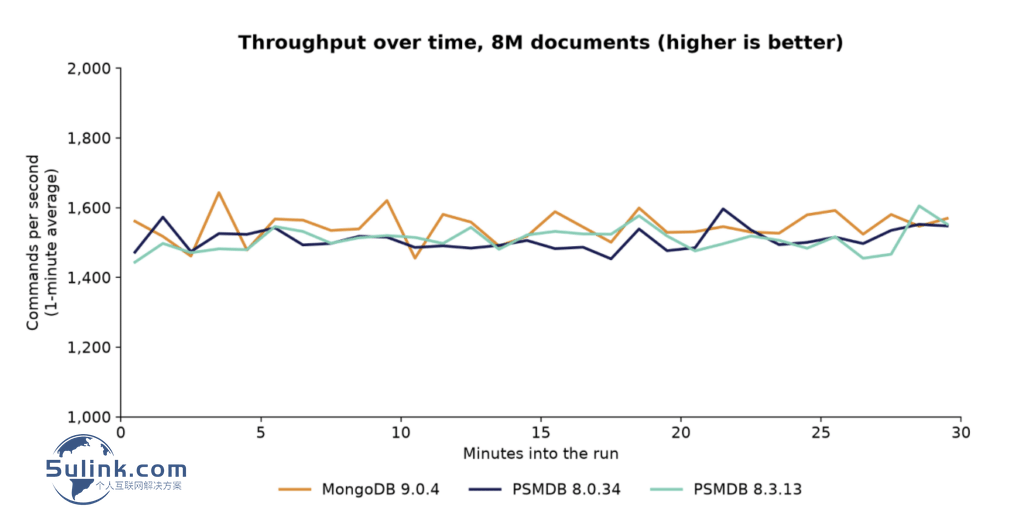
图:8M 档,三条线大部分时间重叠在一起(图源:Percona 官方博客)
三条曲线放在一起看,能看出这次测试真正的信息量:1M 档 9.0 全程领先、8.0 紧随其后、8.3 明显垫底,而且差距在后两轮被拉大;4M 档 9.0 全程保持领先;8M 档三条线大部分时间重叠在一起。版本优化体现在”CPU 要干活”的路径上(缓存未命中后从页缓存取数、解析和执行),一旦瓶颈完全落到磁盘上,三家就被拉回同一条线。
尾延迟:内存吃紧时,9.0 的优势消失
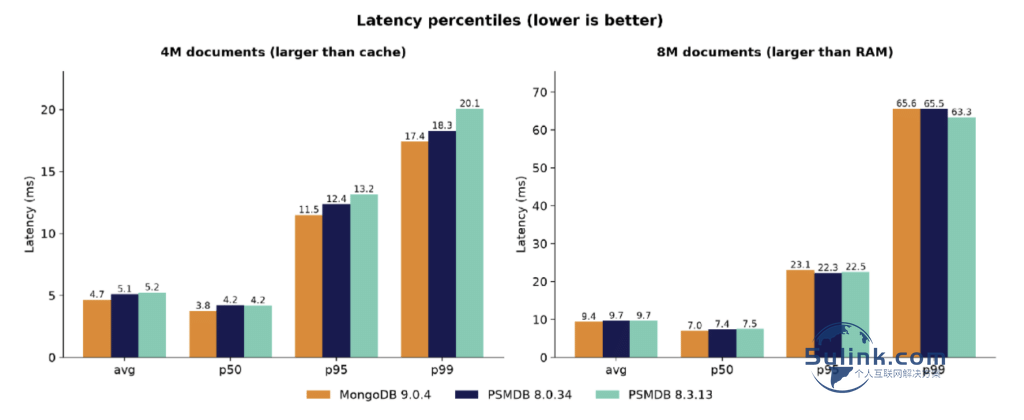
图:4M 档 9.0 每个分位数都领先;8M 档三家尾延迟基本持平(图源:Percona 官方博客)
| 分位数 | 4M:9.0 / 8.0 / 8.3(ms) | 8M:9.0 / 8.0 / 8.3(ms) |
|---|---|---|
| 平均 | 4.7 / 5.1 / 5.2 | 9.4 / 9.7 / 9.7 |
| p50 | 3.8 / 4.2 / 4.2 | 7.0 / 7.4 / 7.5 |
| p95 | 11.5 / 12.4 / 13.2 | 23.1 / 22.3 / 22.5 |
| p99 | 17.4 / 18.3 / 20.1 | 65.6 / 65.5 / 63.3 |
4M 档 9.0 在每一个分位数上都领先;但到了 8M 档,p95 和 p99 反过来了——老版本略快一点点。对在线业务来说这条比平均吞吐更重要:如果你的 SLA 是按 p99 算的,而工作集已经大到装不进内存,9.0 给不了你任何尾延迟红利。
按查询类型拆开:优势会随数据规模”搬家”
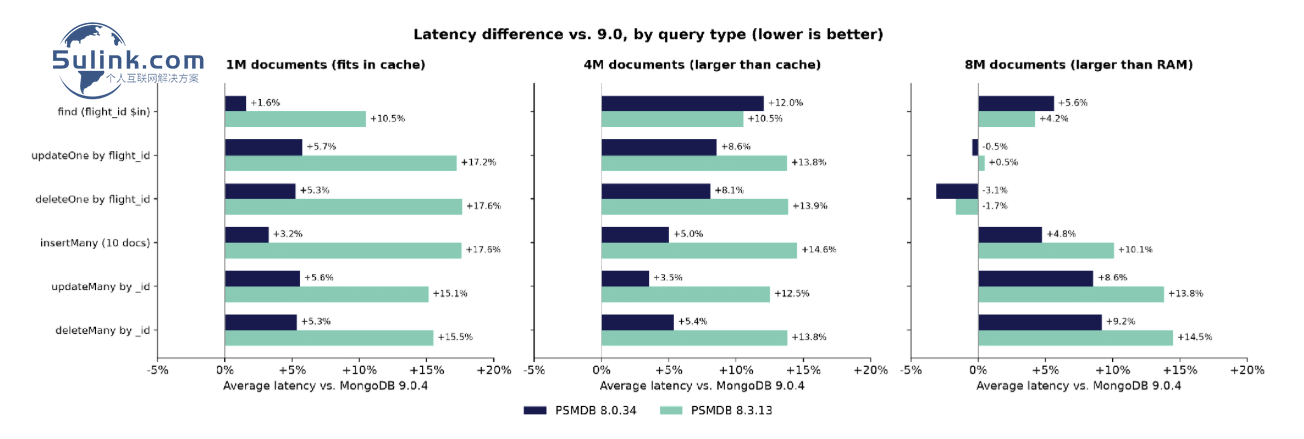
图:相对 9.0 的平均延迟差(越低越好),按数据规模分三栏(图源:Percona 官方博客)
- – 1M 档:9.0 对 8.0 的优势主要出现在写上——updateOne +5.7%、deleteOne +5.3%、insertMany +3.2%(即 8.0 更慢),查询本身只差 1.6%(8.3 在查询上慢 10.5%)
- – 4M 档:优势搬到读上——find 拉开到 +12.0%,是全场最大单项差距
- – 8M 档:按 flight_id 找单条文档的 update/delete(大概率要回盘读)三家基本持平(8.0 在 deleteOne 上快 3.1%,在 updateOne 上慢 0.5%);9.0 只在 find、insert 和按
_id的操作上保持领先
换句话说:9.0 的优化点集中在 CPU 侧(解析、执行、缓存路径),而不是 IO 侧。你的负载越接近”纯内存 + CPU 打满”,升级收益越实;越接近”磁盘 + 尾延迟”,收益越接近零。
执行计划完全相同,所以不是优化器的锅
每次跑完,PLGM 会对每类查询抽样跑 explain。三个版本在所有数据规模下选出的计划完全一致:
- – 查询:
LIMIT → FETCH → IXSCAN,走flight_id_1_equipment.plane_type_1索引 - – 按 flight_id 的更新/删除:
UPDATE/DELETE → FETCH → IXSCAN,同一个索引 - – 按
_id的 updateMany/deleteMany:EXPRESS_UPDATE/EXPRESS_DELETE走_id_
计划一样,意味着上面的差距来自执行效率(每操作 CPU 用量),不是”某个版本挑了个笨计划”。这也是这篇比一般跑分文章可信的地方:它把最大的一个混淆变量排除了。
想自己复现
作者的立场是”鼓励你自己跑一遍”,并且把整套配置都摊开了:GCP 上三套副本集 + PLGM 主机 + PMM,replsets 里分别填 community 9.0.4、psmdb-80 8.0.34、psmdb-83 8.3.13;负载参数全部环境变量化(16 并发、30 分钟、种子 178477、每 worker 25 万条、WORKLOAD_DETERMINISTIC=true)。同样的种子和设置下,流量指纹应该能对上 c0a88fae…(1M)和 9734a782…(4M)。
比跑分本身更有用的是:PLGM 支持自定义集合定义和查询,也能回放从你自己的 mongod 日志里抓到的流量。把上面这套参数换成你线上的读写比例,才是对你有意义的基准。
作者接下来准备多跑几轮、换并发档位、换更快的盘,并查一下 8.3 为什么需要更多 CPU。他的结论和上一篇一致:把 9.0 当成”值得测试的版本”,而不是”必须马上部署的版本”。
小夏点评
- 1. 这篇的价值在方法论,不在那 6%。 固定种子 + 同序命令 + 流量指纹核对,把”版本差异”从随机噪声里摘了出来——绝大多数厂商跑分做不到这点,因为它们是各跑各的随机负载,跑三次能得出三个结论。Percona 顺手把 PSMDB 私有特性全部关掉再对比,也说明这次测的是上游版本差异,不是发行版差异。
- 2. 结论对升级决策非常实用:收益集中在”缓存装不下、CPU 打满”的场景(约 6%),内存富余时只剩 2%;而且 8M 档的 p95/p99 三家基本持平、老版本略好。如果你的瓶颈是磁盘 IO 或者尾延迟 SLA,9.0 不构成升级理由;反过来,如果你的 MongoDB 已经热到 CPU 见顶,这 6% 是可以直接换成机器数量的。
- 3. 对中国 IT 运维/开发者的启示:MongoDB 9.0 在国内生产环境还很少见,真正该抄的是这套做法——用可复现的负载生成器(固定种子、同序命令、指纹核对)把自己的真实读写比例跑一遍再决定升不升,别拿厂商跑分当依据。另外记住”中间版本最慢”这个反直觉结果:跨版本升级不要默认新的就是快的,尤其是当你的负载以写和范围扫描为主的时候。
参考
- – 原文(Percona Blog,2026-11-06,Ivan Groenewold):https://www.percona.com/blog/mongodb-9-0-vs-8-0-vs-8-3-a-quick-first-look-at-performance/
- – 上一篇(MongoDB 9.0: more 8.4 than 9.0):https://www.percona.com/blog/mongodb-9-0-more-8-4-than-9-0/
- – PSMDB Sandbox:https://github.com/percona/psmdb-sandbox