2017 年的卡跑成这样有点离谱:V100 跑 27B 大模型的三条路线与真实速度
一张 2017 年的 Tesla V100,能把 27B 大模型跑到什么程度?
答案取决于你走哪条路,而且不同路线之间的数字根本不能横比。最近把公开实测数据梳理了一遍,同一代 V100 上跑 27B,实测到的有 ~13 tok/s(社区实测官方包)到 322.18 tok/s 单请求,8 路并发峰值 1,083.4 tok/s,中间的差别不在卡,在引擎、量化格式、投机解码策略,甚至在于你下的是不是官方那个编译包。
下面按三条路线分开讲,每条路线的数字都来自对应的公开实测记录,文中标注了出处与口径。
路线一:llama.cpp + Ternary Bonsai 2,先别用官方预编译包
这条路最朴素:拿 PrismML 的 Ternary Bonsai 2 27B 的 GGUF 权重,用 llama.cpp 跑。社区维护者 1bitLabs 在 Hugging Face 上放了一份专门给 V100 的 CUDA 构建(PrismML-Bonsai2-27B-V100-CUDA),并把自己的实测数据直接写进了 README。
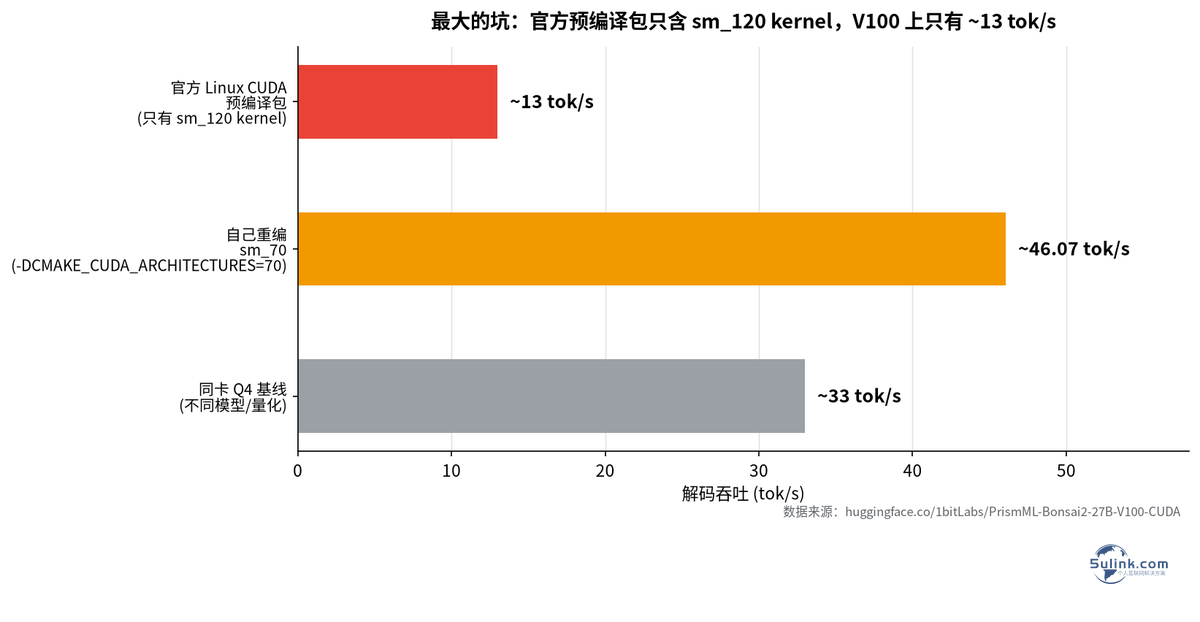
最有价值的是那张「诚实测速表」。官方 PrismML 的 Linux CUDA 预编译包在这张 V100(32GB)上只能跑出 ~13 tok/s,因为 fatbin 里只有 sm_120 的 kernel —— 那是给 Blackwell 架构准备的,Volta 用不上,三元权重的优势直接消失,甚至比同卡的普通 Q4 还慢(同卡 Q4 基线约 33 tok/s)。
自己用 -DCMAKE_CUDA_ARCHITECTURES=70 重编之后,长解码速度变成 ~46.07 tok/s(HTML 场景 ~46.52),调完参的基线均值 ~47.55 tok/s。推荐参数是 -ngl 99 -c 8192 -np 1,而且 Flash-attn(-fa)在他们的 A/B 里反而更慢,建议保持关闭。
作者还专门加了一句提醒:不要指望在 V100 上看到 70–80 tok/s,那个数字来自 Bonsai 1 + DSpark,不是这个包。
真正把这条路线推到实用水位的是 Hugging Face 讨论区 #81 里的一位用户。他在 V100-SXM2-16GB 上用打了 kernel 补丁的 llama.cpp fork 跑 Bonsai 2(PTQ1_0 量化,5.94GB),64K 上下文下生成速度 52.0 tok/s,提示处理约 70 tok/s,显存占用 10.8GB / 16GB。作为对照,未经补丁的官方 PrismML fork 在 16K 下是 36.8 tok/s,补丁带来 +41% 的提升。
他没敢上 128K,虽然能启动(15.0GB 显存、51.8 tok/s),但显存余量太紧,最后退回 64K。他还有一个刻意的选择:不装 MTP head —— 因为 V100 长上下文推理有已知的显存泄漏报告,他直接引用了 llama.cpp 的 issue #29172 和 #28661。
这条路线还有两个容易踩的编译环境坑,都写在同一帖里:CUDA 12.9 是最后一个支持 sm_70 离线编译的 12.x,CUDA 13 直接砍掉了对 sm_70 的离线支持;以及 nvcc 12.9 必须配 GCC 14,用 GCC 15 会因为 unsupported GNU version 直接失败。
路线二:NInfer 单卡 V100,K=1 的 218.98 tok/s 是怎么来的
第二条路线换引擎:geoffwatts/ninfer-v100 是 NInfer 的 V100 移植主线,267 星,Apache-2.0 协议。它不是从零写 CUDA,而是把 NInfer 移植到 Volta 上,跑的是 Qwen3.8-27B NVFP4(注意:不是 Bonsai)。
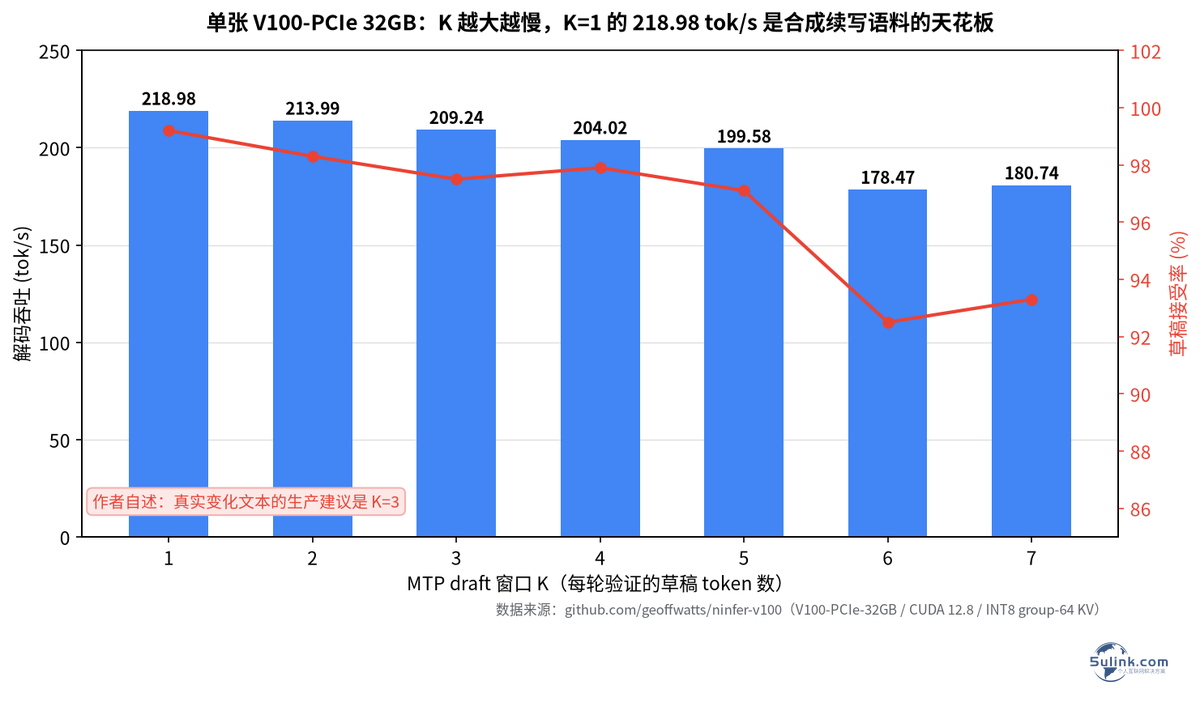
它的公开数据给了完整的 K 值扫描。硬件是 V100-PCIe-32GB,CUDA 12.8,INT8 group-64 KV:
| K(草稿 token 数) | Prefill (tok/s) | Decode (tok/s) | 草稿接受率 |
|---|---|---|---|
| 1 | 1,102.5 | 218.98 | 99.2% |
| 2 | 1,097.4 | 213.99 | 98.3% |
| 3 | 1,094.9 | 209.24 | 97.5% |
| 4 | 1,096.6 | 204.02 | 97.9% |
| 5 | 1,100.3 | 199.58 | 97.1% |
| 6 | 1,089.6 | 178.47 | 92.5% |
| 7 | 1,087.2 | 180.74 | 93.3% |
这张表最值得读的是它同时给出了接受率 —— 接受率从 K=1 的 99.2% 一路掉到 K=6 的 92.5%,decode 速度也跟着从 218.98 掉到 178.47。MTP 的吞吐不等于每秒完整模型前向,它是你每轮验证能”白赚”多少 token 的结果。
作者对 K=1 这个亮眼数字做了自我标注:这个测试用的是「确定性续写」语料,接受率异常地贴近天花板,窄窗口因此完胜;这是合成语料的天花板,不是通用生成速率,真实变化文本的生产建议是 K=3(209.24 tok/s)。另外同一份 README 里也提到,172 token 的逐字复制 prompt 能触发一条快速路径,跑出 201.0 tok/s、平均每轮 12.91 个输出 token —— 那是上下文复现的特例,不能当成常态。
还有两个物理层细节决定了这张卡的天花板:
其一,Volta 上 NVFP4 是软件模拟的。没有原生 FP8/NVFP4 计算单元,解码路径靠调优过的 FP16 tensor-core 和 SIMT kernel 撑起来,权重在加载时预打包成 QPN 布局(借鉴 v100-skinny)。其二,作者明说 SXM2 版比 PCIe 版快约 7%,但 decode 是 HBM 带宽瓶颈,PCIe 链路和主机性能影响很小。
想看更「接地气」的版本可以看 JimmyMax/ninfer-v100(13 星)。它同样面向 V100-32GB,用 orcarouter NVFP4 v3(21.2GiB)实测:1024 token 提示下 TTFT 0.95 秒、prefill 1,079 tok/s、MTP4 decode 78.1 tok/s(接受率 50.3%),关掉 drafter 只有 34.4 tok/s。同一张卡上跑 27000 token 的长提示,prefill 980 tok/s、decode 仍是 78.1 tok/s。
这份 README 里最硬的一条技术指标是 Volta QPN:把 projection 的路由带宽从 85 GB/s 拉到 480–620 GB/s。另有 GDN prefill 在递归 kernel 上做到 2.9–3.3× 提速,27K 的 prefill 从 3.75 秒压到 2.18 秒。
对比一下数量级就很清楚:同一张 V100 上,K=1 的 218.98 与另一套 NInfer 分支测出的 MTP4 78.1 差了将近三倍 —— 这不是「谁更强」的问题,是接受率和测试语料形状的问题。
路线三:多卡 V100,双卡不一定比单卡快
第三条路线是多卡。tuxKOH/ninfer-v100xN(114 星)提供了带 Linux SM70 预编译包和 Docker 镜像的完整方案。
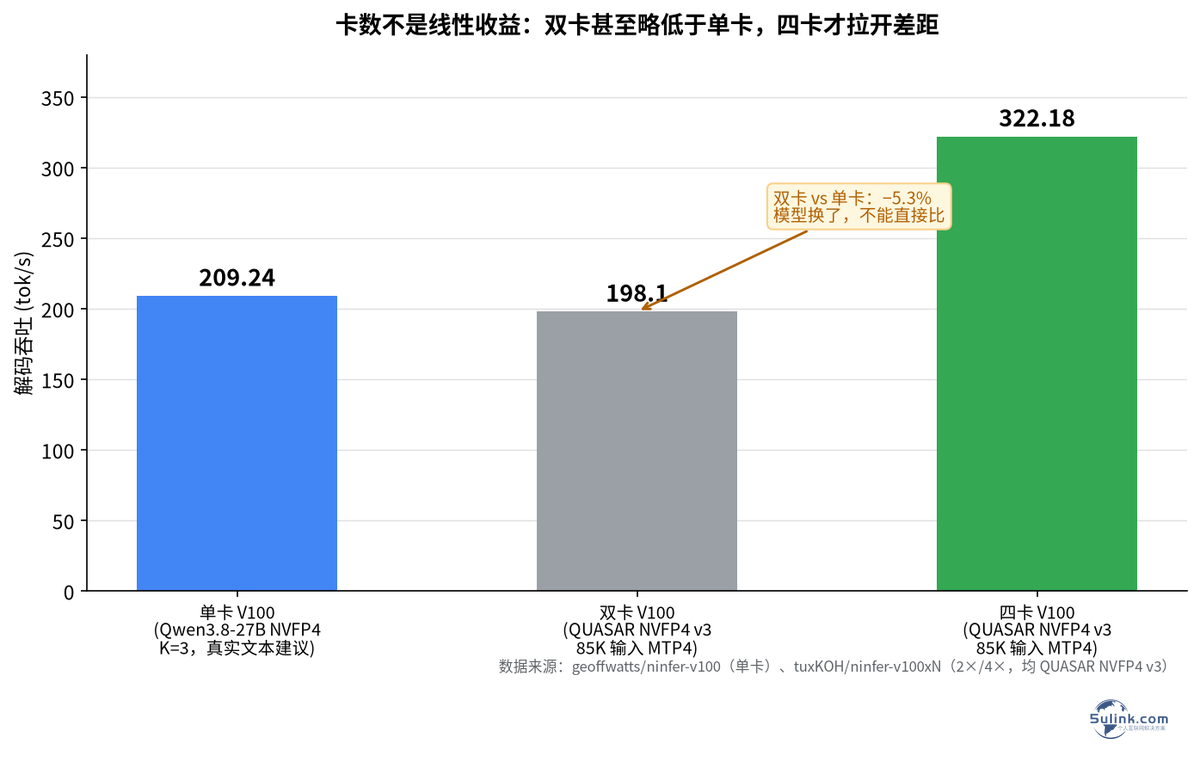
它的核心对比很反直觉:在 2×V100 16GB PCIe P2P(无 NVLink)、85K 输入、TP2、MTP4、INT8 KV 的配置下,新版实现跑出 198.10 tok/s,而同一配置(双卡)上旧实现只有 143.46 tok/s,提升 38.1%。但把这个数字和路线二的单卡 209.24 tok/s(甚至 218.98)放在一起就会发现:双卡并没有比单卡快,甚至略低。
README 自己把话说得很清楚:这组 198.10 tok/s 来自 TP2 + MTP4、85K 输入、无 NVLink 的 PCIe P2P 路径,而且「吞吐取决于任务和草稿接受率,这不是通用的 200 tok/s 结果」;在 300W 四卡主机上同口径的 TP2 对照是 199.23 tok/s,作者特别注明「这改变了并行宽度,不是等输出或隔离的软件对比」。换句话说,双卡这一档和单卡那一档本来就不是同一条路径,把 198.10 摆在 209.24 旁边只能说明「双卡不等于更快」,不能说明多卡没有价值。
真正拉开差距的是四卡 + NVLink:
| 配置 | 主机功耗 | 输入 | Prefill (tok/s) | Decode (tok/s) |
|---|---|---|---|---|
| 4×V100 NVLink (TP4) | 300 W | 85K | 2,731.60 | 322.18 |
| 4×V100 NVLink (TP4) | 220 W | 85K | 2,334.73 | 283.242 |
| 2×V100 PCIe P2P (TP2) | — | 85K | — | 198.10 |
注意 300W 主机和 220W 主机的差距 —— 作者明确说明这是新主机的功耗差异,不是纯软件收益。
多卡路线真正的杀手锏是并发。单请求 322.18 tok/s 不够看,因为这套部署是为多用户服务的。v0.2.1 用 2K 编码任务、每请求 512 输出 token 测了一组并发矩阵(committed decode tok/s,不含 prefill):
| 配置 | C1 | C2 | C4 | C8 |
|---|---|---|---|---|
| 4×V100 16GB NVLink TP4 | 312.1 | 436.6 | 702.0 | 1,083.4 |
| 2×V100 16GB NVLink TP2 | 223.5 | 312.4 | 471.4 | 677.9 |
| 2×V100 16GB PCIe P2P(无 NVLink) | 220.8 | 297.2 | 436.0 | 603.9 |
C8 的草稿接受率是 74.4%(TP4)和 76.4%(两条 TP2)。但这里也有个陷阱:作者同时给出了 85K 输入下的同一组并发数 —— TP4 只有 317.8 tok/s、TP2 NVLink 200.3 tok/s、PCIe TP2 198.2 tok/s,实际平均批大小只有约 1.23。因为 180K 共享 KV 装不下 8 个 85K 请求,C8 名义上是 8 路,实际只跑起 1.2 路。看到并发数字,先看输入长度。
这条路线推荐的模型是 QUASAR NVFP4 v3(Qwen3.8-27B),不是 Bonsai。
社区另一份双卡实现 plus1998/Ninfer-V100-Duo(41 星)补了长上下文的衰减曲线,2×V100-SXM2 16GB 带 NVLink、TP2、MTP3、官方 Qwen3.8-27B NVFP4:
| 输入占用 | 首 token | Prefill (tok/s) | Decode (tok/s) |
|---|---|---|---|
| 30,000 | 16.108 s | 1,862.5 | 118.5 |
| 100,000 | 73.125 s | 1,367.6 | 91.9 |
| 150,000 | 132.261 s | 1,134.2 | 78.0 |
它还测了 Agent 场景的首 token:Pi(1,296 token 输入)0.675 秒、Codex(11,689 token)5.735 秒、Claude Code(16,362 token)8.208 秒 —— 对做本地 Agent 的人,这组数比 tok/s 更实用。
速度对比表:先看口径,再看数字
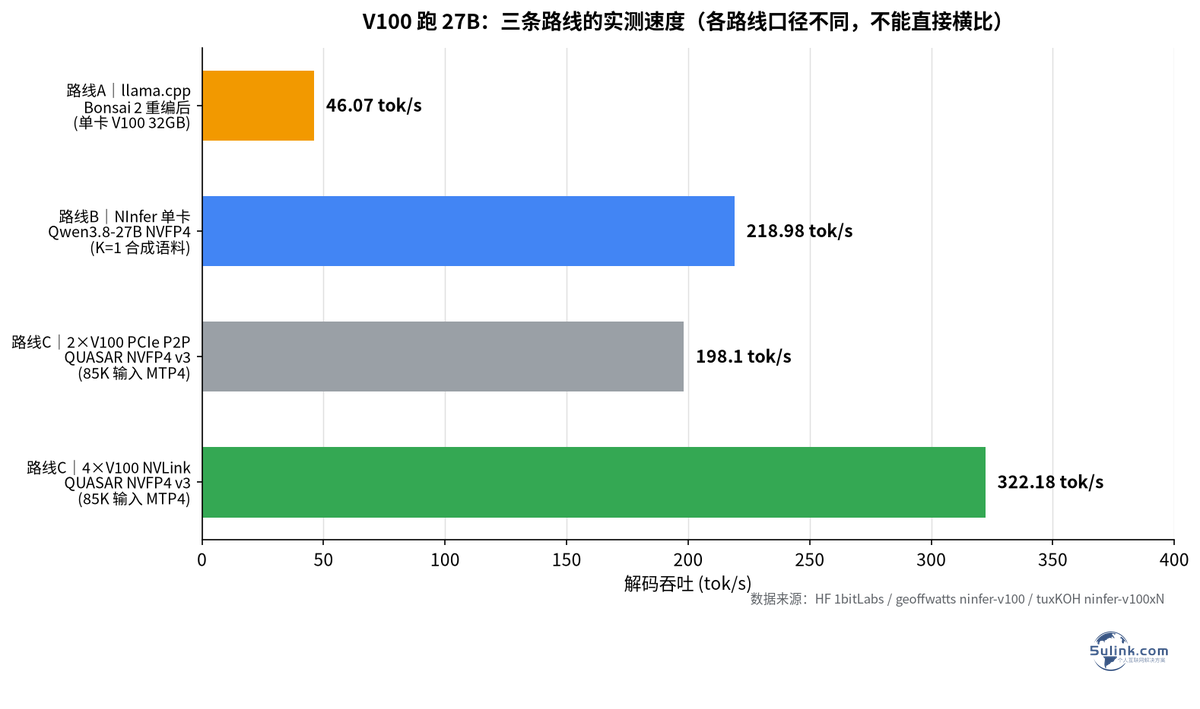
把三条路线的公开数字汇总如下。这张表不能横比,每一行的引擎、模型、量化、上下文长度和测量方式都不同:
| 路线 | 引擎 | 模型 / 量化 | 卡 | 口径 | 速度 |
|---|---|---|---|---|---|
| A | llama.cpp(sm_70 重编) | Ternary Bonsai 2 27B | 1×V100 32GB | 长解码,调参基线 | ~47.55 tok/s |
| A | llama.cpp(kernel 补丁) | Ternary Bonsai 2 27B PTQ1_0 | 1×V100-SXM2 16GB | 64K 上下文 | 52.0 tok/s |
| A | llama.cpp(官方预编译) | Ternary Bonsai 2 27B | 1×V100 32GB | 长解码(sm_120 kernel) | ~13 tok/s |
| B | NInfer MTP K=1 | Qwen3.8-27B NVFP4 | 1×V100-PCIe 32GB | 合成续写语料 | 218.98 tok/s |
| B | NInfer MTP K=3 | Qwen3.8-27B NVFP4 | 1×V100-PCIe 32GB | 同上,作者推荐的真实文本档 | 209.24 tok/s |
| B | NInfer MTP4 | orcarouter NVFP4 v3 | 1×V100 32GB | 1024 token 提示,接受率 50.3% | 78.1 tok/s |
| C | NInfer TP2/MTP4 | QUASAR NVFP4 v3 | 2×V100 16GB PCIe P2P | 85K 输入 | 198.10 tok/s |
| C | NInfer TP4/MTP4 | QUASAR NVFP4 v3 | 4×V100 NVLink | 85K 输入,300W 主机 | 322.18 tok/s |
| C | NInfer TP4/MTP4 | QUASAR NVFP4 v3 | 4×V100 NVLink | 2K 任务,8 路并发 | 1,083.4 tok/s |
| D | NInfer-all | Ternary Bonsai 2 27B | 1×V100-SXM2 16GB | 短对话,无投机 | 73.2 tok/s |
| D | NInfer-all | Ternary Bonsai 2 27B | 1×V100-SXM2 16GB | 短对话,MTP3 | 123.1 tok/s |
把三者合起来:Bonsai + NInfer + V100 有数据了,但不在上游主线
一个常见误解是「Bonsai 走 llama.cpp,NInfer 走 Qwen,所以 V100 上跑 Bonsai 只能用 llama.cpp」。NInfer 上游主线的模型表里确实没有 Bonsai —— geoffwatts/ninfer-v100 官方支持的是 Qwen3.6-27B、Qwen3.8-27B 和 Qwen3.6-35B-A3B。
但能把三者拼起来的是社区聚合项目 iamwavecut/ninfer-all(215 星),它把 GGUF block format、Ternary Bonsai 2、MTP、DFlash2 和多种量化 KV 整合进一个构建,并且为 Turing/Volta 替换本卡不支持的指令、按共享内存重塑 kernel。它自己有一份完整的 《Tesla V100 measurements, October 2026》 文档,在 V100-SXM2-16GB(300W、80 SM、1,530 MHz、HBM2 877MHz)上的实测是:
| 配置 | 短对话 | 1,024 | 8,192 | 32,768 | 131,072 |
|---|---|---|---|---|---|
| 无投机(11.8 GiB) | 73.2 | 73.0 | 71.8 | 67.2 | 54.6 |
| MTP 3 drafts(12.7 GiB) | 123.1 | 100.1 | 118.7 | 87.4 | 60.0 |
| DFlash2 5 drafts(13.5 GiB) | 116.1 | 100.9 | 88.0 | 91.1 | 45.0 |
引擎层(ninfer_bench)的单请求数字是 tg128 73.6 tok/s、16K 提示后 66.7 tok/s;同一张卡上 llama.cpp 跑 Qwen3.8-27B IQ3_S 只有 tg128 36.6 tok/s。这份文档还给了一张 V100 对 RTX 3090 的对照表:Bonsai 2 短对话无投机 73.2 vs 93.8(比值 0.78),MTP3 是 123.1 vs 173.4(0.71),DFlash2 是 116.1 vs 200.8(0.58),八路并发 283.5 vs 546.4(0.52)。两张卡读内存的速度差不多(900 vs 936 GB/s),差距主要来自 Volta 只能在 CUDA core 上做整数乘法、宽矩阵必须先反量化到 FP16。
讨论区 #81 里还有一位同样在折腾 V100 的用户(他推荐的正是 iamwavecut/ninfer-all),也给出了自己的 V100-SXM2-16GB 配置:Ternary Bonsai 2 27B 用原生 .ninfer 格式、量化 KV(rk4v4)、MTP + DFlash2 + n-gram 推测解码,短上下文 145.6 tok/s、25K 上下文 78.7 tok/s、60K 上下文 54.8 tok/s,原生 262,144 token 上下文,用 YaRN 试到约 300K、Agent 探针 4/4 通过到 297,921 token。他自己也写了一句:该结果与 PTQ1_0 的 llama.cpp 结果不可直接比较,因为引擎、量化格式和解码方法都不同。
需要提醒的是,Bonsai + NInfer 组合最响亮的那些数字并不来自 V100。社区有人把 NInfer 移植到 Windows + RTX 4090(sm_89)上跑 Ternary Bonsai 2 27B,帖标题给出 167–210 tok/s(MTP 投机解码均值 167 tok/s,代码类 prompt 上最高 187 tok/s;不开投机 101 tok/s,prefill 3,061 tok/s),并称困惑度与参照实现一致。这是 4090 的成绩,不能套到 V100 上。
所以更准确的结论是:三者组合已经有公开实测数据了,但 V100 这一档的数据来自社区聚合版而不是 NInfer 上游主线,且这一档的公开样本量远小于 Qwen 那一档。
硬件底子:为什么这些数字都卡在这条线上
V100 是 SM70,16GB / 32GB HBM2,文档里实测流式读能到 856 GB/s(与 RTX 3090 的 936 GB/s 同一量级)。它没有原生 FP8/NVFP4 计算单元 —— 所有 NVFP4 路径都是软件模拟。这意味着:
- – 每一档量化收益都要靠 kernel 工程和权重预打包硬挖出来(NInfer-all 的 QPN 就是典型例子:projection 从 85 拉到 480–620 GB/s);
- – 投机解码的接受率成为最终吞吐的真正决定因素(K=1 的 99.2% 和 JimmyMax 那档的 50.3%,差距就是 3 倍);
- – 卡与卡之间的差距在长上下文和高并发下被放大,因为那正是带宽和通信最吃紧的地方。
小夏点评
一、这张表最大的价值是「提醒你别横比」。 同一个 27B、同一张 V100,能搜出 ~13 到 1,083.4 tok/s 的数字,每一个都是真的,但它们测的根本不是同一件事:引擎不同、模型不同、量化格式不同、上下文长度不同、输入语料不同、有没有投机解码也不同。真正该记住的三个数是:官方预编译包的 13(坑)、K=3 的 209.24(生产建议)、四卡 NVLink 的 322.18(规模上限)。
二、如果你手里有一张退役 V100,先做的不是找最快的引擎,而是先确认你下的是不是官方那个编译包。 sm_120 kernel 在 Volta 上跑出 13 tok/s,比同卡 Q4 的 33 还慢 —— 这是纯粹的架构不匹配,重编一次就变成 46。同理,CUDA 13 已经砍掉 sm_70 离线编译,GCC 版本不对会让 nvcc 直接失败。这些坑的共同点是:它们跟模型无关,跟优化无关,只跟你的工具链对不对有关,但踩上去会让人误以为「V100 就是不行」。
三、给国内 IT 运维和开发者的实际启示是:不要用「tok/s 单值」做老卡改造的决策依据,要用「单位时间能服务多少真实请求」。 多卡 V100 单请求 322.18 tok/s 看着平淡,但八路并发时是 1,083.4 tok/s 的 committed decode;而同样两张卡,85K 长输入下实际平均批大小只有 1.23 路 —— 承诺的并发根本跑不起来。对绝大多数企业内部场景(代码补全、内部问答、RAG 摘要),瓶颈永远是首 token 延迟和并发数,不是单请求峰值:Claude Code 那种 16,362 token 输入,首 token 8.208 秒,这个数字比任何 tok/s 都更能决定体验。老卡的正确用法是按并发和首 token 延迟去反推容量,而不是按峰值速度去吹吞吐。
参考链接
- – Hugging Face — 1bitLabs/PrismML-Bonsai2-27B-V100-CUDA(V100 CUDA 构建与诚实测速表)
- – Hugging Face — prism-ml/Ternary-Bonsai-2-27B-gguf 讨论区 #81(V100-16GB 64K 上下文 52.0 tok/s 实测与后续回复)
- – GitHub — geoffwatts/ninfer-v100(NInfer V100 主线,K 值扫描与 NVFP4 软件模拟说明)
- – GitHub — JimmyMax/ninfer-v100(Volta QPN、GDN prefill 与 MTP4 实测)
- – GitHub — tuxKOH/ninfer-v100xN(多卡 TP2/TP4、并发矩阵与 SM70 预编译包)
- – GitHub — plus1998/Ninfer-V100-Duo(双卡长上下文衰减与 Agent 首 token)
- – GitHub — iamwavecut/ninfer-all(Bonsai 2 + MTP + DFlash2 多架构聚合版)
- – GitHub — Tesla V100 measurements, October 2026(ninfer-all 的 V100 完整实测文档)
- – Reddit r/LocalLLM — 单张 PCIe V100 32GB 的 218 tok/s 社区实测帖
- – Reddit r/LocalLLM — NInfer + Ternary Bonsai 2 27B 社区实测帖(帖标题给出 167–210 tok/s)