TurboQuant:让低比特 KV cache 量化第一次「人人可用」?
TurboQuant:让低比特 KV cache 量化第一次「人人可用」?
摘要: 论文躺了近一年,一篇博客加一场 ICLR 就火了。Google 联合 NYU 把 KV cache 压到 2.5–3.5 比特:免校准、在线量化,显存至少省 6 倍,H100 上注意力计算最高快 8 倍——llama.cpp 和 vLLM 的社区实现已经在路上。
一篇「养老」论文,为什么突然火了
KV cache(键值缓存)是大模型推理里最会「长胖」的东西:模型权重是固定的,加载一次就趴在那不动,而 KV cache 会随着上下文长度线性膨胀。长上下文场景下,它既是内存问题,也是带宽问题——很多时候决定你能同时服务多少用户、能聊多长的,不是显存够不够放模型,而是够不够放缓存。
过去两年,学术界能降 KV cache 显存的量化方法已经有上百种(GitHub 上的 Awesome-KV-Cache-Compression 收录了 100+),理论上都能给出更好的速度/显存/精度折中。但落到工程上很尴尬:主流推理引擎基本不吃这些方法。vLLM 主分支到今天只支持 8 比特 KV cache 量化(FP8 和 INT8);llama.cpp 支持若干种块式 GGML KV 量化器、最低到 4 比特,但也谈不上 KV 专属的精细优化(比如离群 token 显式跟踪、按上下文区别处理)。2026 年了,这水平只能说乏善可陈。
根源在于工程难度:把 SOTA 量化方法塞进高度优化的推理引擎,既要不能拖慢推理速度,又要兼容五花八门的模型架构、GPU 和后端——这不是发论文,是还技术债。
所以业内原作者 Benjamin Marie(The Kaitchup 主笔)总结的行业传播规律很有意思:想让一种新量化方法真正普及,通常需要大实验室发一篇方法简单、基准清晰、用途明确的新论文,再加上几个有影响力的大 V 帮腔。而 TurboQuant 正在复刻这条路径——论文 2025 年 4 月底就挂上了 arXiv,躺了将近一年,直到 Google 在 2026 年 3 月 24 日给它配了一篇通俗易懂的官方博客,紧接着入选 ICLR 2026(明年在里约热内卢办),社区才开始动。评论区有句话扎心又好笑:「有意思,一个想法居然要靠博客才带得起来。」
TurboQuant 到底怎么干活
先给一句话版本:给每个 K/V 向量做一次固定的随机旋转,然后用一套预先算好的码本逐坐标量化,重建时查码本、逆旋转还原。 训练免费、校准免费,专为「边生成边写缓存」的在线场景设计。
拆开看,Google 官方博客把它总结成两步(对应两篇前置论文 PolarQuant 和 QJL):
- 压缩主力(PolarQuant 阶段):先对数据向量做随机旋转。这一步的精妙之处在于几何变换——高维单位向量旋转后,各坐标的分布会变得高度集中、近似独立、约等于服从高斯/贝塔分布(论文原话:坐标被「浓缩」进一个可解析预测的分布)。分布一规整,一套固定的标量码本就能通吃所有 KV 向量,不需要校准数据、不需要逐模型拟合,传统矢量量化每块数据要额外存 1–2 比特的量化常数这个「内存税」也顺手免了。
- 消除隐性误差(QJL 阶段,可选):均方误差最优的量化在估计内积时仍然有偏,而注意力分数恰恰就是靠内积算的。于是 TurboQuant 再花 1 比特,对第一阶段的残差做一个 QJL 草图(Johnson-Lindenstrauss 变换后每个坐标只留正负号),把内积估计的偏差抹平。
对应到论文里,整套方法分两个档位:
- TurboQuant_mse(论文算法 1):只有第一阶段,随机旋转 + Lloyd-Max 标量量化。对 KV cache 场景最实用,也是社区实现基本收敛出的「落地起点」。
- TurboQuant_prod(完整方法):MSE 量化 + 1 比特 QJL 残差草图,面向内积保真,适合连注意力核函数一起重写的场景。
还有一个容易被标题党的小细节:宣传里常说的「2.5 比特」并不是真存在半比特这种数据类型,而是混合精度——论文举的例子是 head 维度 128 时,32 个离群通道给 3 比特、96 个常规通道给 2 比特,平均摊下来 2.5 比特/通道。3.5 比特档同理。
至于 QJL 该不该用,社区已经用脚投票。多篇独立实现不约而同得出一致结论:作为「即插即用」的缓存格式,起步就应该只用 MSE 阶段——一个独立的 Triton 实现报告说,把 QJL 校正直接加回重建向量反而把质量打得很难看,切回 MSE 变体立刻恢复正常;llama.cpp 讨论区里开发者在 Qwen3-1.7B 上做对照实验,同样发现「同预算下纯 MSE 优于 MSE+1 比特 QJL」。1 比特残差草图更适合你掌握注意力核函数、能直接消费「量化值 + 符号位」两段式表示的时候再上。
论文自家成绩单:接近无损,但口径要看清
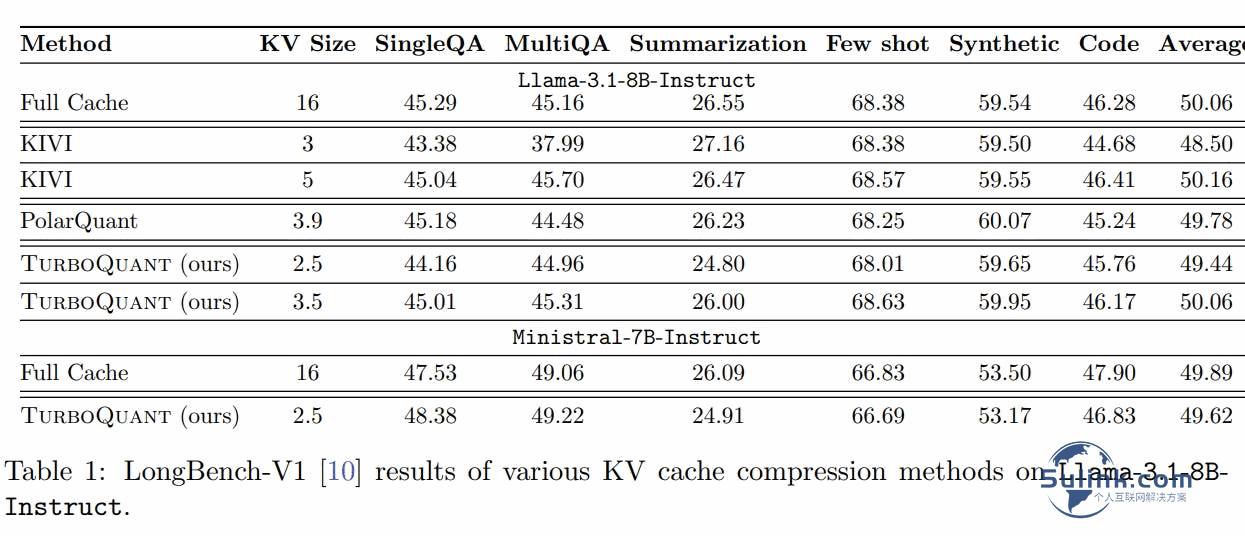
论文摘要里的官方口径:KV cache 量化在 3.5 比特/通道时做到完全无损,2.5 比特/通道时只有轻微退化;理论上限方面,它的失真率与信息论下界只差一个约 2.7 的常数因子——这是「near-optimal」这个命名的底气。下面是论文 Table 1(LongBench-V1,llama.cpp 讨论区置顶的就是这张表):
| 方法 | KV 位宽 | SingleQA | MultiQA | Summarization | Few shot | Synthetic | Code | 平均 |
|---|---|---|---|---|---|---|---|---|
| Llama-3.1-8B-Instruct | ||||||||
| Full Cache | 16 | 45.29 | 45.16 | 26.55 | 68.38 | 59.54 | 46.28 | 50.06 |
| KIVI | 3 | 43.38 | 37.99 | 27.16 | 68.38 | 59.50 | 44.68 | 48.50 |
| KIVI | 5 | 45.04 | 45.70 | 26.47 | 68.57 | 59.55 | 46.41 | 50.16 |
| PolarQuant | 3.9 | 45.18 | 44.48 | 26.23 | 68.25 | 60.07 | 45.24 | 49.78 |
| TurboQuant(ours) | 2.5 | 44.16 | 44.96 | 24.80 | 68.01 | 59.65 | 45.76 | 49.44 |
| TurboQuant(ours) | 3.5 | 45.31 | 45.31 | 26.00 | 68.63 | 59.95 | 46.17 | 50.06 |
| Ministral-7B-Instruct | ||||||||
| Full Cache | 16 | 47.53 | 49.06 | 26.09 | 66.83 | 53.50 | 47.90 | 49.89 |
| TurboQuant(ours) | 2.5 | 48.38 | 49.22 | 24.91 | 66.69 | 53.17 | 46.83 | 49.62 |
几个务实读数:
- 3.5 比特档确实做到了「平均不降分」:Llama 上 50.06 对满精度 50.06,教科书级「无损」。
- 2.5 比特是「轻微退化」而非零:Llama 平均掉 0.62 分(49.44 对 50.06),主要丢在 Summarization(-1.75)。Google 博客说的「zero measurable accuracy loss」,指的是针找草堆(needle-in-a-haystack)检索任务全部满分——那是简单任务,别把两个口径混着看。
- 3 比特 KIVI 被 2.5 比特的 TurboQuant 在平均上压了一头,这才是论文的卖点:更低的位宽,接近满血的分数。
评测仍是「进行时」:这份成绩单回答不了最重要的问题
Benjamin 对论文评测的三点批评,值得所有打算跟进的团队记住:
- 只考「长上下文记忆题」。评测集中在 LongBench 和 Needle-in-a-Haystack。这类基准能证明压缩没让模型忘掉提示词里的信息,但题目相对简单,回答不了那个更关键的问题:模型的综合能力还在不在?
- 只考了老模型。评测用的是 Ministral 和 Llama 3.1 8B,都是上一个周期的模型。新架构——比如混合注意力(Qwen3.5 这类只有一部分层是全注意力)——表现如何,没人知道。
- 基线也老。新版方法基本缺席,比如 NeurIPS 2025 上那一大批新方法,一个都没进对比表。
能确定的是:它比朴素量化好,而且实现简单——对推动推理框架升级 KV cache 量化来说,这两点就足够重要了。
对服务化部署来说,TurboQuant 真正的吸引力在在线、免校准:不需要为缓存训练逐模型码本,不需要跑离线拟合,来一条 KV 向量就能量化一条。这让它和一堆「离线评测漂亮、在线写入别扭」的方法划清了界线。
另一个提醒:光省显存没用,还得有匹配的核函数。 Google 官方博客给出的数字是 KV 显存至少降 6 倍,优化配置下 4 比特 TurboQuant 在 H100 上算注意力 logits 相对未量化 32 比特键最高提速 8 倍(对比的是高度优化的 JAX 基线);Gemma、Mistral 上运行时间还更快。但这些是实验室口径——真到主流引擎里,没有对应 kernel,省下的显存未必换得来吞吐。
生态赛跑:llama.cpp 先跑,vLLM 在路上
原作者跑了一圈社区实现,情况是「人多、手快、都没合并」:
| 方向 | 现状 | 关键数据 |
|---|---|---|
| llama.cpp 上游 | TurboQuant 支持的功能请求已开(issue #20977),讨论区原型实现「看起来能跑」 | 讨论帖 189 个赞,183 条回复 |
| ik_llama.cpp | 独立实现报告逐向量 MSE 对上了论文 3/4 比特口径,规划了两条路:稳妥的先反量化再算注意力,未来做融合注意力 | 49 项测试、失真与论文偏差 ±15% 以内的独立复现也在讨论区 |
| turboquant_plus | llama.cpp/Metal 接入 Apple Silicon,新增 turbo3/turbo4 两种 KV 缓存格式,端到端服务可用 | prefill 吞吐约与 q8_0 持平,KV cache 压缩约 4.6 倍 |
| vLLM | 尚无成熟支持,有一个描述 KV cache 集成的公开功能请求(issue #38171),更新频繁 | 原作者承诺等稳定后跑大规模评测 |
| web-llm | 也有开发者开了功能请求 issue #799,盼接入 WebGPU 管线 | 引用口径同样是「显存 6 倍、H100 最高 8 倍」 |
需要泼冷水的对照:Red Hat AI 团队 2026 年 5 月在 vLLM 官方博客发了首份 TurboQuant 系统性评测,结论是 FP8 仍是最优默认项——TurboQuant k8v4 相对 FP8 没有实质优势,4bit-nc 变体适合显存压力大的场景但吞吐和延迟要倒贴;Reddit 上的用户实测则两极分化。论文的数学是漂亮的,社区的态度则是「理论已定,生产故事还没写出来」。
小夏点评
- TurboQuant 的火,本质是「简单」的火。 随机旋转 + 查表量化,一页纸讲得清、不需要校准、不动模型结构——对工程团队来说,「能被 kernel 实现」比「理论最优」值钱得多。这解释了为什么躺了一年的论文,靠 Google 一篇博客就能起飞。
- 对普通卡用户,这是实打实的红利。 长上下文时代 KV cache 就是显存第一大客户,2.5–3.5 比特意味着同样的卡能塞下两三倍的上下文,或者腾出显存给权重和并发——llama.cpp 生态先把它做出来,最受益的恰恰是 24GB 以下消费级显卡的本地推理用户。
- 对国内 IT 运维和开发者的启示: 别急着在生产上换。当前正确姿势是——默认继续用 FP8/INT8 量化,盯住 vLLM 和 llama.cpp 把 TurboQuant kernel 合入主干、等第一轮大规模公开评测(尤其是新架构模型上的)出来再动;同时把「KV cache 位宽」正式纳入推理容量规划表格——显存省 6 倍意味着同样的硬件能服务的并发翻倍以上,这会直接改写你们集群的采购和成本模型。
参考链接
- 原文:The Kaitchup – AI on a Budget,《TurboQuant: Finally, Fast and Widely Available Low-Bit KV Cache Quantization?》(The Weekly Kaitchup #135, Benjamin Marie, 2026-03-27)https://kaitchup.substack.com/p/turboquant-finally-fast-and-widely
- Google Research 官方博客(2026-03-24):https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
- 论文 TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate(arXiv:2504.19874,ICLR 2026):https://arxiv.org/abs/2504.19874
- QJL 论文(arXiv:2406.03482):https://arxiv.org/abs/2406.03482
- PolarQuant 论文(arXiv:2502.02617,AISTATS 2026):https://arxiv.org/abs/2502.02617
- llama.cpp 讨论区 TurboQuant 专区(#20969):https://github.com/ggml-org/llama.cpp/discussions/20969
- llama.cpp 上游功能请求(#20977):https://github.com/ggml-org/llama.cpp/issues/20977
- ik_llama.cpp 独立实现报告(#1509):https://github.com/ikawrakow/ik_llama.cpp/issues/1509
- turboquant_plus 项目:https://github.com/TheTom/turboquant_plus
- vLLM 功能请求(#38171):https://github.com/vllm-project/vllm/issues/38171
- WebLLM 功能请求(#799):https://github.com/mlc-ai/web-llm/issues/799
- 独立 Triton 实现博客:https://dejan.ai/blog/turboquant/
- Awesome-KV-Cache-Compression 方法大全:https://github.com/October2001/Awesome-KV-Cache-Compression