3卡V100推理实战:6款主流小模型性能横评
摘要:3卡V100能否承载中小规模LLM推理业务?实测Gemma-3、Qwen2.5、DeepSeek-R1等6款主流小模型,50和100并发下吞吐量、延迟全对比,附赠Tensor Parallel和Pipeline Parallel选择指南。
为什么关注3卡V100
相比8卡V100集群,3卡V100是一个更务实的配置——成本更低、功耗更友好,适合中小团队的业务探索或预生产环境。问题在于:3卡V100能跑多快?不同模型表现差异有多大?
本文带来一份详实的实测报告,测试环境为3×V100-16GB HBM2,使用vLLM作为推理引擎,涵盖6款主流小模型。
测试环境与配置
硬件规格
| 组件 | 规格 |
|---|---|
| GPU | NVIDIA V100 × 3 |
| 架构 | Volta |
| 计算能力 | 7.0 |
| CUDA核心 | 5120 |
| Tensor核心 | 640 |
| 显存 | 16GB HBM2 |
| FP32性能 | 14 TFLOPS |
测试模型
- google/gemma-3-4b-it
- google/gemma-3-12b-it
- Qwen/Qwen2.5-7B-Instruct
- Qwen/Qwen2.5-14B-Instruct
- deepseek-ai/DeepSeek-R1-Distill-Llama-8B
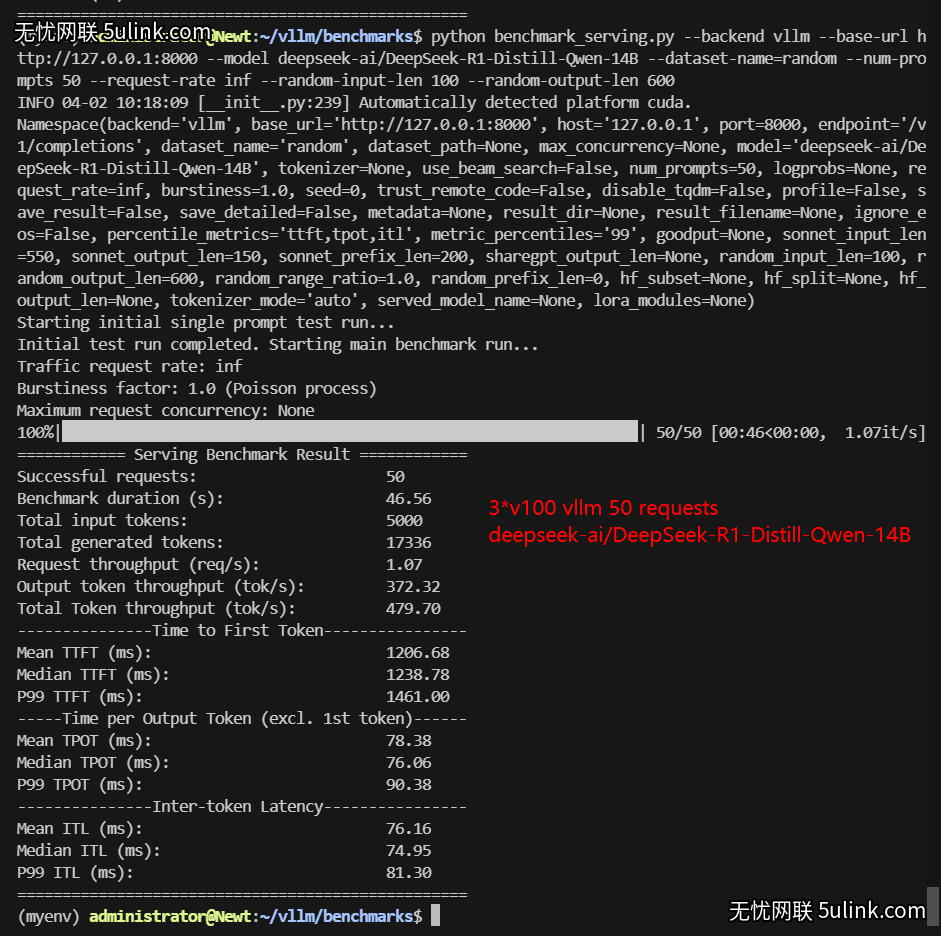
- deepseek-ai/DeepSeek-R1-Distill-Qwen-14B
关键参数
- 输入长度:100 tokens
- 输出长度:600 tokens
- 精度:Float16(V100只支持FP16)
- 并发:50 / 100 请求
并行策略:Tensor vs Pipeline
在3卡配置下,我们面临一个选择:Tensor Parallel (TP) 还是 Pipeline Parallel (PP)?
- TP=2:将模型层横向切分到2张GPU,速度更快但显存受限
- PP=3:将模型层纵向分配到3张GPU,支持更大模型但有通信开销
实测结论:能用TP就用TP,速度优势明显。
50并发:谁是效率之王
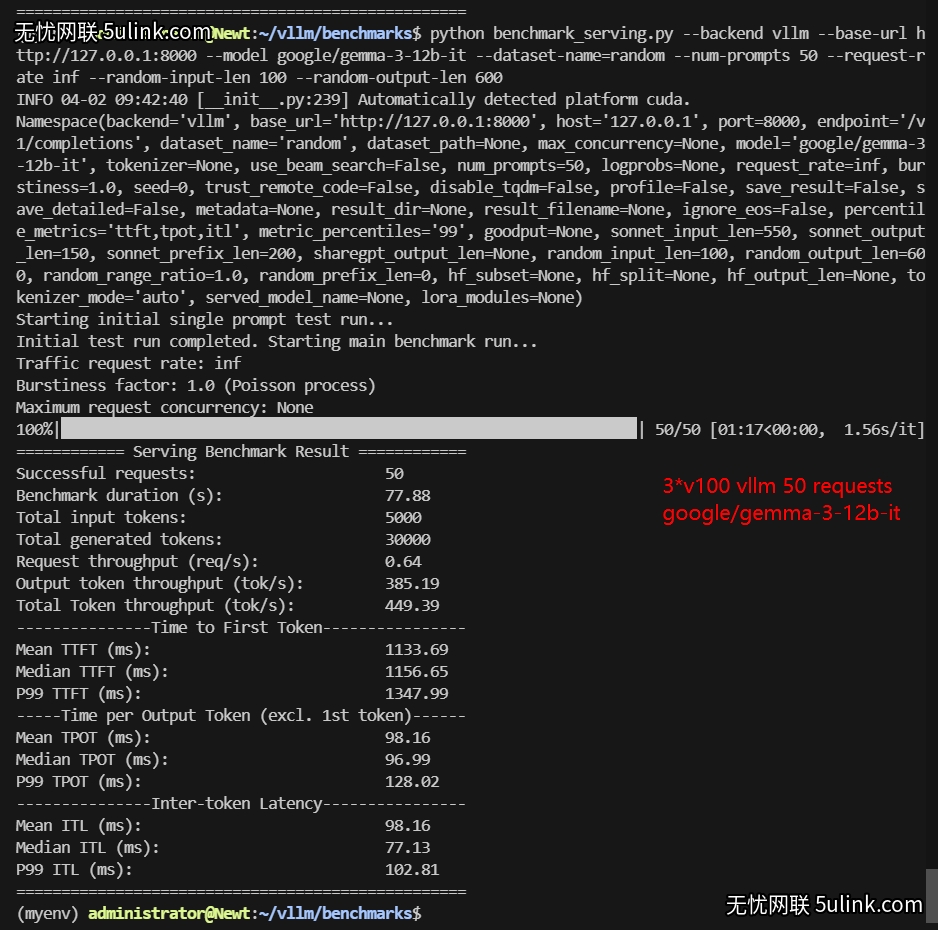
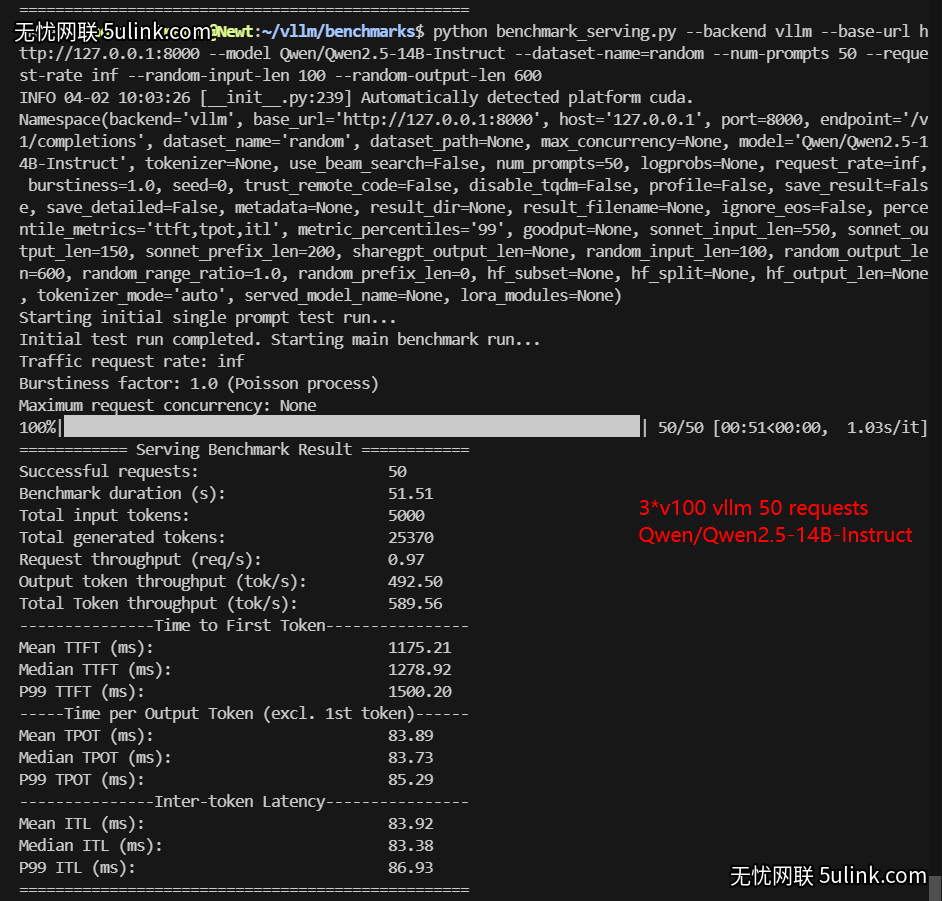
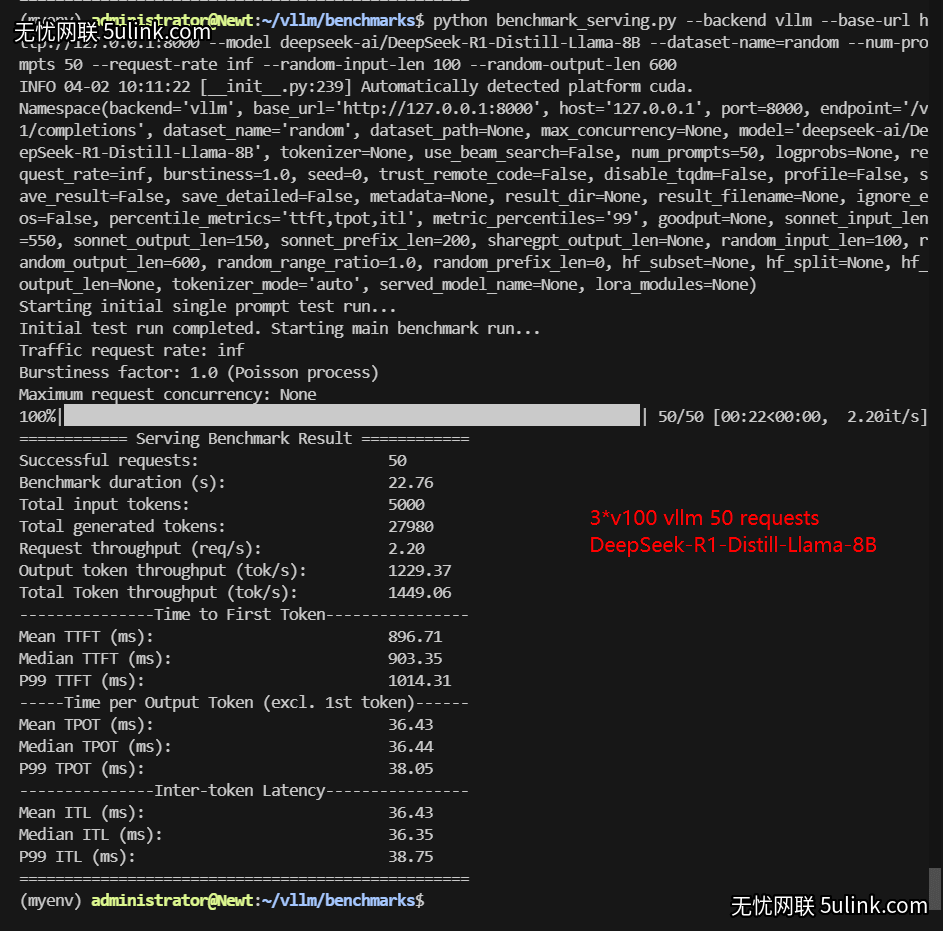
| 模型 | 部署方式 | 吞吐量(tok/s) | TTFT(中位数ms) | TPOT(中位数ms) |
|---|---|---|---|---|
| Gemma-3-4B | TP=2 | 1847 | 688 | 30 |
| Qwen2.5-7B | TP=2 | 1384 | 800 | 34 |
| DeepSeek-R1-Llama-8B | TP=2 | 1449 | 903 | 36 |
| Qwen2.5-14B | PP=3 | 589 | 1279 | 84 |
| Gemma-3-12B | PP=3 | 449 | 1157 | 97 |
| DeepSeek-R1-Qwen-14B | PP=3 | 480 | 1239 | 76 |
关键发现:
- Gemma-3-4B遥遥领先,吞吐量达到1847 tok/s,是14B模型的3倍以上
- TP配置全面胜出PP:同等条件下TP比PP快2-3倍
- 14B模型被迫用PP后,性能下降明显
50并发下的吞吐量对比
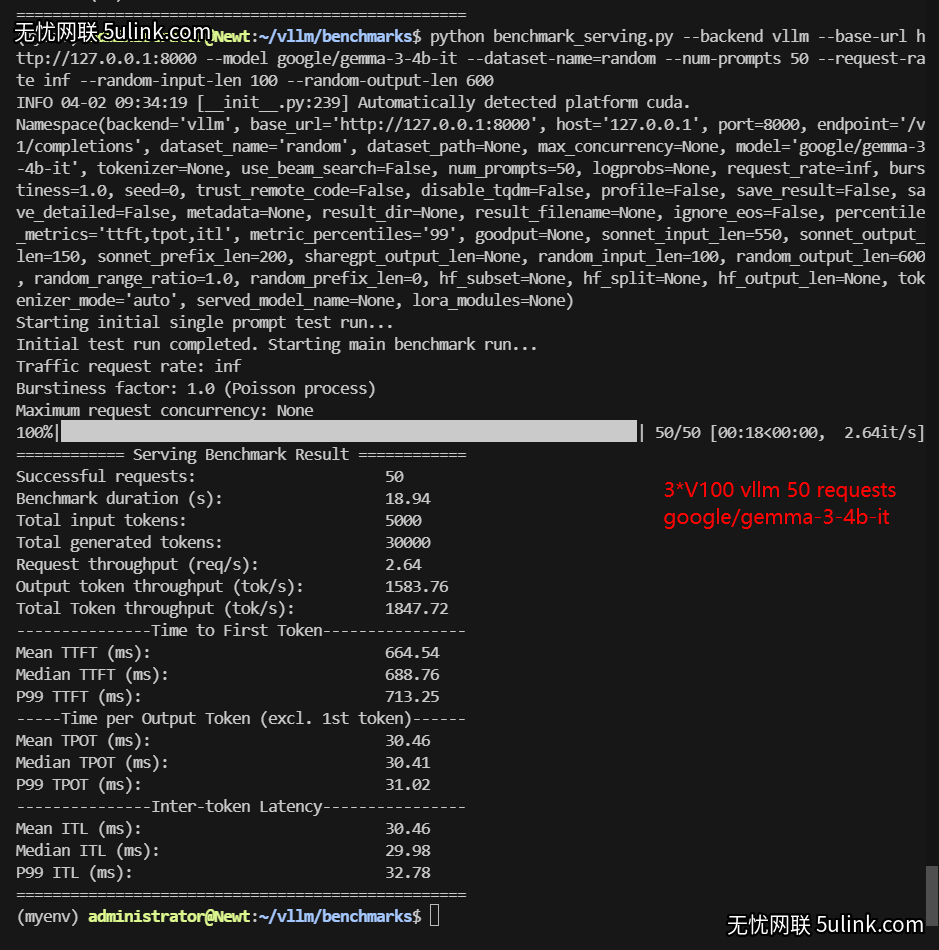
图:6款模型在50并发下的吞吐量表现(图源:Database Mart)
100并发:压力测试结果
| 模型 | 部署方式 | 吞吐量(tok/s) | TTFT(中位数ms) | 吞吐量降幅 |
|---|---|---|---|---|
| Gemma-3-4B | TP=2 | 2475 | 1167 | +34% |
| Qwen2.5-7B | TP=2 | 1782 | 1403 | +29% |
| DeepSeek-R1-Llama-8B | TP=2 | 2057 | 1427 | +42% |
| Qwen2.5-14B | PP=3 | 798 | 2224 | +35% |
| Gemma-3-12B | PP=3 | 435 | 1897 | -3% |
| DeepSeek-R1-Qwen-14B | PP=3 | 820 | 2175 | +71% |
关键发现:
- 并发翻倍后,整体吞吐量都有提升(因为更多请求可以 batching)
- Gemma-3-4B继续领跑,达到2475 tok/s
- Gemma-3-12B反而略有下降,说明大模型在100并发下开始出现瓶颈
100并发下的吞吐量对比
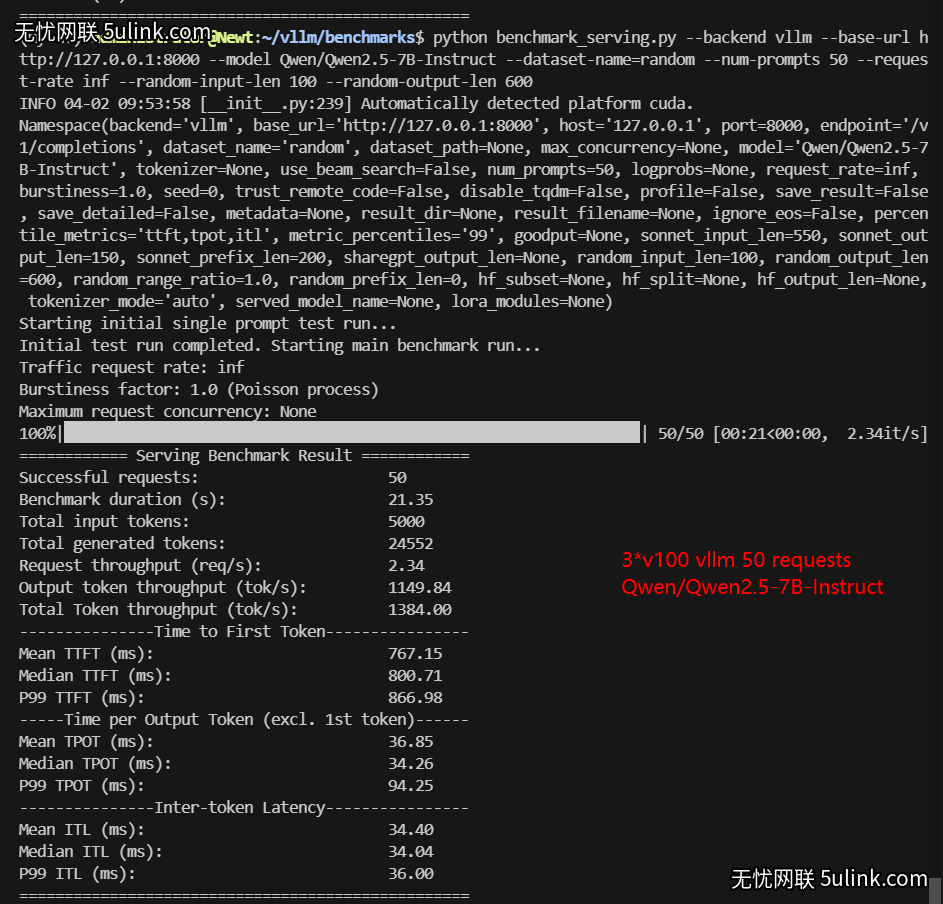
图:6款模型在100并发下的吞吐量表现(图源:Database Mart)
核心结论
1. 模型选择建议
| 场景 | 推荐模型 | 预期吞吐 |
|---|---|---|
| 追求极致性能 | Gemma-3-4B | 1800-2500 tok/s |
| 均衡之选 | Qwen2.5-7B | 1400-1800 tok/s |
| 需要更强模型能力 | DeepSeek-R1-8B | 1400-2100 tok/s |
| 需要14B级别 | Qwen2.5-14B | 600-800 tok/s |
2. 并行策略铁律
- 能用TP=2绝不用PP=3:实测TP比PP快2-3倍
- TP必须使用偶数:2、4、8,不要尝试3
- 当模型无法fit进TP=2时,再考虑PP=3
3. 精度设置
V100没有原生的BF16支持,务必使用 --dtype float16。尤其是Gemma-3系列,官方默认BF16,需要手动指定FP16才能在V100上运行。
4. 并发控制
- 50并发是甜点区:性能与延迟的平衡点
- 超过100并发后,大模型会明显变慢
- 建议根据业务SLA动态调整并发上限
小夏点评
- 3卡V100完全可用:对于7B及以下模型,3卡V100可以提供足够支撑中小业务的推理能力。Gemma-3-4B能跑到2400+ tok/s,单用户延迟仅30ms级别,体验很流畅。
- 选对模型很重要:实测同样3卡,4B和14B的吞吐量差了近4倍。如果业务不是必须用大模型,选择更小的模型能省大量成本。
- DeepSeek-R1表现亮眼:作为新兴的推理模型,DeepSeek-R1-Distill-Llama-8B在TP=2配置下跑出了接近2000 tok/s的成绩,值得关注。
- 给国内开发者的建议:如果你是中小团队,想用私有化部署降低成本,3卡V100+7B模型是一个不错的起点。GPU成本约¥3-4万(二手),对比云端API调用成本,半年到一年就能回本。
参考链接
- 原文:3×V100 vLLM Benchmark
- vLLM官方仓库:vllm-project/vllm
- 测试代码:benchmark_throughput.py