混合模型的解码瓶颈不在这次的注意力上:ReplaySSM 缓存输入而非状态,投机解码提速 2.1 倍
混合架构正在成为推理模型的主流路线:NVIDIA Nemotron 3、Qwen3.5-3.8、Kimi-K3、GLM-5.3-Flash 全部采用”SSM 层 + 少量注意力层”的交错结构。教科书都说 SSM 解码快——定长状态代替随上下文膨胀的 KV 缓存。但 NVIDIA 与普林斯顿 Dao AI Lab 的联合工作发现了一个反直觉的事实:在真实服务的 batch 规模下,SSM 层(不是注意力)才是解码延迟的大头,而且它还拖累投机解码、逼着状态用回 FP32。ReplaySSM 的答案简单到像玩笑:别缓存状态,缓存输入。论文已上 arXiv、代码开源,并且已经跑在 GLM-5.3-Flash 和 Kimi-K3 的生产环境里。
为什么 SSM 层会变成瓶颈
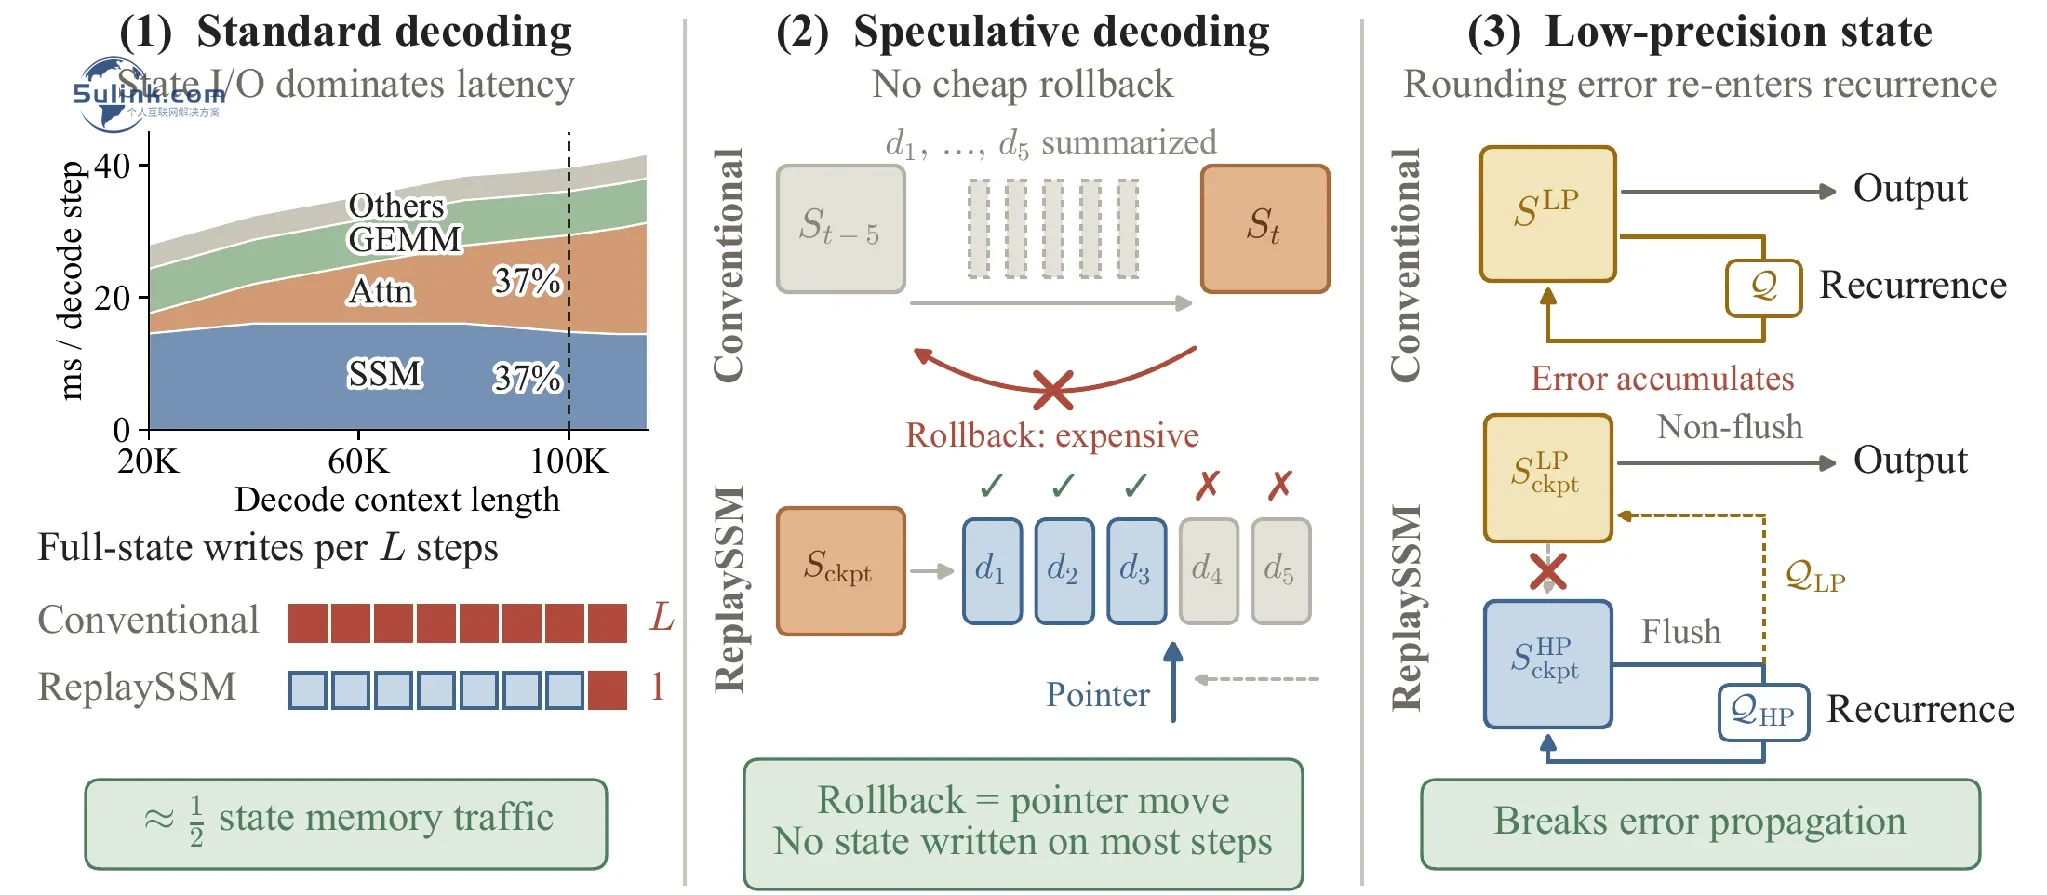
以 Nemotron 3 Ultra 的 Mamba-2 层为例:常规解码里每一步都要从 HBM 读整个状态、做很少的算术、再把状态写回去——kernel 是内存带宽受限的。两个结构性因素让这条路雪上加霜:模型里 SSM 层数量是注意力层的 5 倍;单层 FP32 状态高达 4MiB/序列(相当于一层注意力 8K token 的 KV 缓存大小)。在 B300 单卡、batch 256、Nemotron-3-Super-NVFP4 的设置下,SSM 层最高占到 10 万 token 上下文以内解码步骤的最大头。
连锁问题有两个。投机解码没法玩:注意力靠移动 KV 指针就能回滚,SSM 把草稿 token 摘要进状态后”更新没有逆运算”,vLLM 只好每个草稿 token 存一份状态快照——内存受限路径上每步 1 读 T 写,快照还吃掉显存、压低并发。量化没法做:量化状态既产生输出、又作为下一步更新的输入,舍入误差每步重新进入递归——这就是 KV 缓存能上低精度、SSM 状态不能的原因(Qwen3.5-122B 的权重用 NVFP4、KV 用 FP8、状态却必须 FP32)。
方案核心:状态 = 检查点 + 最近输入的回放窗口
把 SSM 递推在一个 h token 的窗口上展开,状态就可以表示成”窗口起点前的检查点 + 窗口内最近的输入记录“。ReplaySSM 平时只做两件事:把当前输入追加进缓冲、用检查点+缓冲算输出——不写状态;缓冲装满 L 条(评测用 L=16)才来一次 flush,把输入折进检查点、一次性写回 HBM。输出与常规解码在浮点误差内一致。
三笔收益,全部有数字
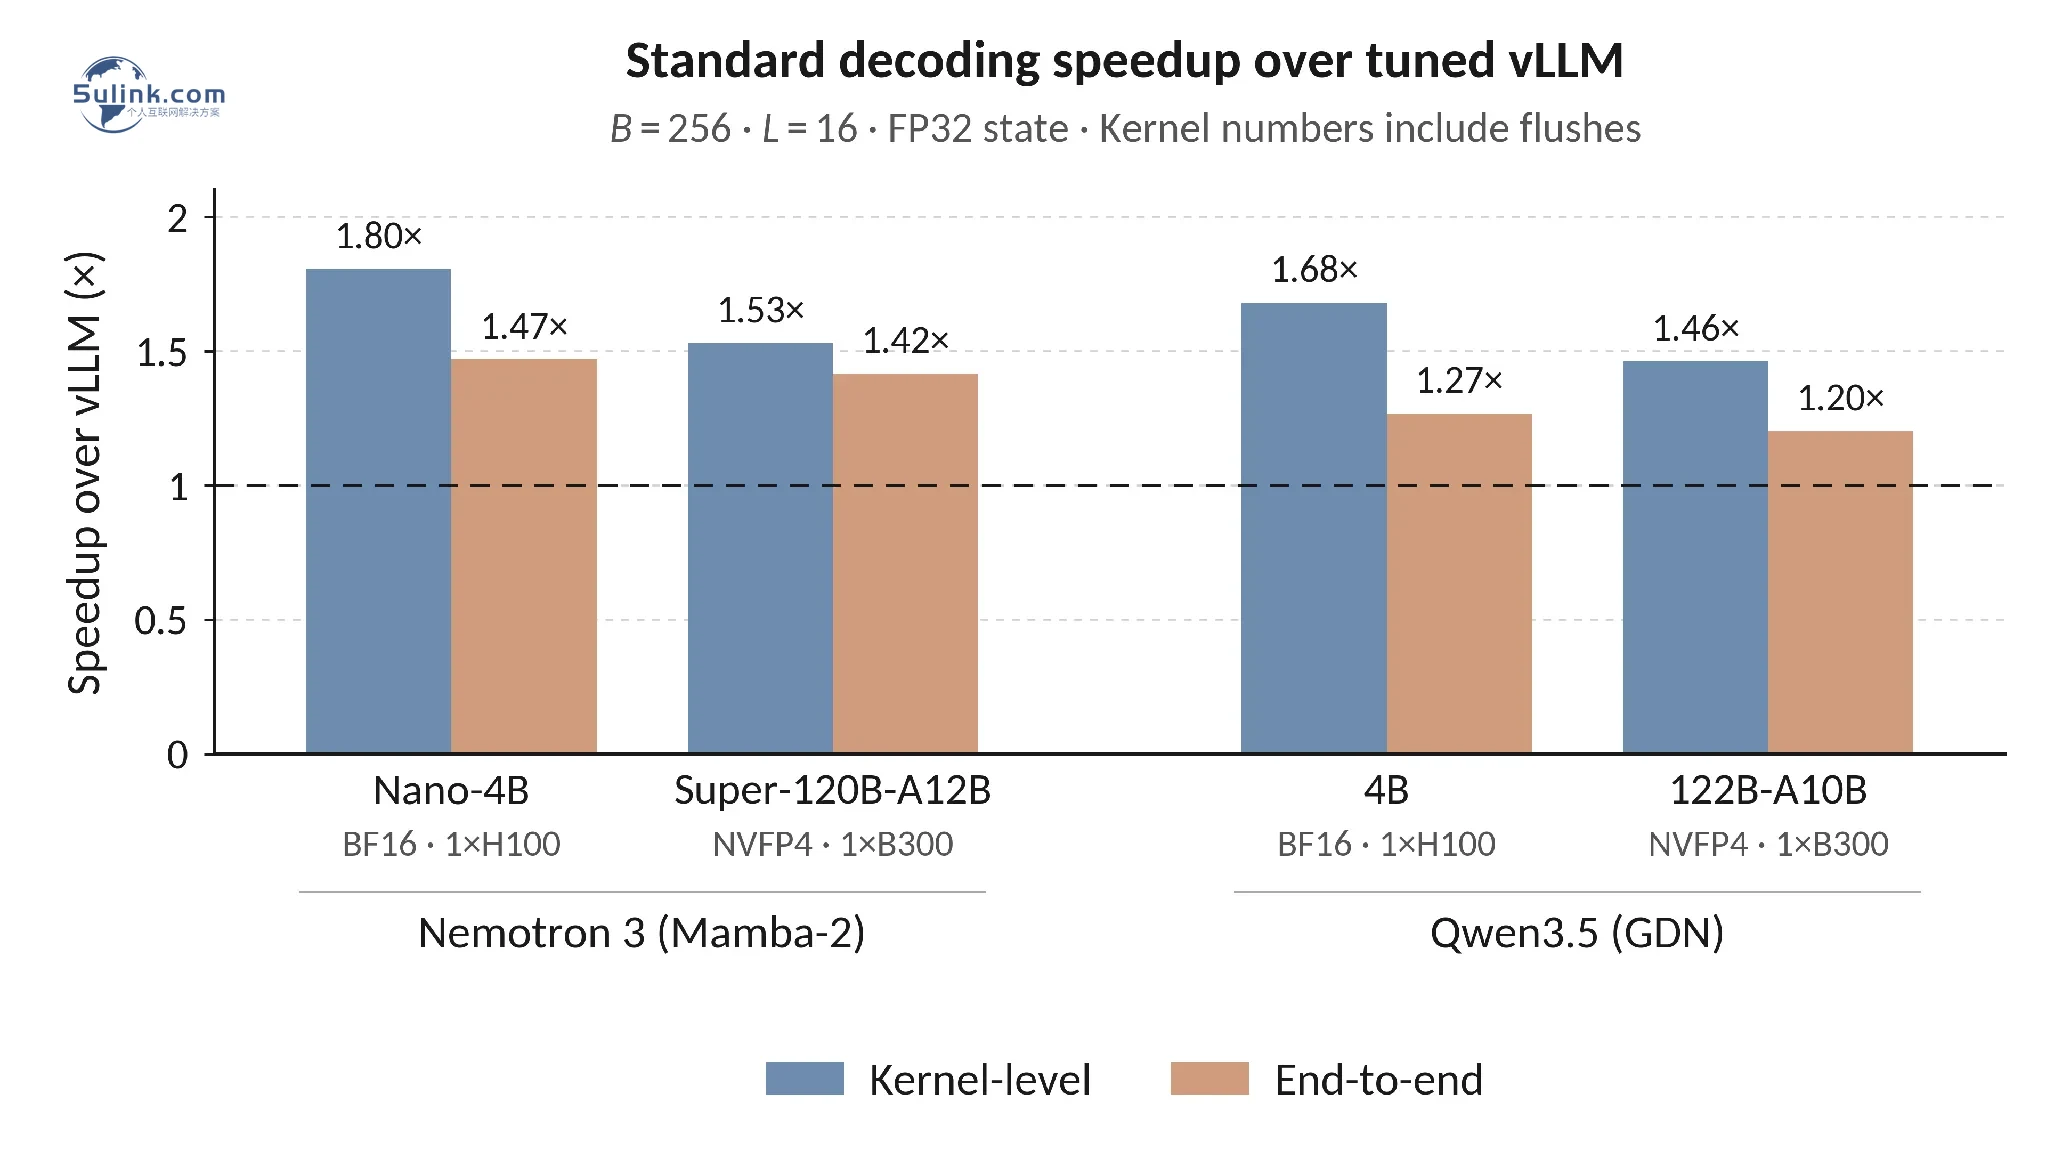
收益一:状态写入频率从每步降到每窗口——非 flush 步只写几条向量、不写矩阵,主要状态流量减半。batch 256 时 kernel 提速 1.46-1.80 倍,四模型解码步骤整体提速 1.20-1.47 倍(batch 1 无收益,其他延迟源占大头)。
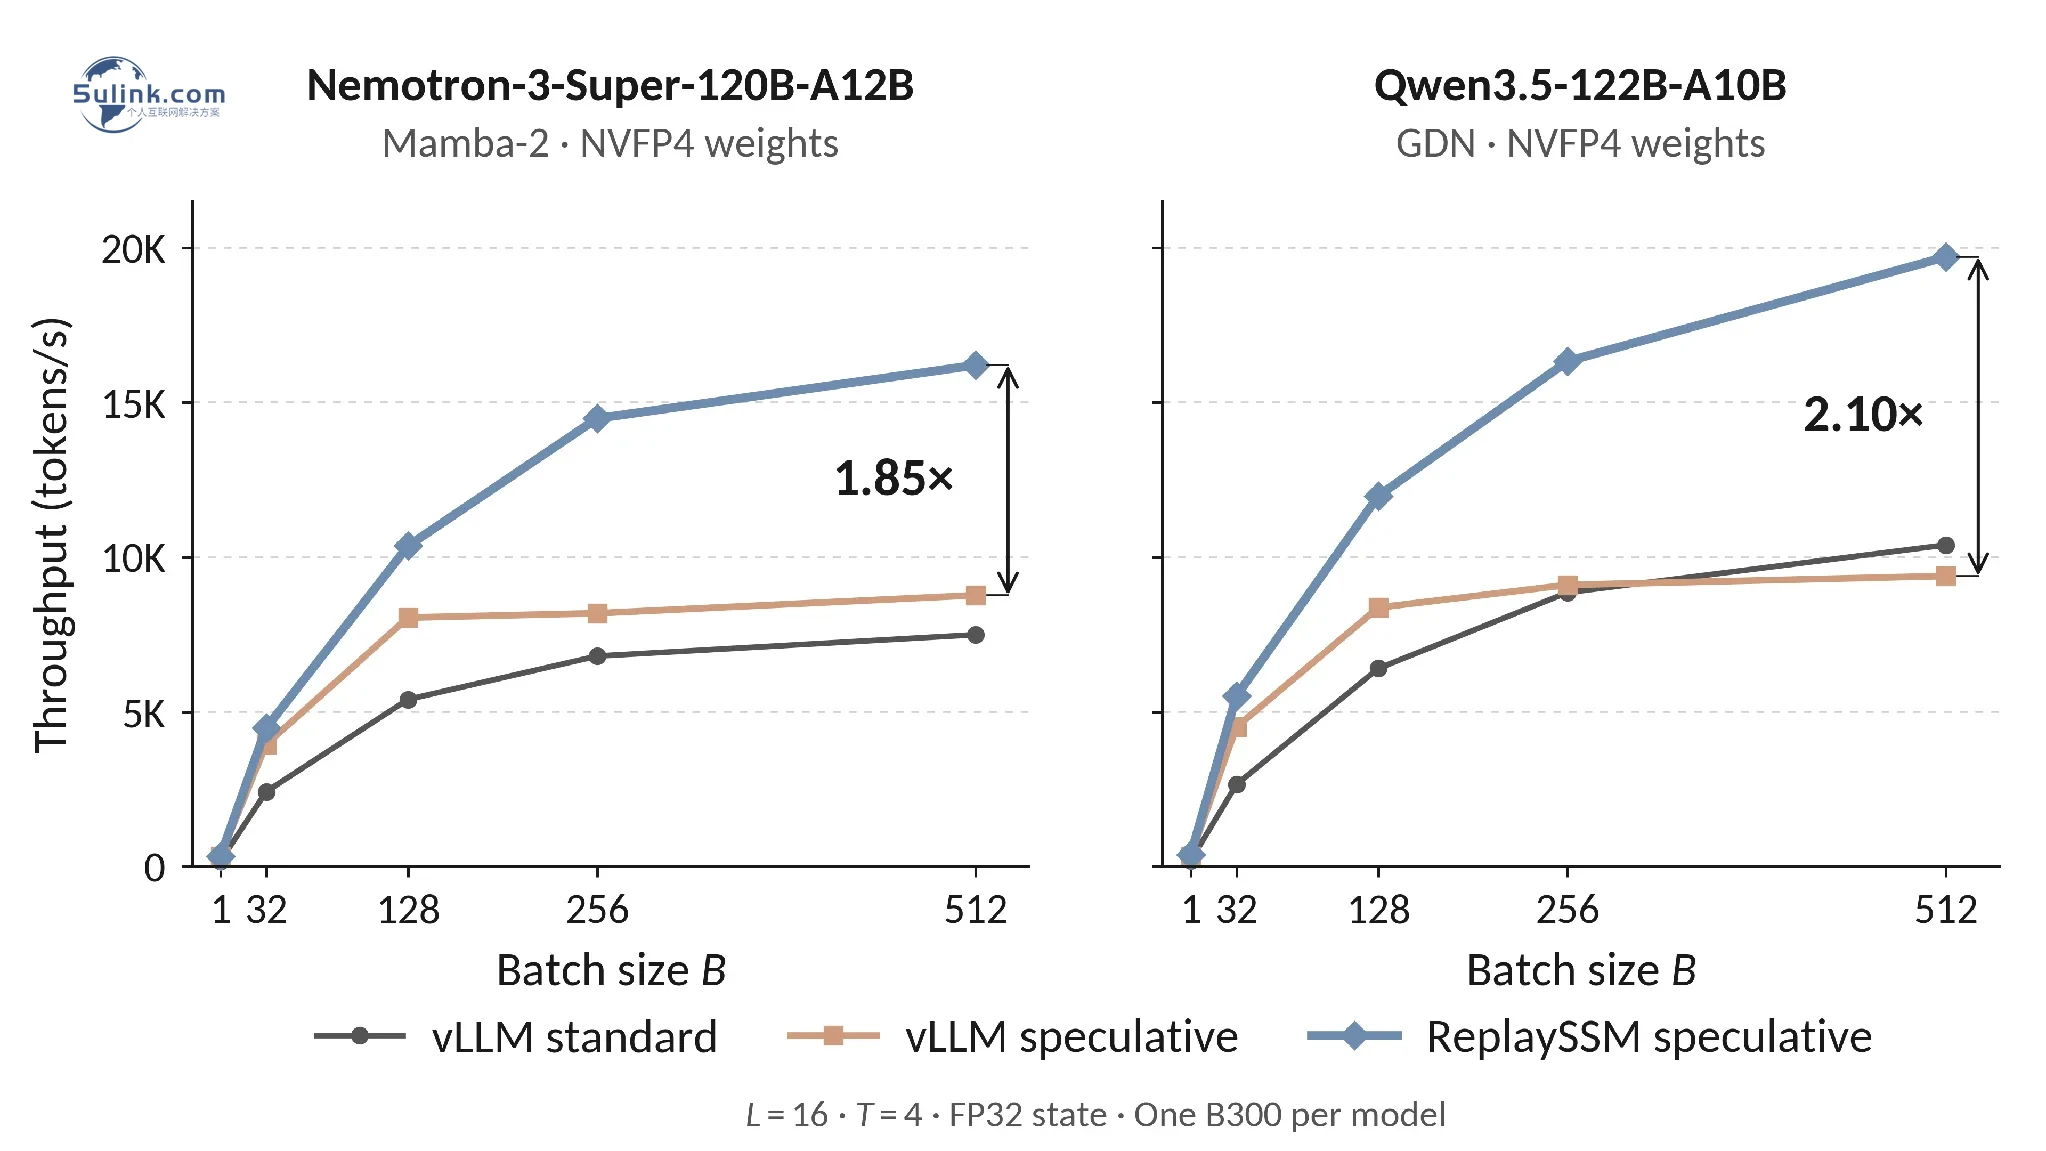
收益二:投机解码终于能用了——所有草稿 token 的输入先进缓冲,验证后移动指针、接受前缀、多余记录直接覆盖,没有快照要存。分离后还多送一个红利:”只算输出”的数学形态让检查点每窗口只用一次,其余全是小矩阵乘,Tensor Core 能加速。GSM8K、T=4、batch 512 时,投机服务吞吐达到 vLLM 现有投机解码的 1.85 倍和 2.10 倍(Nemotron 与 Qwen 两条线,接受长度对齐);T=8 时常规投机一步的延迟接近标准解码的 5 倍,而 ReplaySSM 8 个 token 约一步标准解码的时间验证完。常规投机在 batch 128 后不再增长、Qwen3.5-122B 在 batch 512 甚至跌破标准解码,ReplaySSM 随 batch 继续涨。
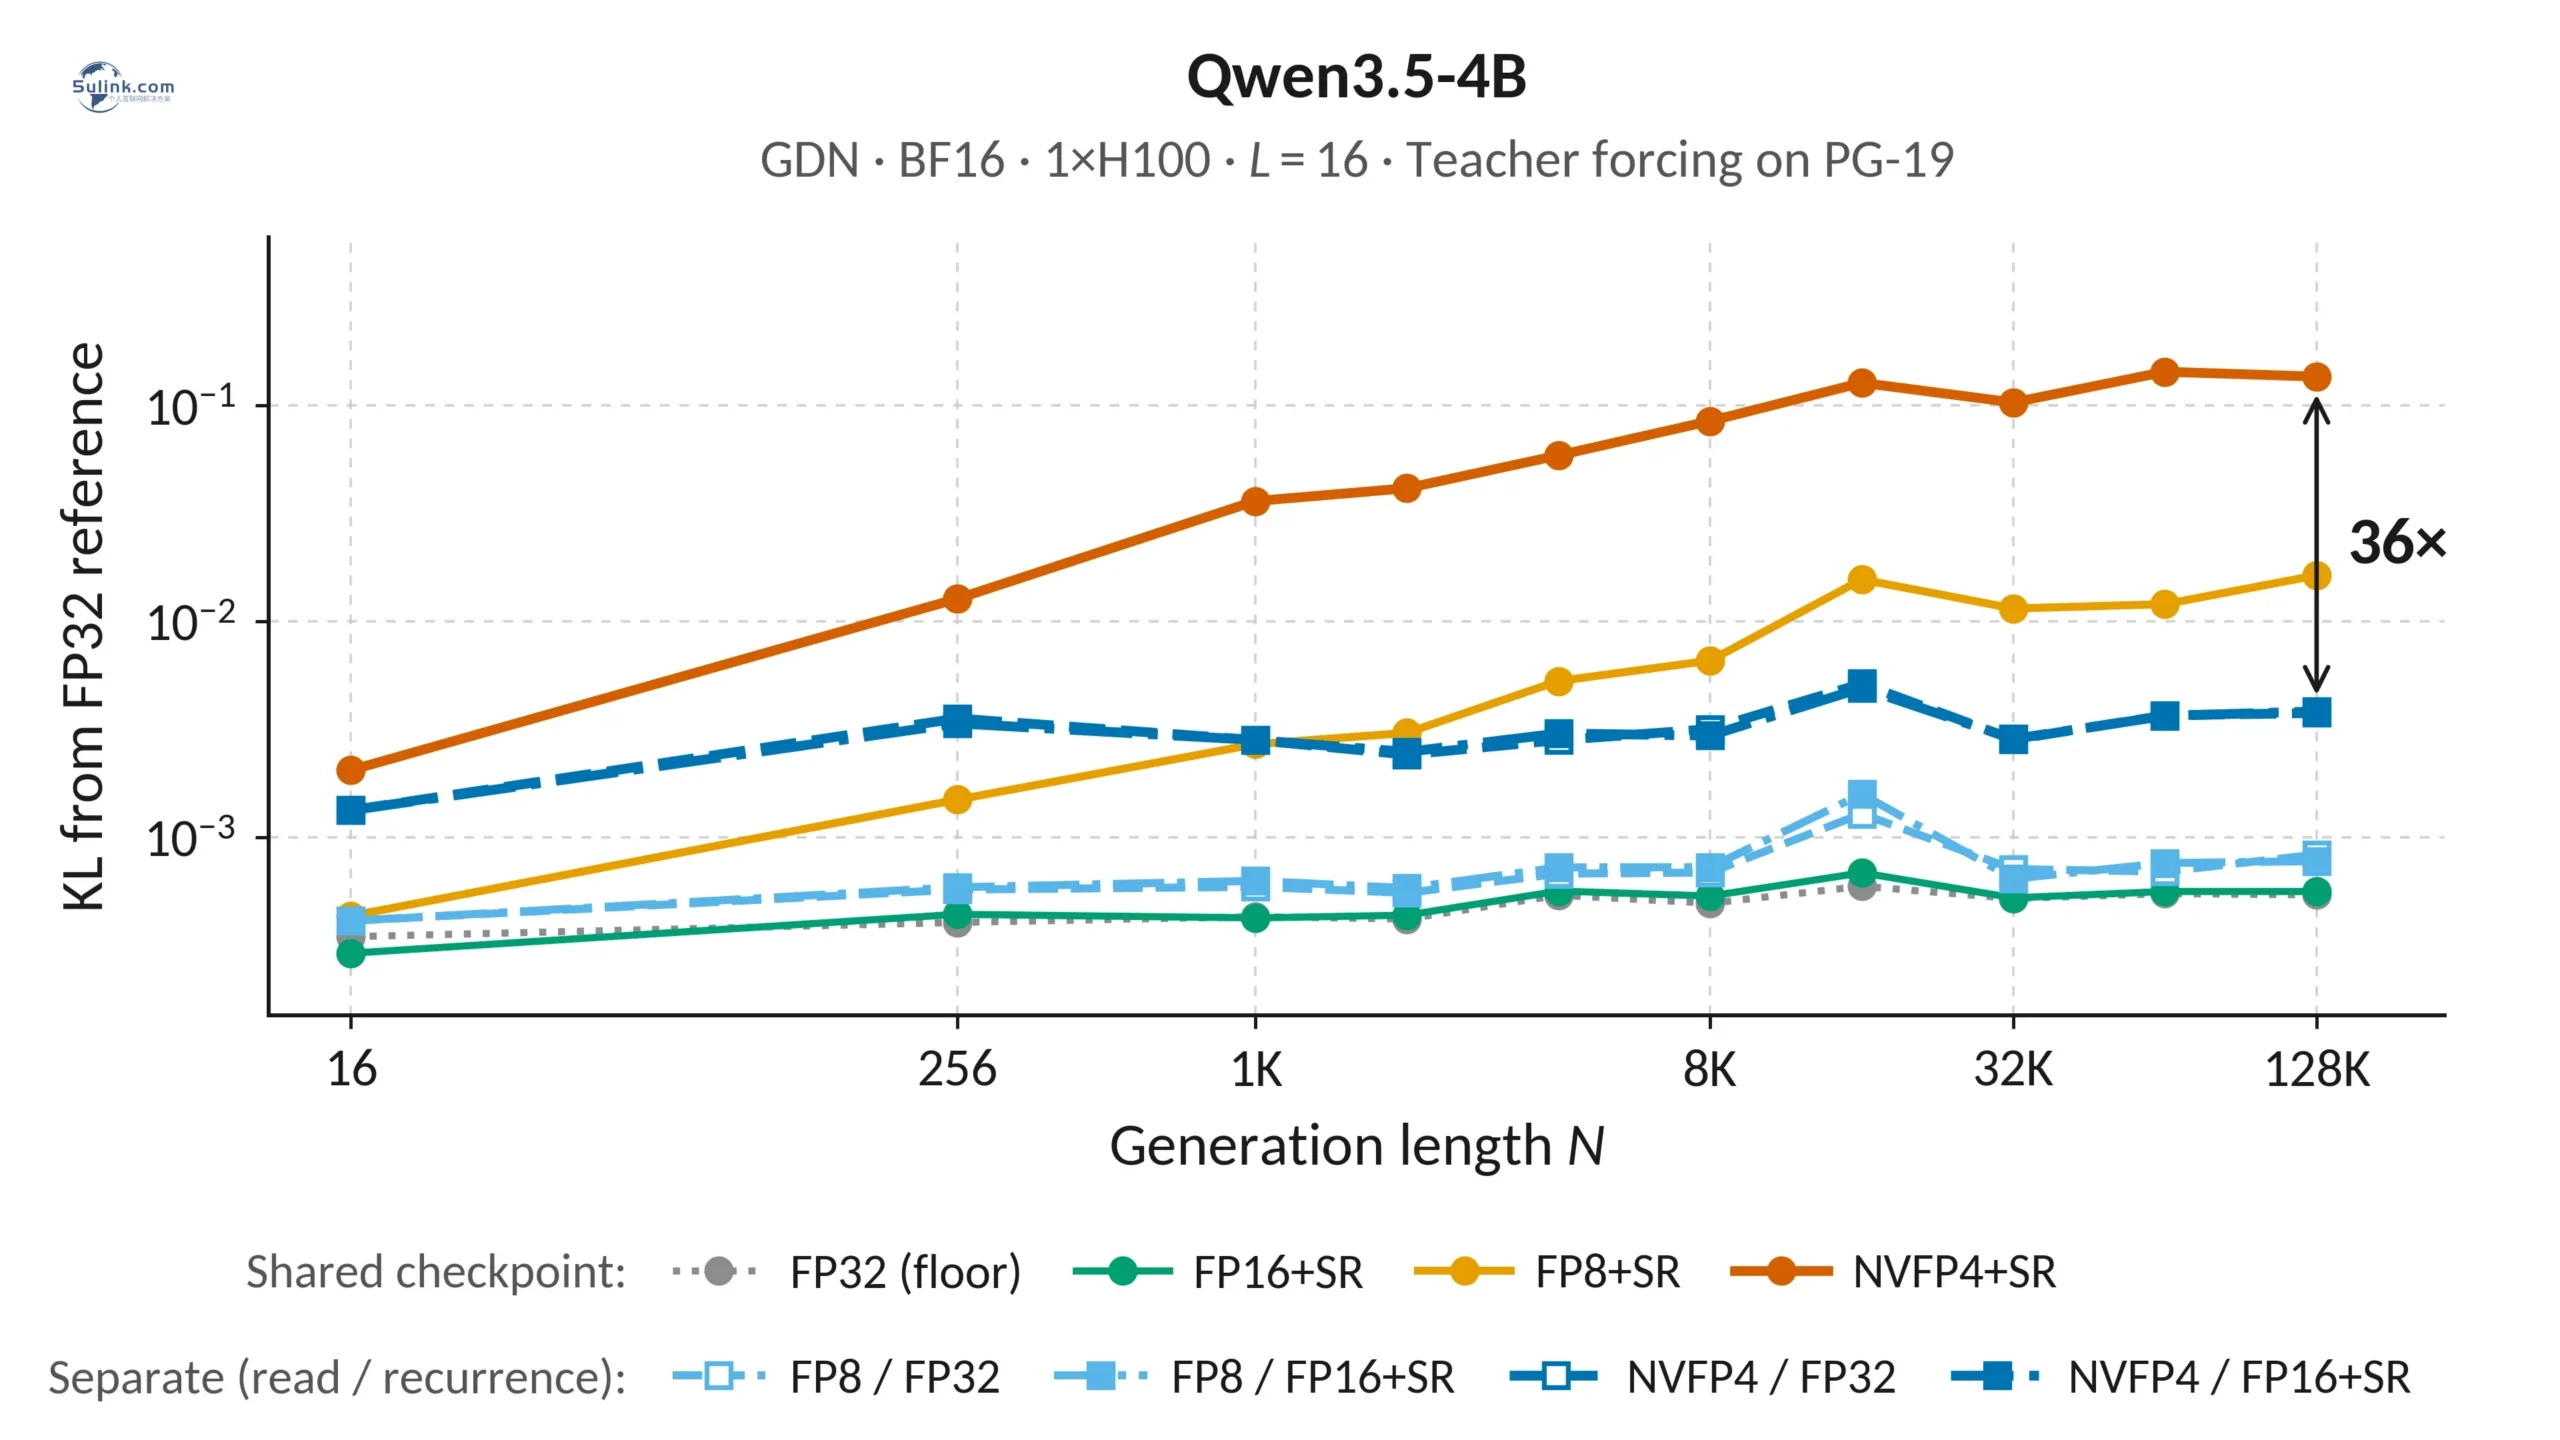
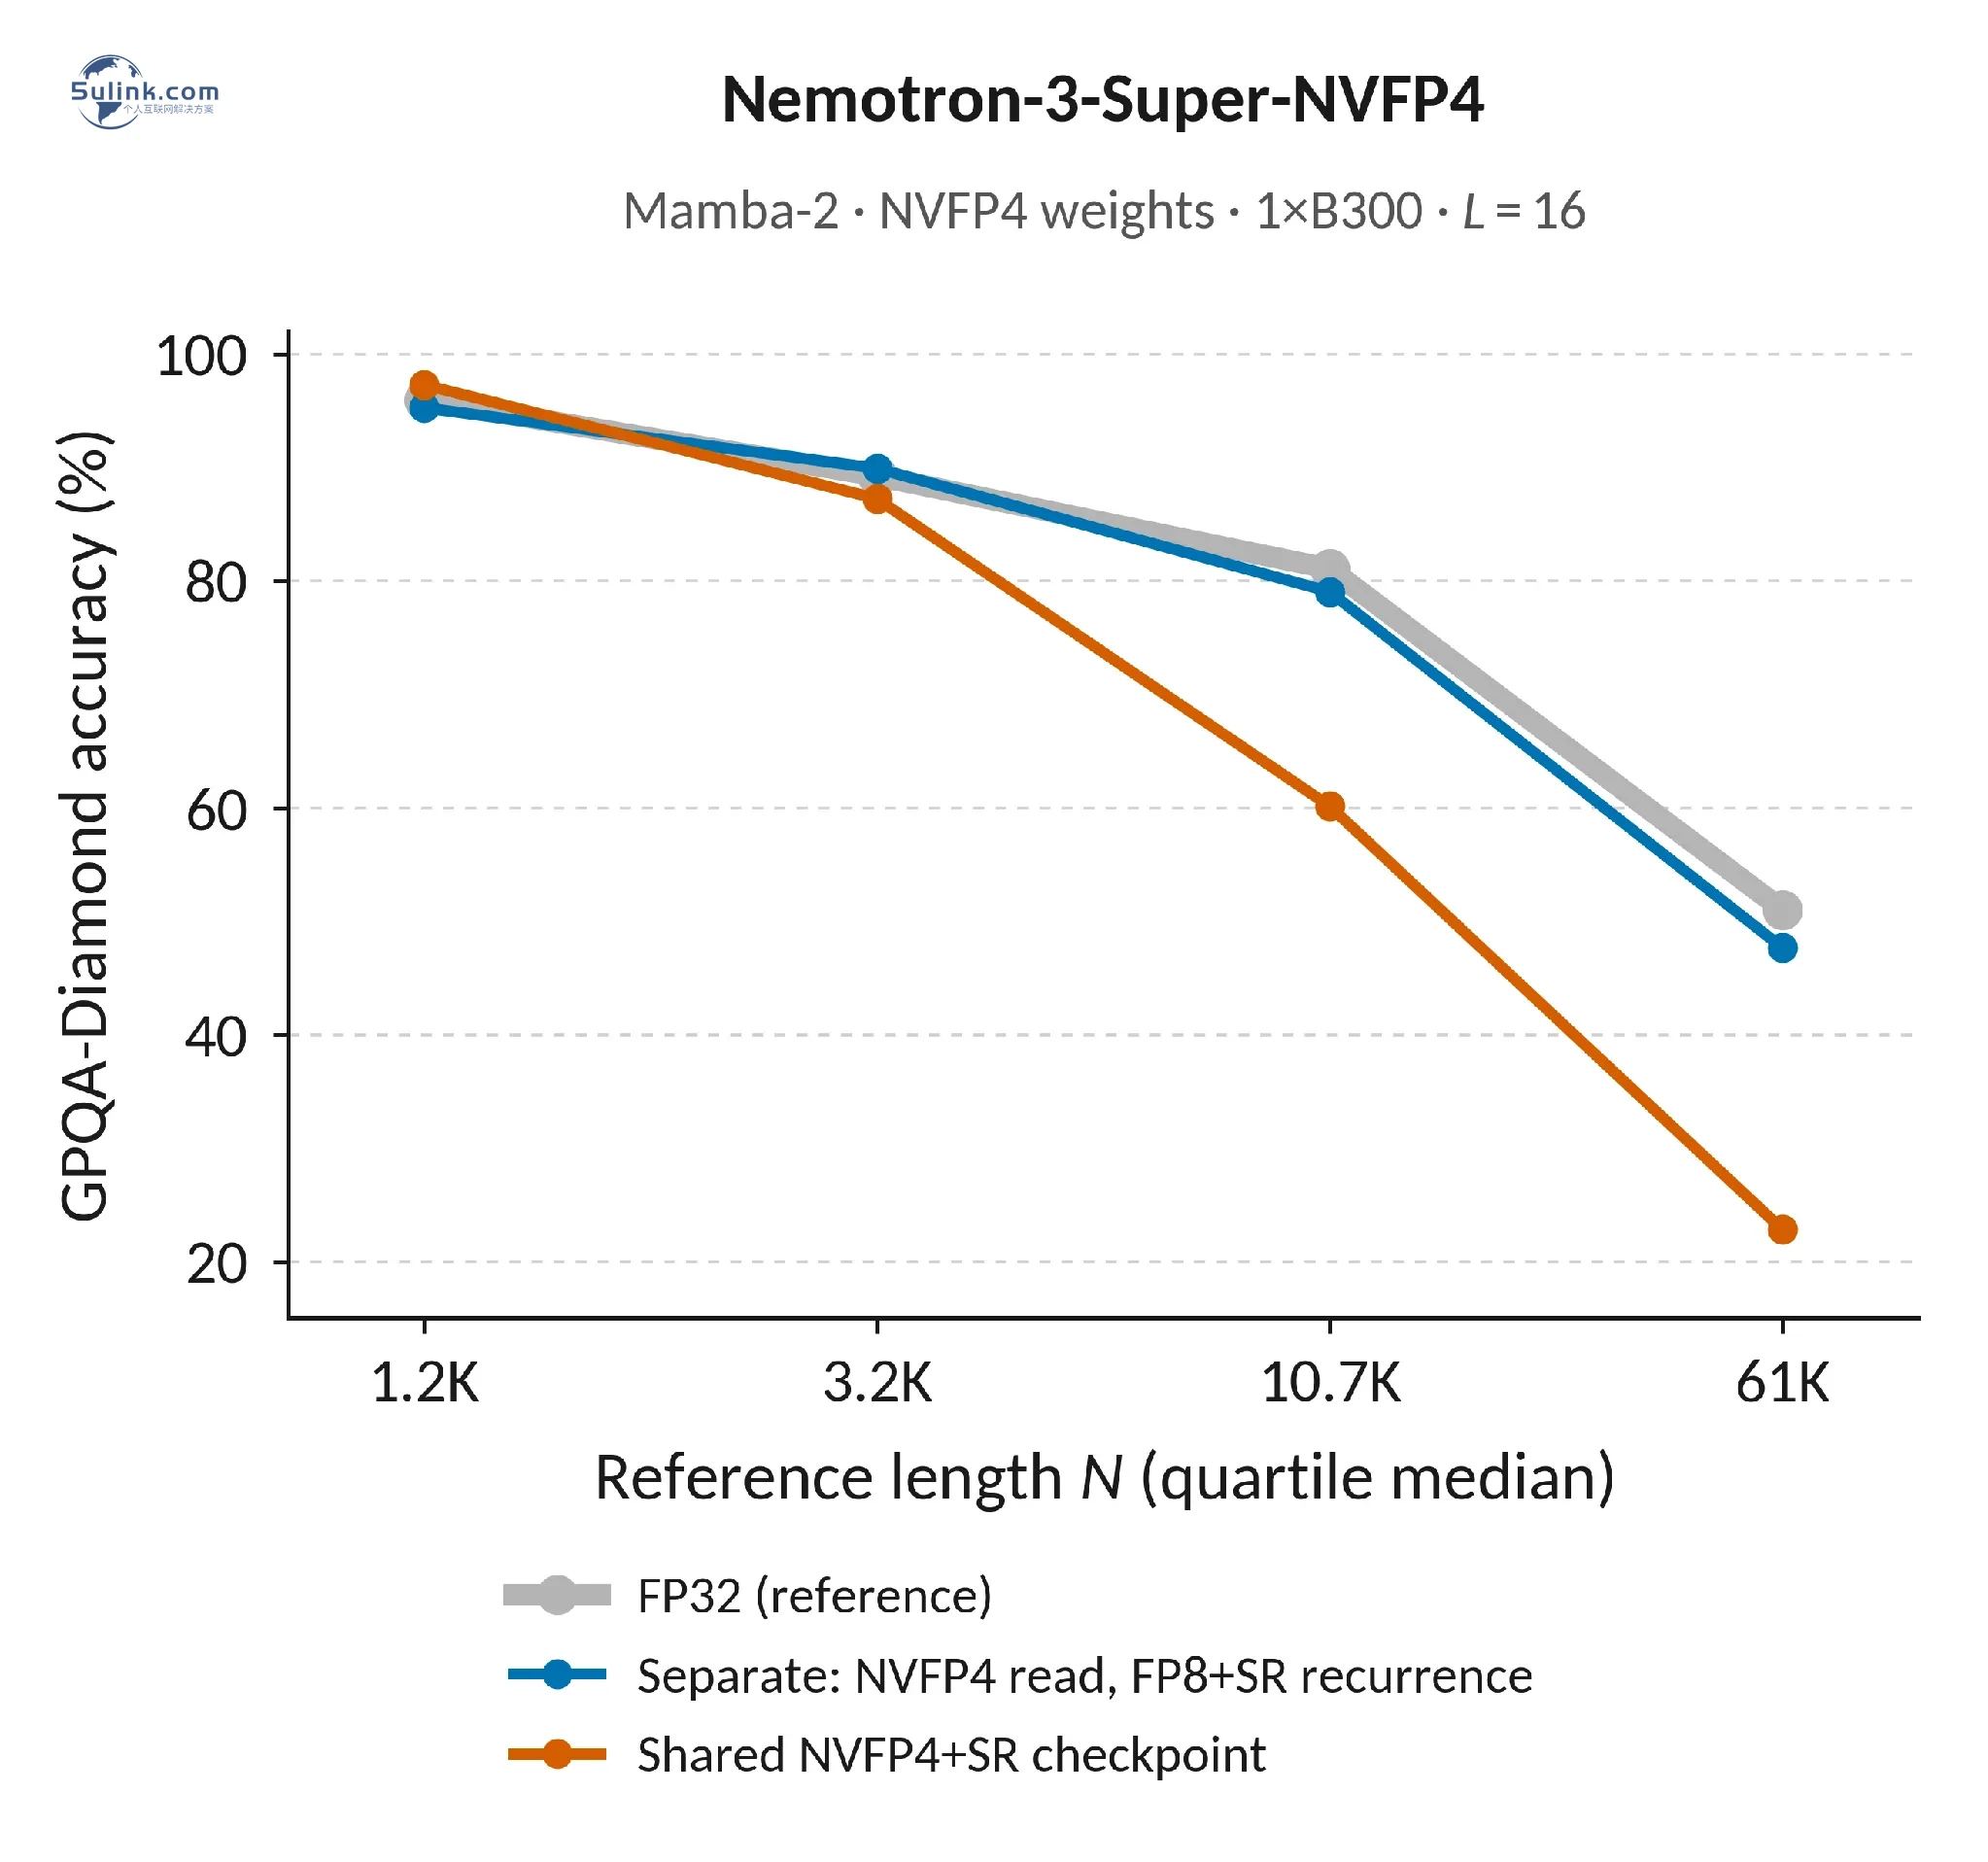
收益三:量化状态可以安全地低精度——非 flush 步”只为算输出读状态”,flush 步”才更新递推用的检查点”,两件事可以用两种精度:递推保 FP32(或 FP16+随机舍入),读路径用 NVFP4(非 flush kernel 快 3.8 倍)。低精度副本永不回流递推,误差只影响当前窗口的输出。12 万 token 生成长度下 KL 散度从 0.136 压到 0.0038;GPQA-Diamond 上共享 NVFP4 检查点最多丢 31 个百分点准确率,分开精度后四个模型里三个回到 FP32 的 2 个百分点以内。
| GPQA-Diamond 相对 FP32 的变化 | FP32 基准 | 共享 NVFP4 | NVFP4 读 + FP16+SR 递推 | NVFP4 读 + FP8+SR 递推 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | 56.7 | −31.3 | −6.7 | −5.6 |
| Nemotron-3-Super-NVFP4 | 79.3 | −12.5 | −1.4 | −1.4 |
| Qwen3.5-4B | 76.3 | −3.2 | +0.7 | +1.5 |
| Qwen3.5-122B-A10B-NVFP4 | 82.7 | −5.2 | −2.0 | −1.7 |
已经在生产里了
GLM-5.3-Flash 正用 ReplaySSM 服务(Z.ai 基础设施报告写进 KDA 解码 kernel),Kimi-K3 在 KDA 层缓存草稿 token 输入用于验证、并把 ReplaySSM 列为并行方法;TensorRT-LLM、vLLM、SGLang、FlashInfer 四大开源推理框架均已集成对应 PR。
小夏点评
- “内存带宽受限”这五个字正在重写推理优化的规则书——SSM 层算术少、搬数多,省时间的办法不是算更快,而是少搬:每窗口一写、按用途分精度。这和 KV 缓存领域的”分层/淘汰”是同一个哲学在不同数据结构上的投影。
- 论文-开源-生产的闭环速度值得注意:一篇 arXiv 论文同期进四大推理框架、两家国产头部模型已用它上生产——混合架构的优化竞赛以”周”为单位推进,跟慢半拍的自研推理栈差距会越拉越直白。
- 对中国 IT 行业的启示:Kimi-K3、GLM 系这两条”已在生产”的线都是国产模型——ReplaySSM 的受益者名单里中国团队不是观众而是主角。国内跑混合架构(Mamba/DeltaNet 系)推理服务的团队,值得把 L=16 窗口 + 精度分离这套配置抄进自己的 serving 调优清单,尤其是大 batch 长上下文的 Agent 场景,收益随 batch 增长。
参考链接
- 原文(NVIDIA Technical Blog):https://developer.nvidia.com/blog/replayssm-rethinking-state-storage-for-faster-hybrid-model-decoding/
- 论文:ReplaySSM: Cache SSM Inputs, Not State(arXiv)
- 代码:https://github.com/Johnny-Liou/ReplaySSM