从 197 秒到 0.82 秒:vLLM Elastic EP 实现推理集群近零停机扩缩容
对跑 MoE 大模型推理的团队来说,”加卡”一直是个昂贵但尴尬的动作:vLLM 过去要改变 GPU 数量,得整机重启或者整副本增删。模型越大,副本捆的卡越多,一次扩容动作浪费的算力时间就越长。vLLM 官方博客 10 月 19 日发文,公布了 Elastic Expert Parallelism(弹性专家并行)的最新进展:在 DeepSeek V4 Pro 的基准中,16→20 卡的扩容服务中断从 197 秒(重启方案)一路压到 0.82 秒,缩回 16 卡也从重启量级降到 1.96 秒。
把重构拆成”后台准备 + 秒级提交”
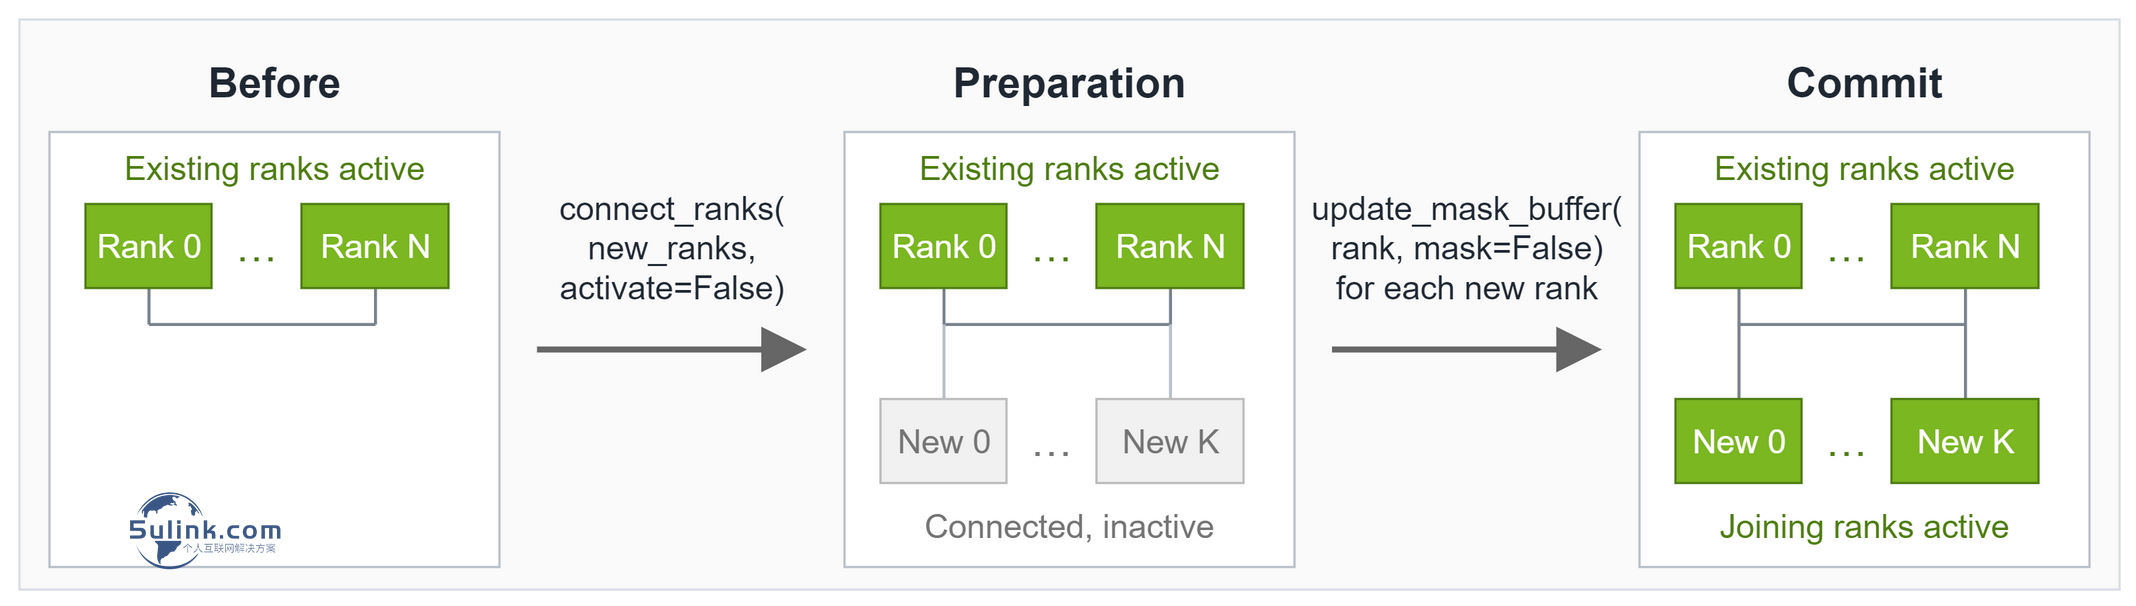
vLLM 把扩缩容流程拆成两段:老 worker 一边用现有通信组和 CUDA Graph 继续服务,一边在后台线程里完成四件事——启动新 worker、准备目标通信组、通过 NVLink/RDMA 从老 worker 传权重、在新 worker 上完成编译和 graph 捕获。全部就绪后才进入”提交”阶段:暂停调度器、切换拓扑、恢复服务。
NIXL EP:通信组原地扩容,graph 不重录
以往 EP 通信后端绑定固定 rank 集合,加一个 rank 就要重建实例——不仅双份缓冲区、内存注册和 RDMA QP 都要重做,最致命的是缓冲区一换,此前捕获的 CUDA Graph 全部作废,所有保留 worker 都得重做 warmup。在这项基准里,即使准备全部放到后台,只因为重录 graph,提交阶段仍有 58 秒(扩容)/ 44 秒(缩容)的服务停顿。
为此 NVIDIA 的 NIXL 团队专门做了 NIXL EP:在同一 agent、缓冲区和连接上原地增删 rank,内核从设备状态读取当前组成员,graph 可见的参数、启动配置和张量地址在重构前后保持稳定。保留下来的 worker 直接复用旧 graph,这是”近零停机”的核心。
加入者自己预热,不打扰在线流量
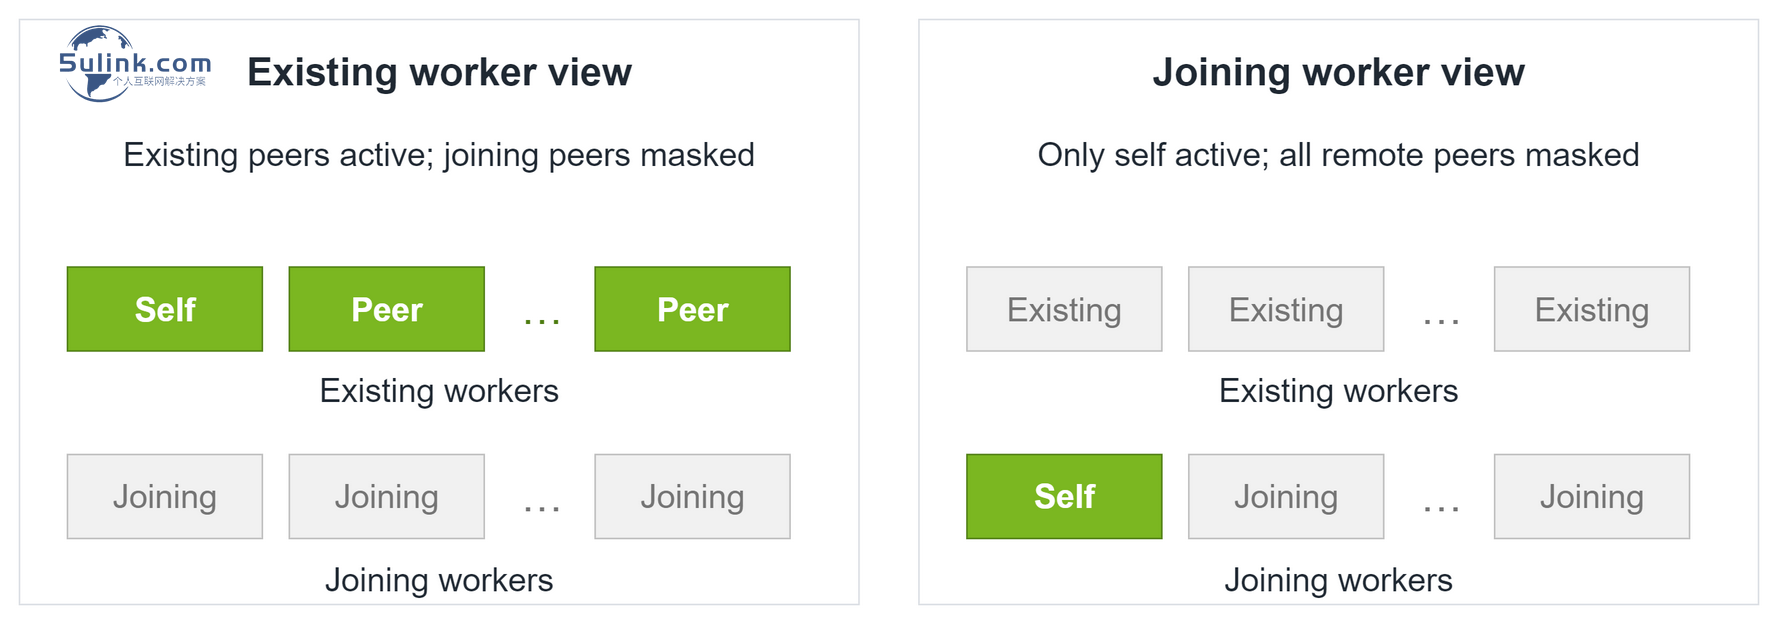
新 worker 预热时通常需要其他 worker 配合 EP dispatch/combine。NIXL EP 允许加入者把所有远端 peer 临时”掩码”,只保留本地 rank 完成 warmup 和 graph 捕获;vLLM 侧也改造了 DP batch 信息交换路径。老 worker 继续服务,新 worker 各自准备,互不干扰。
实测数据:DeepSeek V4 Pro on GB200
| 指标 | A 传统串行 | B 异步准备 | C 异步准备+Graph 复用 |
|---|---|---|---|
| 16→20 卡 服务中断 | 99.62 s | 58.04 s | 0.82 s |
| 20→16 卡 服务中断 | 56.25 s | 44.07 s | 1.96 s |
| 16→20 卡 总时长 | 99.72 s | 97.27 s | 92.34 s |
| 20→16 卡 总时长 | 56.21 s | 51.46 s | 9.32 s |
(重启基线:197 秒。方案 C 只有 NIXL EP 支持。)
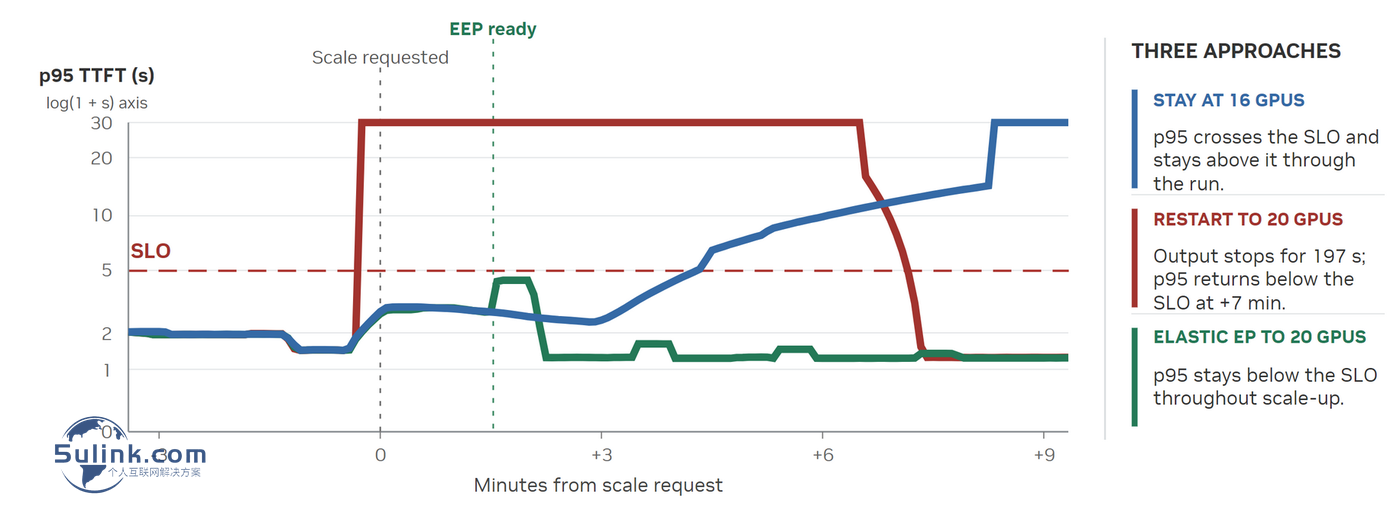
SLO 测试里,服务在 16 卡上承接 11,391 个请求回放场景,负载从约 8 req/s 爬到 16 req/s,SLO 为滚动 p95 首 token 延迟低于 5 秒:重启 20 卡的部署中途断服受罚,静态 16 卡部署后期扛不住,而 Elastic EP 全程达标——准备期性能与静态部署持平,扩容后与重启部署持平。
小夏点评
- 这项工作的价值不在”快”,而在”在线”——扩缩容从运维动作变成运行时能力,配合 Dynamo/llm-d 的自动伸缩,推理集群有望像无状态服务一样自动呼吸。
- 门槛在通信层:原地增删 rank、设备状态驱动的 graph 稳定契约,都是普通团队短期复现不了的工程积累,NIXL EP 已随 vLLM 正式版 pip 可装,可以先在测试环境验证。
- 对国内做推理云和大模型网关的团队,”秒级扩容”直接影响峰谷定价与闲置成本:GPU 池若能在分钟内弹性伸缩,夜间低峰缩容、高峰自动扩容的账就要重算——这正是弹性 EP 落地后最先兑现的商业价值。
来源
- https://vllm.ai/blog/2026-10-19-elastic-ep-near-zero-downtime
- https://vllm.ai/blog/2026-05-14-elastic-expert-parallelism
- https://github.com/ai-dynamo/nixl/blob/main/examples/device/ep/README.md