引擎已经同款,差别在打包:2026 年 Ollama 和 LM Studio 怎么选、老卡怎么点亮
先给结论(2026 年 10 月 21 日核对)
大多数 Ollama vs LM Studio 比较还在吵界面:桌面应用加滑杆对阵命令行加 API。但到 2026 年 10 月,引擎之争基本结束了——Windows 和 Linux 上两家跑的都是 llama.cpp,Apple Silicon 上两家跑的都是苹果 MLX。真正还有差别的是:各自公开什么、CUDA 构建里到底装进了哪些 GPU、以及默认怎么处理你的显存和网络端口。这在二手硬件上最要命。
- 同引擎,不同包装:Ollama 自 0.30(2026-05-13)起跑上游 llama.cpp 服务器(钉版 b11738);LM Studio 0.4.26 打包 llama.cpp runtime 2.50.0(上游 b11337)。
- 许可证:Ollama 全开源 MIT;LM Studio 是 Element Labs 的闭源应用(2025-07-08 起工作使用免费),CLI、SDK、MLX 引擎是 MIT。
- 老 Quadro:Ollama 写明支持并点名 P5000,构建文件可查;LM Studio 不公布 GPU 名单,自家 issue 区报告互相矛盾——测你自己的卡,留好 Vulkan 后路。
- CUDA 13 构建不含 Pascal 之前的代码:Pascal 卡留在 CUDA 12 构建 + R580 驱动上。
- 16GB 算术:Qwen3-14B Q4_K_M 文件 9.00 GB,单卡 P5000 装得下还留得出上下文;Qwen3-32B 的 19.76 GB 要两张卡。
- 安全:Ollama 本地 API”不需要认证”、默认只听 127.0.0.1;LM Studio 可以要求 API token。两个都不该直接暴露在开放端口上。
两家在 2026 年各自是什么
Ollama:GitHub 上 MIT 许可,稳定线 0.40.x(0.40.7)。引擎史解释了为什么旧对比文章互相打架:2025-05-15 宣布 Go 新引擎直调 GGML;2026-05-13 的 0.30 宣布”用 llama.cpp 提升兼容与性能”;如今仓库里 Go runner 已清空,构建的是上游 llama-server 钉版 b11738 加自家补丁。0.40.0(2026-09-25)起 Apple Silicon 上 MLX 成为默认。2026-06-05 那篇博文声称 NVIDIA 性能”最高快 20%”——厂商口径、单张新卡(RTX 5090)上测的,说明不了 Pascal 任何事;同一篇把 Vulkan 开了默认。桌面应用 2025-07-30 上线,云模型 2025-09-19 上线,2026-08-31 起云有免费额度,Pro $20/月含 $60 用量、Max $100、Team $500。FAQ 承诺本地运行”我们看不到你的提示词和数据”,OLLAMA_NO_CLOUD=1 可整体关掉云功能。
LM Studio:Element Labs 出品。应用条款(2026-08-23 版)称源代码是”有价值的商业机密”,工作使用免费(2025-07-08 公告取消了商业许可要求)。GitHub 上 lms 命令行、JS/Python SDK、MLX 引擎是 MIT;应用本体、headless 守护进程和 llama.cpp runtime 包都不开源。MLX 从 0.3.4(2024-10-08)就有;headless 守护进程 llmster 无 GUI 运行,官方文档点名的场景就是”没有屏幕的 GPU 机器”。系统要求 x64 CPU 必须 AVX2、推荐 16GB 内存 + 4GB 独显显存、Intel Mac 不支持。
| 2026 年 10 月 | Ollama | LM Studio |
|---|---|---|
| 许可证 | MIT,全部源码公开 | 闭源应用(家用办公均免费);CLI/SDK/MLX 引擎 MIT |
| 引擎(Win/Linux) | llama.cpp llama-server,钉版 b11738 | llama.cpp runtime 2.50.0(上游 b11337) |
| 引擎(Apple Silicon) | 0.40.0 起默认 MLX | 0.3.4 起就有 MLX |
| GPU 支持名单 | 有:compute capability 5.0+,逐卡点名 | 无;只推荐”4GB 独显显存” |
| 接口 | CLI + API;macOS/Windows 桌面应用 | 桌面应用;lms CLI;headless llmster |
| API 认证 | 本地 API 无认证 | 默认无;0.4.0 起可要求 API token |
| 多卡控制 | 自动;环境变量分配 | GUI 逐卡开关、”evenly”或优先序 |
| CPU 底线 | 文档未提 | x64 要求 AVX2 |
谁适合谁
- 开发者,或机柜里的 Linux 机器:Ollama。全开源、控制用的环境变量有文档、自己会挑匹配显卡的 CUDA 构建,API 覆盖 OpenAI 与 Anthropic 路由。LM Studio 的 llmster 也能无头跑,但 runtime 闭源、不能换自己的构建。
- 要边浏览模型边拉滑杆的桌面用户:LM Studio。加载前估算显存、逐卡开关,命令行同样可控(
lms load <model> --gpu max --context-length 16384)。 - Mac:都行,两家都跑 MLX;LM Studio 完全不跑 Intel Mac。
- 老 Quadro/Tesla 卡:从 Ollama 开始——两家之中只有它点名卡型号、构建文件可查。
- Xeon E5-2600 v2 时代或更早的工作站:不是 LM Studio——它的 Windows 版要求 AVX2,而 Xeon E5-2697 v2 的 ARK 页只写”Intel AVX”(HP Z620/Z820 那一代全军覆没)。
- 两家可以同时跑:端口不同(11434 / 1234)、都吃 GGUF,Ollama 一行 Modelfile 就能导入现成 GGUF。
安全提示:Ollama 默认绑 127.0.0.1:11434,本地 API 不需要认证——FAQ 里共享到网络的示例 OLLAMA_HOST=0.0.0.0 等于把无密码 API 交给所有能访问该端口的机器。LM Studio 默认同样不认证,0.4.0 起可在 Developer 页要求带权限的 API token,”Serve on Local Network”开关决定服务是否离开本机。先开 token 再开网络开关,别让路由器转发任何一个端口。
老卡还能不能点亮:Ollama 有据可查,LM Studio 证据矛盾
CUDA 程序按 compute capability 携带各代 GPU 的编译代码:5.0/5.2 是 Maxwell,6.0 是 Tesla P100,6.1 是包括 P5000 在内的 Pascal,7.0 Volta,7.5 Turing。代码分两种打包:”real”是即跑的机器码,”virtual”是 PTX(驱动首次加载时 JIT 编译)。两头都没有的卡,驱动再新也是”no supported GPU”。
Ollama:硬件页(2026-10-12 更新)写明支持 compute capability 5.0+、驱动 550+,其中 5.0–6.2 要求驱动 570+。表里点名 Quadro P6000/P5000/P4000/P2000 等 Pascal 卡在 6.1、Tesla P100 在 6.0、Quadro M6000/M5000 等 Maxwell 卡在 5.2。买家陷阱:K620/K1200/K2200 虽姓 K 其实是 Maxwell 芯片,被列在 5.0——真正的 Kepler 在门槛之下。构建文件对得上:CUDA 12 Linux 预设编译 50-virtual;52-virtual;60;61;70;75;…(6.0/6.1 都是真码),Windows CUDA 12 预设 Pascal 走 PTX;两个 CUDA 13 预设都从 75-virtual 起步。启动时 runner 自动选能覆盖所有卡的库版本,Pascal 卡落进 CUDA 12 runner,无需设置。2025 年以来的 release notes 也在往老卡方向走:0.12.0/0.13.1 修老卡检测,0.31.2(2026-07-06)给 6.x 开了 flash attention。
LM Studio:需求页不写 compute capability、CUDA 版本、驱动版本,runtime 不开源、构建参数看不到。有用户 2025 年 2 就建议”像 Ollama 那样列出支持的 compute capability”,issue 至今没人回。能依据的只有 tracker 上的用户报告,而且互相矛盾:#2354(2026-09-01)里 Windows CUDA runtime 2.31.2 的报错列出了 500/610/750/800——Maxwell 和 Pascal 代码在、Volta 不在;#2316(2026-08-22)里一张 P4000 报”没有支持的 CUDA GPU”。原文的结论很克制:不写”LM Studio 放弃了 Pascal”,证据是矛盾的。P5000 上的实操:装 LM Studio、选 CUDA llama.cpp runtime、看硬件设置里卡是否出现;不出现就换 Vulkan runtime、旧 CUDA runtime 或 Ollama。
R580 时钟:NVIDIA 矩阵给 Maxwell/Pascal/Volta 的最后一版 toolkit 都是 CUDA 12.x、最后驱动都是 R580。R580 安全更新到哪年,两份官方文档口径不一:Quadro 支持计划写”到 2028 年 10 月”,数据中心驱动表写 LTS 分支”2028 年 6 月结束”。Linux 还有一个坑:开源内核模块不支持 Maxwell/Pascal/Volta,安装器默认装开源模块——P5000 在 Linux 上要装专有驱动的 R580,否则两个应用都看不见卡。
显存算术:权重 + KV 缓存
显存需求是两个数相加:GGUF 文件是权重,KV 缓存随上下文增长(每 token 字节数 = 2 × 层数 × KV 头数 × 头维度 × 每值字节数,默认 f16 按 2 字节)。
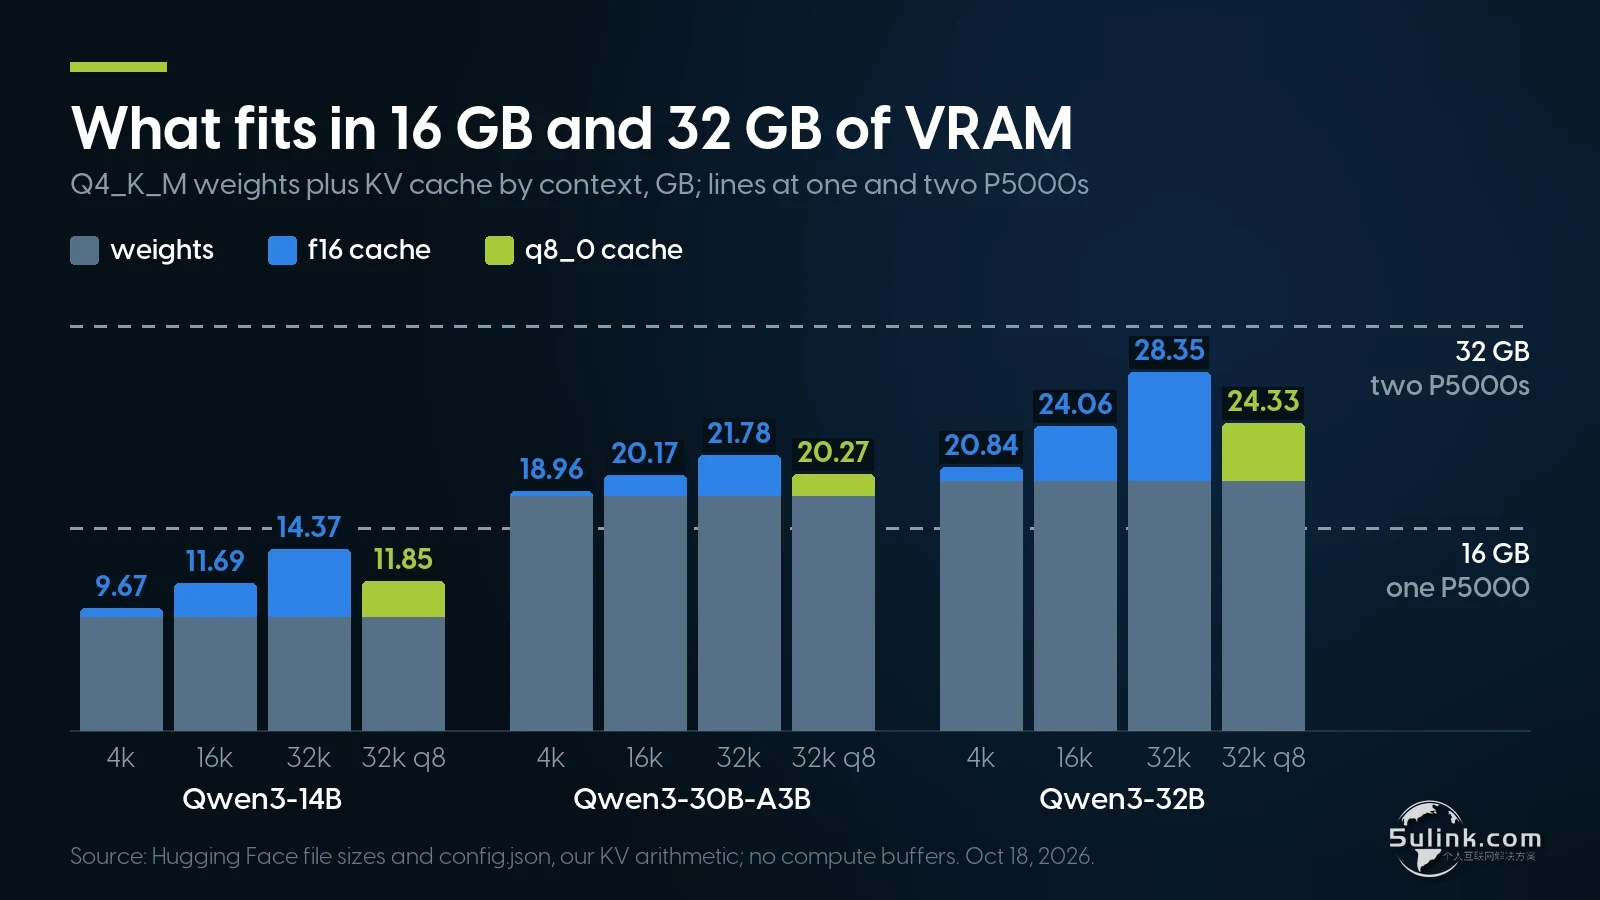
图:三个常用模型的权重 + KV 缓存占用(数据:PCSP 原文,文件尺寸取自 Hugging Face,2026-10-18 核对)
| 模型(Q4_K_M) | 权重 | 32k 上下文合计 | 落位 |
|---|---|---|---|
| Qwen3-14B | 9.00 GB | 14.37 GB | 单卡 P5000;32k f16 偏紧 |
| Qwen3-30B-A3B(MoE) | 18.56 GB | 21.78 GB | 两卡,或一卡 + CPU 卸载 |
| Qwen3-32B | 19.76 GB | 28.35 GB | 两卡(32GB),f16 到 16k 或 q8_0 缓存到 32k |
“16GB 能跑 13B/14B Q4″成立,还留得出 16k 上下文;32k 就要 14.37 GB——还没算 compute buffer 和 CUDA 上下文。Ollama 默认上下文按全部 GPU 之和分档:47GiB+ 给 256k、23GiB+ 给 32k、否则 4k——一张 P5000 拿 4k,两张 32k,三张 256k;多卡机器自己设 OLLAMA_CONTEXT_LENGTH。flash attention 在 0.31.2 起支持 6.x,P5000 可以用 OLLAMA_KV_CACHE_TYPE=q8_0 把缓存砍到约一半。
多卡与 CPU 卸载:带宽定速度
Ollama 的规则很明确:模型能整个装进单卡就单卡跑(少过 PCI 总线),装不下才摊到所有卡;LM Studio 把同样的决定搬进了 GUI(逐卡开关、evenly/优先序)。层切分买的是容量——两张 16GB 卡装得下 24.06 GB 的 Qwen3-32B,但 token 还是要逐卡穿过,只有激活值过总线。
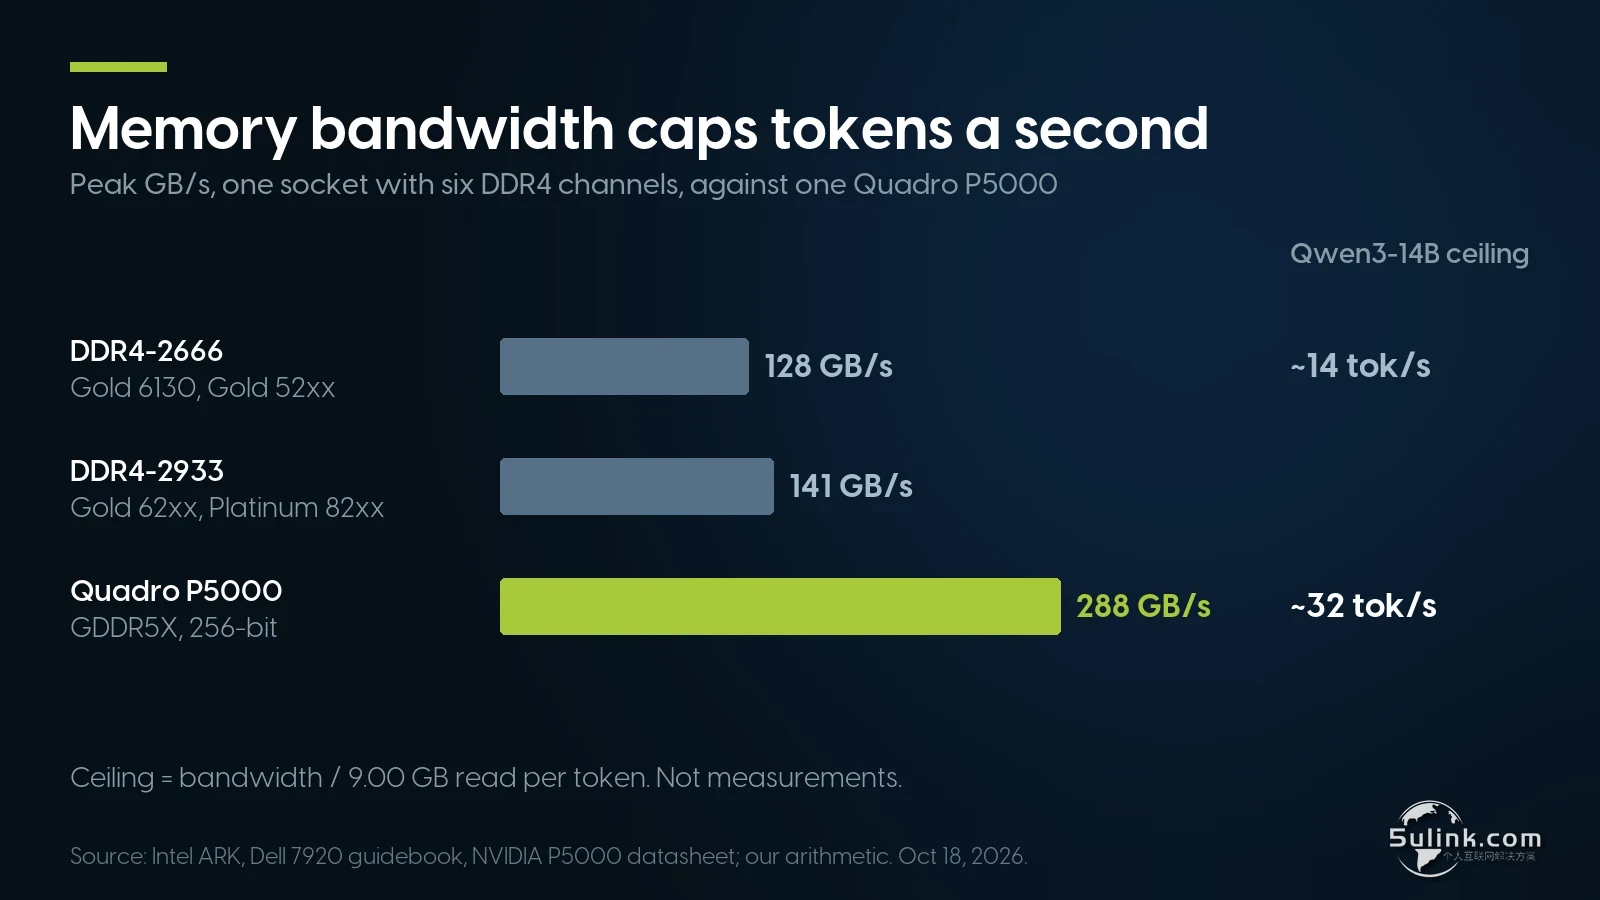
图:满通道双路 Xeon 的内存带宽天花板对 P5000 的显存带宽——卸载场景下带宽定速度(数据:PCSP 原文算例)
生成一个 token 约要把活跃权重读一遍,天花板 = 内存带宽 ÷ 读取字节数。满通道单路峰值 2,666 下约 128 GB/s、2,933 下约 141 GB/s,而 P5000 是 288 GB/s——Qwen3-14B 的 9 GB 权重,2,666 单路天花板约 14 token/s,卡上约 32。适合卸载的模型是 MoE:Qwen3-30B-A3B 文件 18.56 GB,每 token 活跃参数只有约 3.3B(Q4 下约 2 GB),--cpu-moe 把专家权重全放内存、共享层和缓存留在卡上——这才是双路 Xeon 大内存的正确用法。
二手硬件:一张 P5000 和它的机箱
卡:P5000,2,560 CUDA 核心、16GB GDDR5X、256-bit 总线最高 288 GB/s、180W、单 PCIe 8-pin。货架价 $193.02(约 $12.06/GB 显存);同档另一张是 Turing Quadro RTX 5000,$517.49($32.34/GB)。24GB 卡和 Tesla 卡不单卖,A4000/A6000 只作为整机选配。
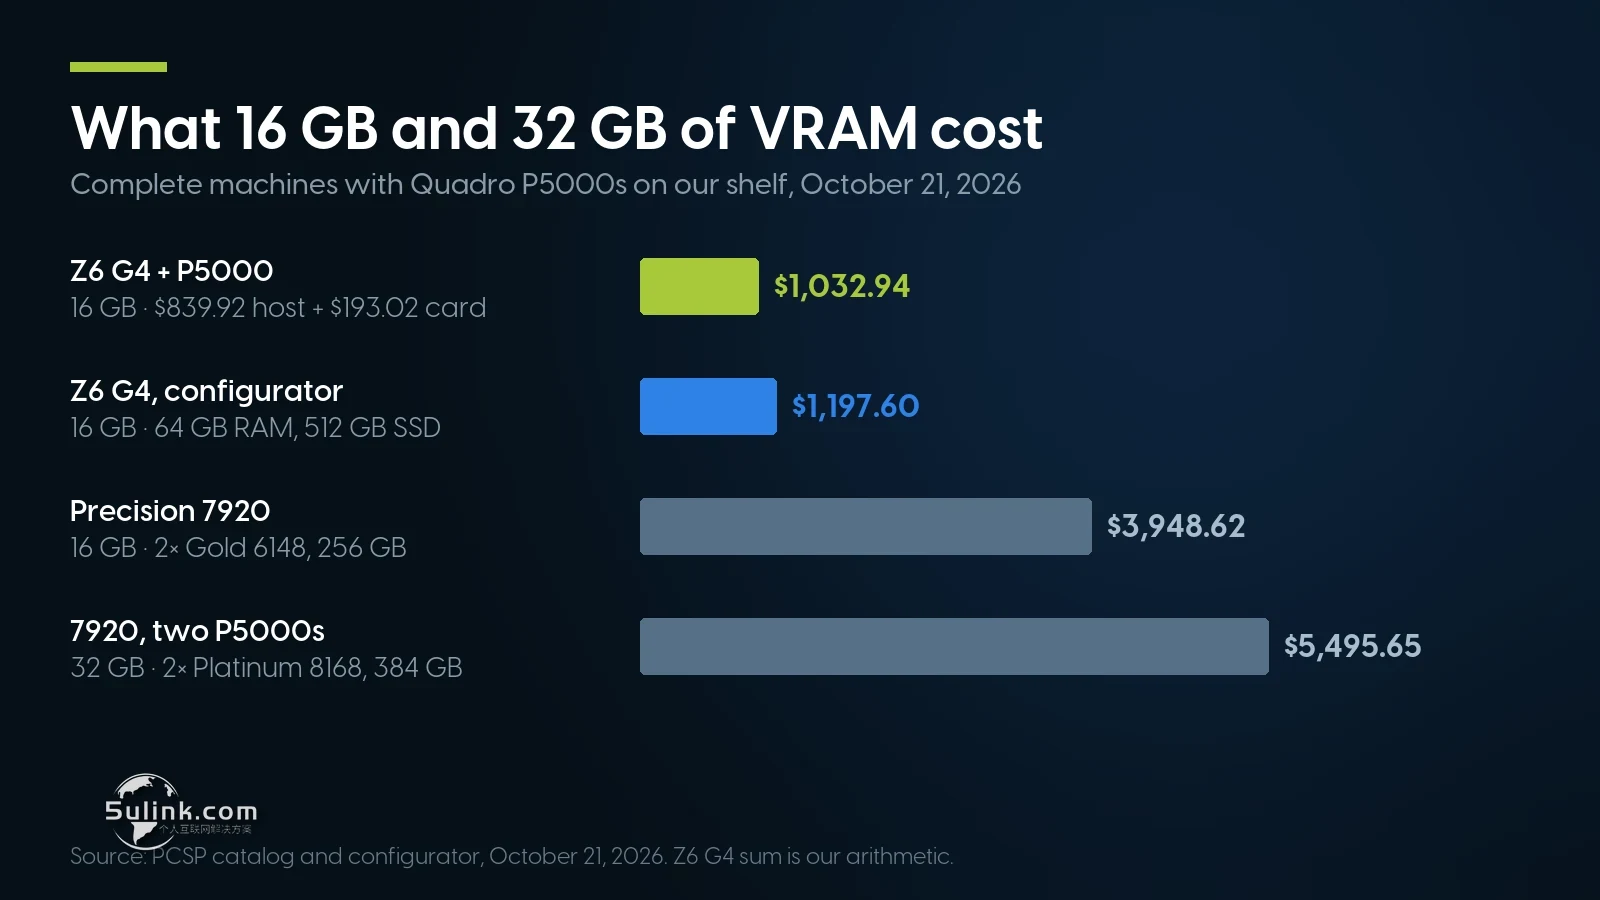
图:整机对照——Z6 G4 + 单卡是表内最便宜的 16GB 机器(数据:PCSP 货架与配置器,2026-10-21)
| 主机 | 供电与插槽 | 货架最便宜整机 |
|---|---|---|
| HP Z6 G4 | 单 1000W 电源、两根 6/8-pin、两条 Gen3 x16;HP 自家示例配置就跑两根 P5000 | $839.92(配 K620,换卡后约 $1,032.94) |
| HP Z8 G4 | 四条 x16(两条需第二颗 CPU);1125/1450/1700W,每档四根 6+2-pin | $1,536.24 |
| Dell Precision 7920 | 单 CPU 两条 x16、双 CPU 最多三张双宽卡;图形负载 750–900W 要 220V | $1,589.54 |
两根 P5000 按手册 360W,HP 实测双 Xeon 8160 + 双 P5000 的 Z6 G4 满载 698.5W(1000W 电源内);三张卡 540W,上双 CPU 的 Z8 G4/7920。四张双宽卡两台都不收。
什么时候二手 Quadro 是错误答案
- 你要的是单用户速度:llama.cpp 社区基准里 P5000 用户提交 48.61 token/s,同测试榜上 RTX A4000 是 83.77、RTX 3090 是 158.16。
- 你要 Tensor Core/FP16/CUDA 13:6.x 架构没有 Tensor Core,vLLM 要 7.5 起——Turing(RTX 5000)之后才在 CUDA 13 线上。
- 你其实在 Mac 上工作:Apple Silicon 的 MLX 统一内存能装下 P5000 装不下的模型。
- 你一周就跑一次大模型:租云在低用量下赢。
小夏点评
- 这篇是”证据分级”的范本:Ollama 的支持可以查到构建文件(CMakePresets 里的 60/61 真码),LM Studio 只有用户报告且互相矛盾——原文拒绝写”LM Studio 放弃 Pascal”,只给”测你自己的卡 + Vulkan 备胎”。老卡采购只看可验证证据,不看兼容性列表情绪。
- 三个实操坑值得抄进采购清单:K 字头里混着 Maxwell(K620/K1200/K2200 真能跑,真 Kepler 不能);Linux 上开源内核模块不支持 Maxwell/Pascal/Volta,必须装专有 R580;R580 安全更新两份官方文档一个写 2028 年 6 月、一个写 10 月——买卡前先确认自己跑哪个平台。
- 对中国 IT 运维/开发者:国内二手市场 P5000 价格与这个美元价基本同温,”16GB 显存 + 双路 Xeon 大内存”的组合恰好是 MoE 卸载玩法的最优解——30B-A3B 这类激活参数小的 MoE 模型放老卡 + 内存跑,比追新卡省钱。但按原文口径:要单用户快、要 FP16、要 vLLM 的,直接 Turing 起步,别在 Pascal 上赌。
参考
- 原文(PCSP News,2026-10-21,Konstantin Protasov):https://pcserverandparts.com/news/lm-studio-vs-ollama-hardware-2026
- Ollama 硬件页 / CMakePresets.json / release notes(2026-10-18 核对)
- LM Studio 系统要求 / changelog / bug tracker issues #424、#2354、#2316、#1758(用户报告,无官方确认)