老卡跑新模型:RTX 3090 六款开源大模型实测,速度与显存全记录
说明:原文无内文配图,三张正文图(速度/显存/卡对比)由本文实测数据表绘制;封面沿用文章自身头图(与内容强相关),另有小红书竖版封面 cover-xhs.png。
测试是怎么做的
平台是一台桌面级 RTX 3090(24,576 MiB 显存),驱动 580.65.06,跑官方 CUDA 12.8 版 llama.cpp b10988,二进制内置针对 Ampere 的 sm_86 内核。主配置为全量 GPU 卸载、单并行槽、fp16 KV cache。速度测试用 llama-bench 处理 4,096 token 提示词并生成 128 个新 token。六款里五款共用这套主基准,Ternary Bonsai 2 走独立的 Prism llama.cpp 分支(b10709),单独测试。
长上下文测试用约 8k / 32k / 128k 的文档,事实埋在开头、中间、结尾,外加一道需要跨两处信息的问题。所有能装下 128k 测试的模型,四道事实题全部答对。
六款模型主数据表
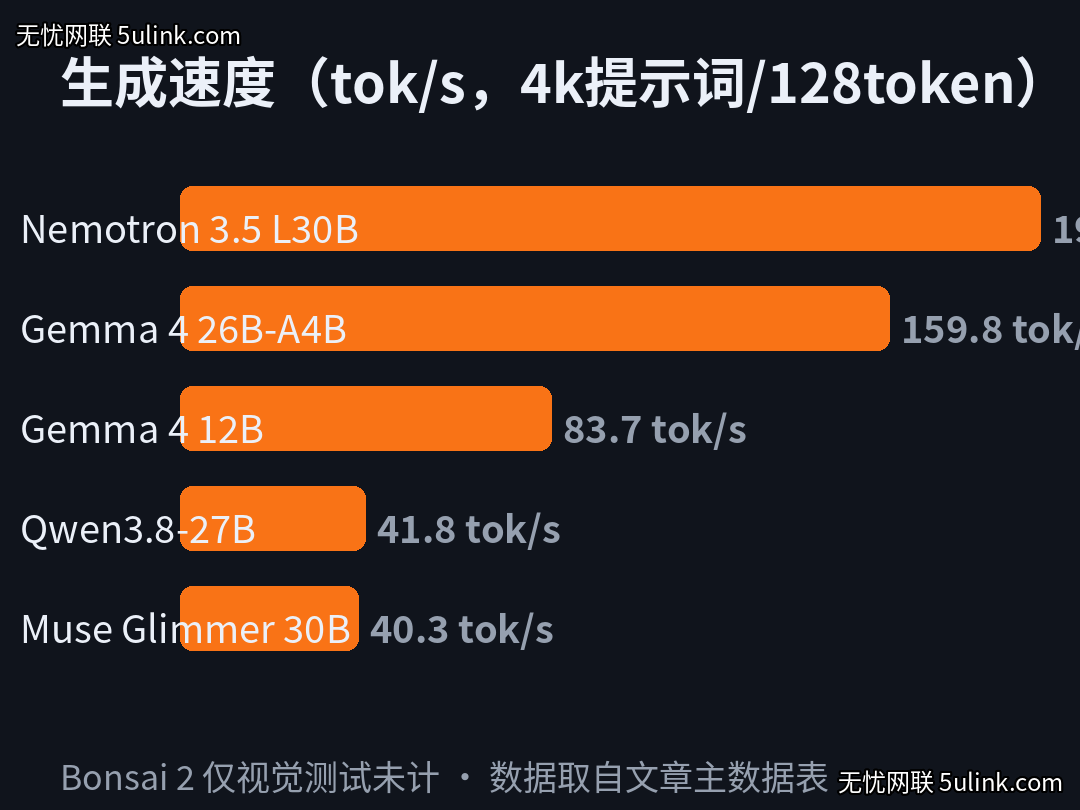
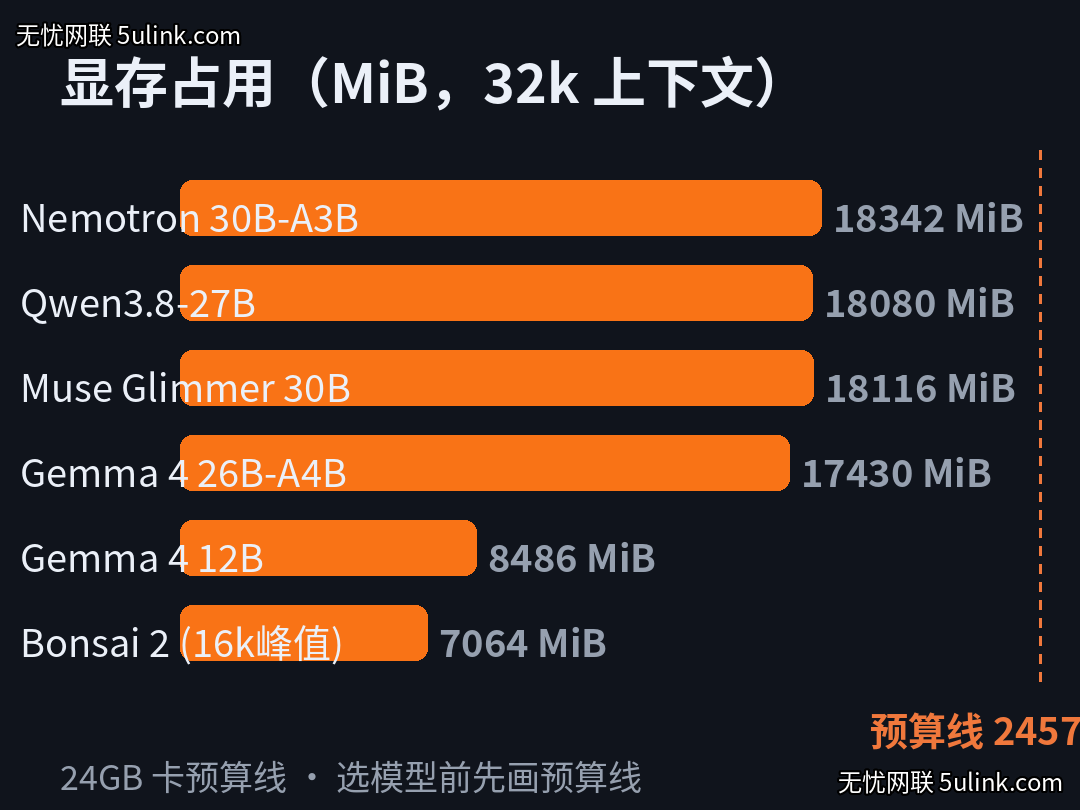
| 模型 | 量化 | 文件大小 | 显存(32k;Bonsai 为 16k) | 4k 提示词 | 生成速度 | 定位 |
|---|---|---|---|---|---|---|
| Gemma 4 26B-A4B it | Q4_K_M | 15.64 GiB | 17,430 MiB | 4,506 tok/s | 159.8 tok/s | 综合第一 |
| Ternary Bonsai 2 27B | PTQ1_0 | 5.54 GiB | 7,064 MiB 峰值 | 未测 | 仅视觉测试 | 最小体型 |
| Qwen3.8-27B | AD-Q4_K_M | 15.94 GiB | 18,080 MiB | 1,296 tok/s | 41.8 tok/s | 编程候选 |
| Nemotron 3.5 Lightning 30B-A3B | AD-IQ4_NL | 18.30 GiB | 18,342 MiB | 4,239 tok/s | 193.7 tok/s | 长对话最快 |
| Gemma 4 12B it | Q4_K_M | 6.87 GiB | 8,486 MiB | 2,991 tok/s | 83.7 tok/s | 省显存 |
| Muse Glimmer 30B | AD-Q4_K_M | 17.75 GiB | 18,116 MiB | 1,492 tok/s | 40.3 tok/s | Agent 向 |
几个值得展开的点:
- Gemma 4 26B-A4B 是 25.2B 参数的 MoE,每 token 只激活约 3.8B 参数(128 选 8 专家 + 共享专家),这是它速度远超同体量稠密模型的原因。代价是长提示词延迟:128k 文档首 token 要等 59.3 秒。
- Nemotron 3.5 Lightning 用 Mamba-2 + attention + MoE 混合架构,从 32k 升到 192k 上下文显存只多花 1,119 MiB,192k 时仍剩 5 GB 余量,适合长对话与 Agent 工作流。
- Ternary Bonsai 2 是 Qwen3.8-27B 的三值压缩版(约 1.75 bit/权重),27B 模型塞进 5.54 GiB 文件,显存峰值与最小的 12B 模型相当,但必须跑 Prism 分支的独立 server,标准 llama.cpp 不支持其 PTQ1_0 格式。
- Qwen3.8-27B 在 96k 就撑爆 fp16 KV cache,把 KV 换成 q8_0 才装得下 128k(20,951 MiB)和 192k(23,447 MiB)。
- Gemma 4 12B 只占 8,486 MiB,给其他应用留了约 15.7 GiB,速度不算最快(83.7 tok/s)但日常聊天完全够用。
现场测试:写贪吃蛇和弹球物理
给六款模型两道视觉编程题:一道自动寻食成长的贪吃蛇,一道五球重力+弹性碰撞的物理模拟,要求各自返回一个自包含 HTML 文件,报错后把浏览器错误回传给模型修正。测试于 2026 年 9 月 19-21 日在另一台 3090 主机上跑(驱动 590.48.01,16k 上下文,seed 42)。
贪吃蛇:只有 Gemma 4 12B 和 Muse 一次成功,但六款最终都做出了能玩的游戏。Nemotron 折腾了五次,总生成时间却是最短的 68.4 秒。
弹球:Gemma 4 26B-A4B、12B、Muse、Bonsai 2 均一次通过;Nemotron 前几版把碰撞冲量符号写反,小球互相加速卡在角落,第四版才修对物理。最快完成 36.1 秒(26B-A4B)。
3090 vs 4090 vs 5090
同名的 GGUF 构建、同样的 4k 提示词/128 token 生成负载:
| 模型与指标 | RTX 3090 | RTX 4090 | RTX 5090 |
|---|---|---|---|
| Qwen3.8-27B 提示词处理 | 1,296 tok/s | 3,004 tok/s | 3,830 tok/s |
| Qwen3.8-27B 生成 | 41.8 tok/s | 48.5 tok/s | 74.2 tok/s |
| Gemma 4 26B-A4B 提示词处理 | 4,506 tok/s | 9,970 tok/s | 11,829 tok/s |
| Gemma 4 26B-A4B 生成 | 159.8 tok/s | 194.1 tok/s | 248.6 tok/s |
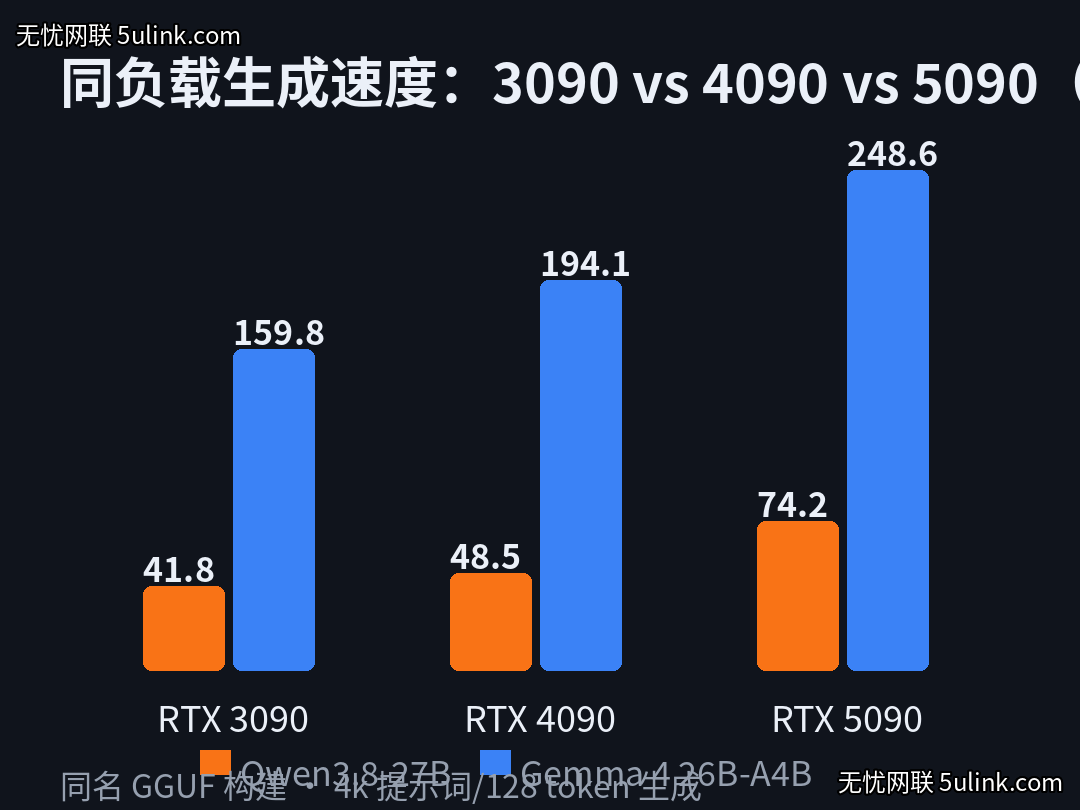
结论很直白:4090 读大提示词快 2.2-2.3 倍,但生成速度只领先 14-18%。3090 与 4090 同为 24GB,模型预算基本一致;5090 的 32GB 才能装下更大的模型。双 3090 有 48GB 物理显存,但两张卡不会变成一张 48GB 的卡——卡间通信会拖慢速度,可用容量取决于运行时的切分策略。
小夏点评
- MoE 是老卡的救命稻草:26B-A4B 能在 3090 上跑出 159.8 tok/s,靠的是每 token 只激活 3.8B 参数。老卡+MoE 量化组合的性价比,正在把”本地大模型”从玩具变成生产力。
- 显存表比速度表更重要:六款模型在 32k 上下文的显存占用从 7GB 到 18GB 不等,24GB 卡的真实瓶颈是”装下模型+装下上下文”的总预算,选模型前先画自己的预算线。
- 给国内玩家的启示:国内二手 3090 保有量巨大,这张实测表基本可以直接当选型手册用——追求速度选 Nemotron,追求综合选 Gemma 26B-A4B,显存紧张选 12B 或 Bonsai 2,别为 4090 多付的钱只买到 15% 的生成速度。
参考链接
- 原文:Best Local LLMs for RTX 3090: 6 Models Tested(2026-09-21)
- Gemma 4 26B-A4B:google/gemma-4-26B-A4B-it
- Ternary Bonsai 2:prism-ml/Ternary-Bonsai-2-27B-gguf
- Nemotron 3.5 Lightning:nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4