GPU 共享三层省钱账:Time-Slicing + Spot + 承诺折扣,叠加省 76%
问题:整卡分配 + 闲置
文章的起点是两个浪费源:闲置分配和刚性调度。一个数据科学家在 p4d.24xlarge(8×A100,$32/小时)上跑 4 小时训练,实例再闲置 6 小时没人发现——$192 蒸发。推理侧同样:轻量模型平均只用 15% 算力,电表按 100% 计费。文中引用 ScaleOps 的 2026 数据:生产 K8s 环境里跑轻量模型的 GPU 利用率常年在 0-10% 区间。
K8s 默认把 GPU 当不可分割单位:Pod A 申请 1 张卡就占整张,哪怕只用 20% 显存;Pod B 只能去别的节点或排队。共享技术(time-slicing、MIG、DRA)让同一张物理卡跑 2-10 个 Pod。
四种方法怎么选(原文对比表)
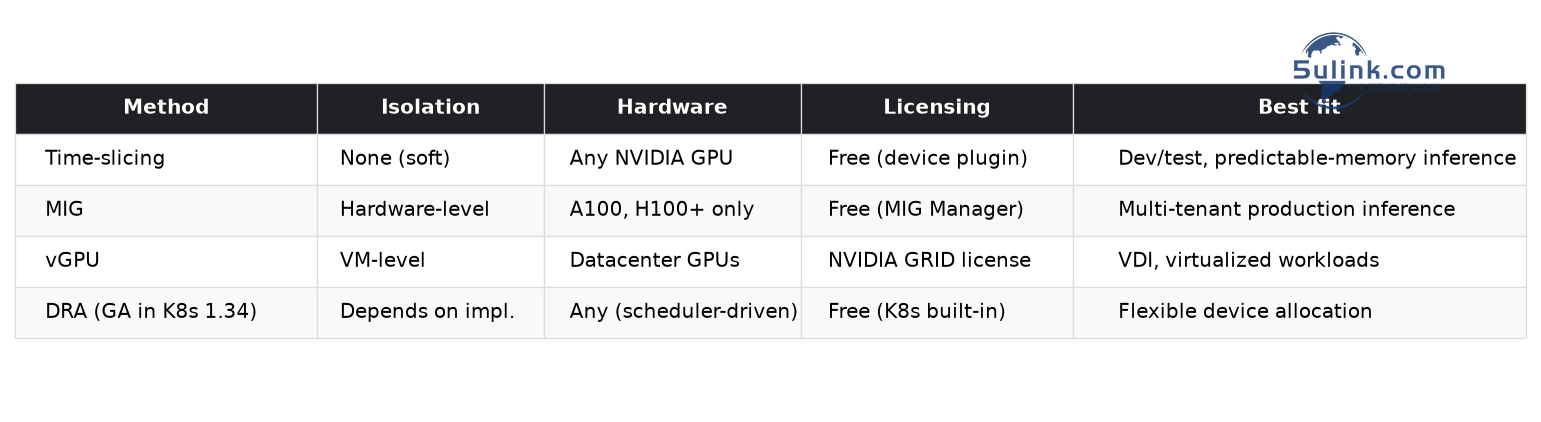
图:Time-slicing / MIG / vGPU / DRA 对比(图源:原文表格)
三笔实测账
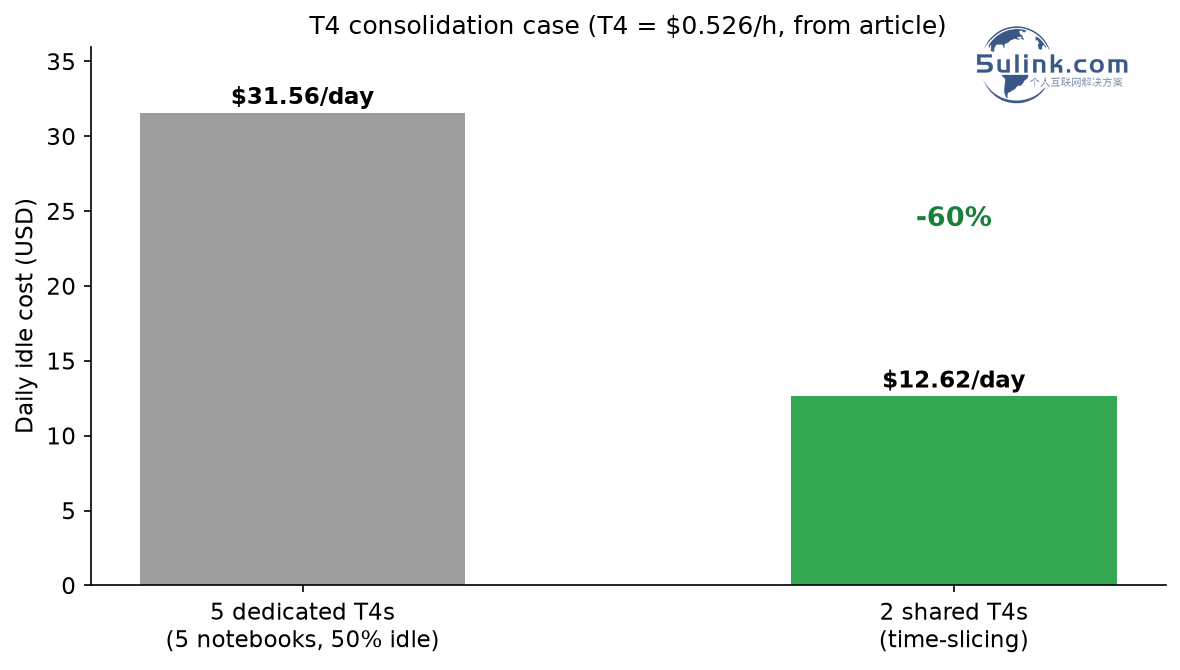
图:5 个数据科学家各占一张 T4($0.526/h,50% 闲置)= $31.56/天 → 合并到 2 张共享 T4 = $12.62/天(图源:原文)
Dev 环境自动停机:dev 节点一周跑 168 小时,改成每周只开 50 小时,GPU 成本直降 70%。实现:Karpenter consolidation、CronJob 晚 6 点缩到 0 早 8 点扩回、DCGM Exporter 监控利用率 <10% 持续 15 分钟即告警回收。 单位经济学:1 张 T4 每小时服务 10,000 请求,单位成本 $0.0526/千次推理;4 个同规模服务通过 time-slicing 共享这张卡后降到 $0.0132/千次,-75%。
三层叠加:$10,000 → $2,400
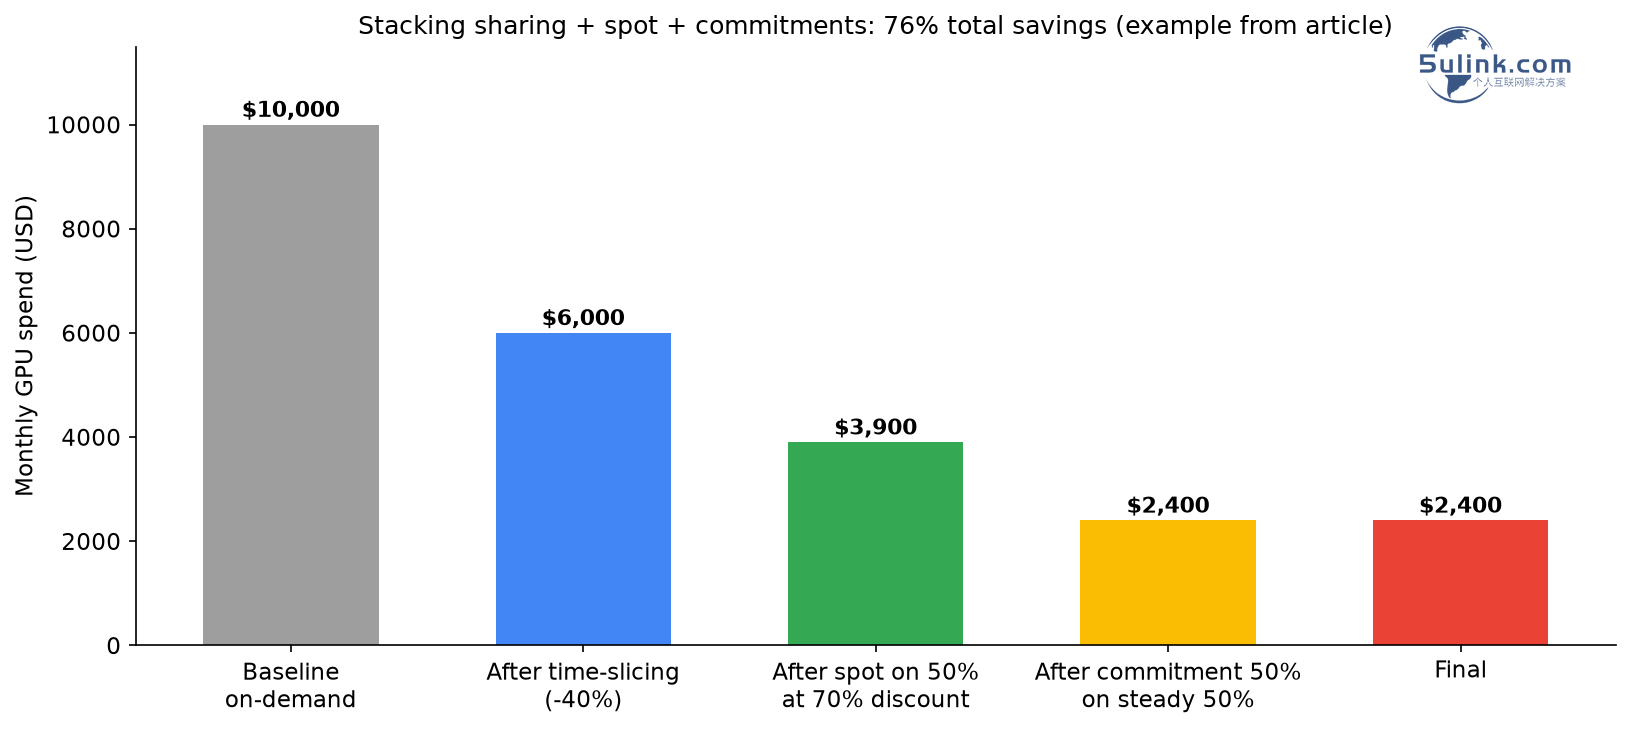
图:原文示例账单——基线 $10,000/月 → time-slicing 省 40% → spot 覆盖 50% 工作量(70% 折扣)→ 稳态部分上承诺折扣 → $2,400/月,总省 76%(图源:原文)
原文给的组合拳:共享减 30-50% 用量,spot 砍 60-70% 单价(可 ~2 分钟通知中断,checkpoint + on-demand 兜底),承诺折扣对稳态基线再打 40-60%(建议 60-80% 稳态负载上承诺,剩余留给 spot)。叠加后总降幅 70%+ 是常态。
注:来源是 nOps 官方博客(厂商视角,文末有其自家 Commitment Management 推销),但文中成本算例和对比数据完整可复核。