AI Agent 生产可观测:让 Collector 砍掉一半存储,数据还全
把 AI 编码 Agent 的遥测打开,它甩给你的是一堵字墙:存储贵,更糟的是看不懂。好在这些都是 OpenTelemetry 原生的,可以在 Collector 里先整形再入库。剩下的问题只有一个:你到底需要什么?
需求不是少采,是留下能回答问题的部分
作者给 Claude Code 派了个小活:修两个挂掉的测试、补几个边界测试。全程内容开关打开,这一次运行产出了 181 条遥测记录、289KB JSON。而他真正要的只是六个答案:
| 问题 | 靠什么回答 |
|---|---|
| 每个模型花了多少钱 | claude_code.cost.usage |
| 每个会话多少 token、缓存占多少 | claude_code.token.usage 按类型 |
| 哪些工具失败、多久失败一次 | tool_result 事件的 success |
| 大家在拒绝 Agent 的修改吗 | tool_decision 事件 |
| 延迟在哪 | llm_request span 的 ttft_ms |
| 什么坏了 | api_error 事件、error_class |
每个答案都是一个计数器或短属性,提示词、文件正文、diff 都不需要。没有任何仪表盘、告警或查询在读的字段,就不算可观测,只是花钱建索引的存储。
量到底堆在哪
Agent 跑的是一个循环:提示、模型调用、工具调用、结果、决策、重复。一次交互是一个 claude_code.interaction span,每个模型轮次挂一个 llm_request 子 span,每个工具调用挂一个 tool 子 span。开了 OTEL_LOG_TOOL_CONTENT 之后,每个工具 span 都会带一个装着工具全部返回内容的 tool.output 事件。
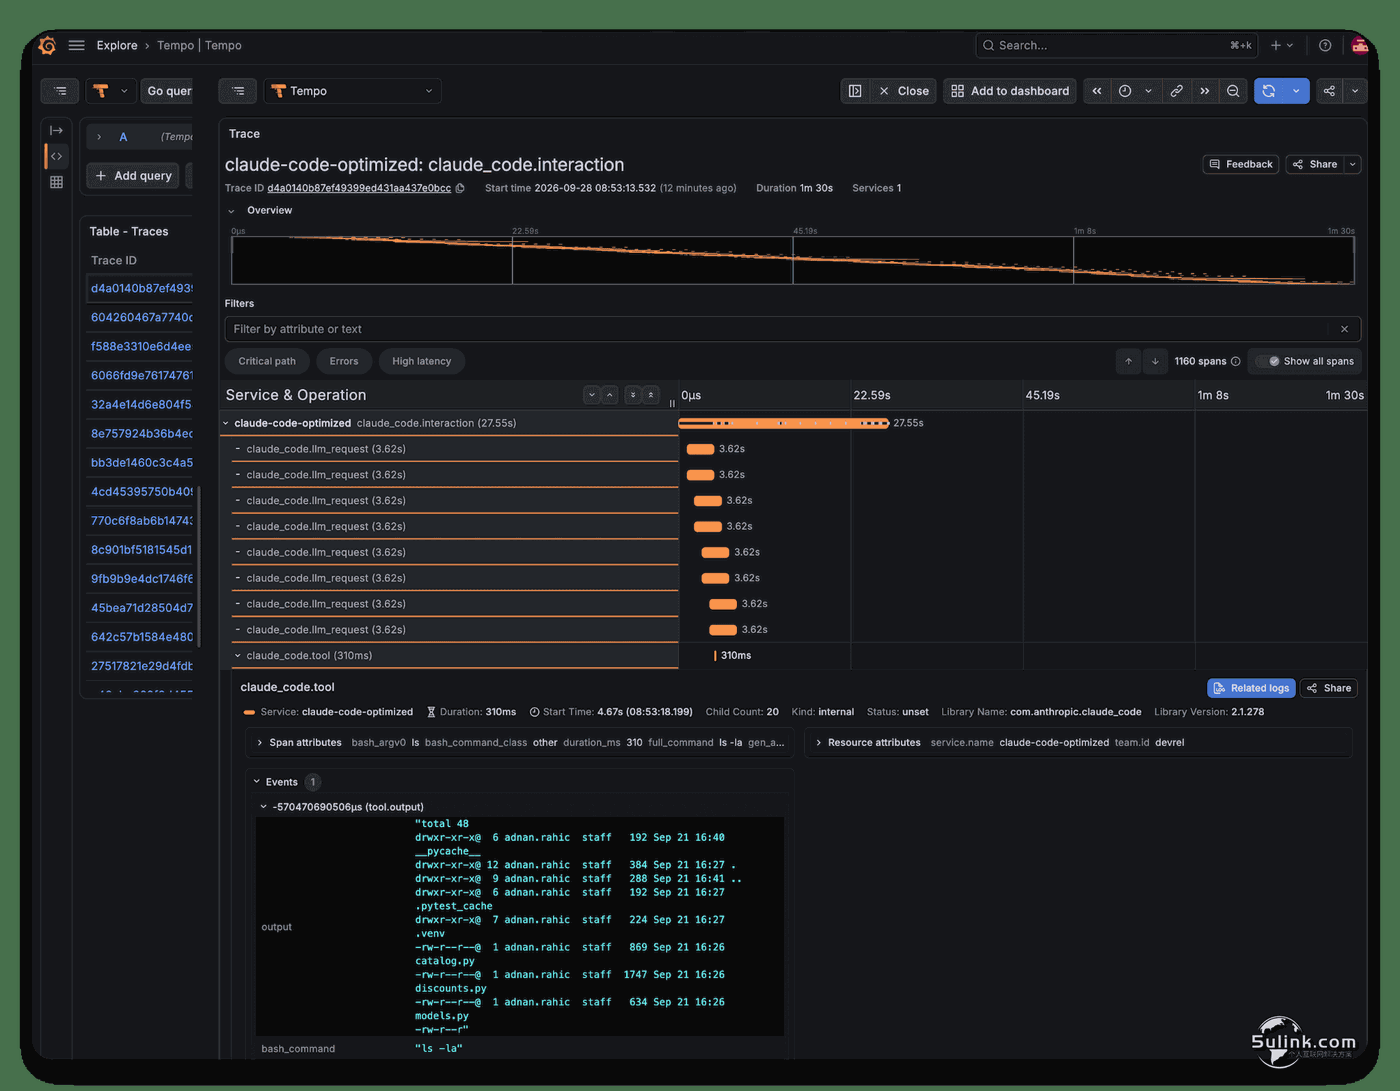
那只是目录列表。工具是 Read 时,事件就是整个文件——40KB 的文件变成 40KB 的 span 事件。日志同理:tool_result 和 tool_decision 带着完整工具参数,一次 Write 就是整个文件,和 span 事件同一份内容存两遍。
指标的问题则是身份维度:每个数据点都带 session.id、user.id、user.email 和两个账号 ID,每个新会话都生成一套永不消失的时间序列——25 个会话就造出 300 条时间序列,对应 8 个指标。默认插桩是为单开发者调试单次运行写的,放到每天 200 个会话就全错了。Agent 不会为你改默认值,所以管线必须改。
管线设计:同一份输入,两条通道
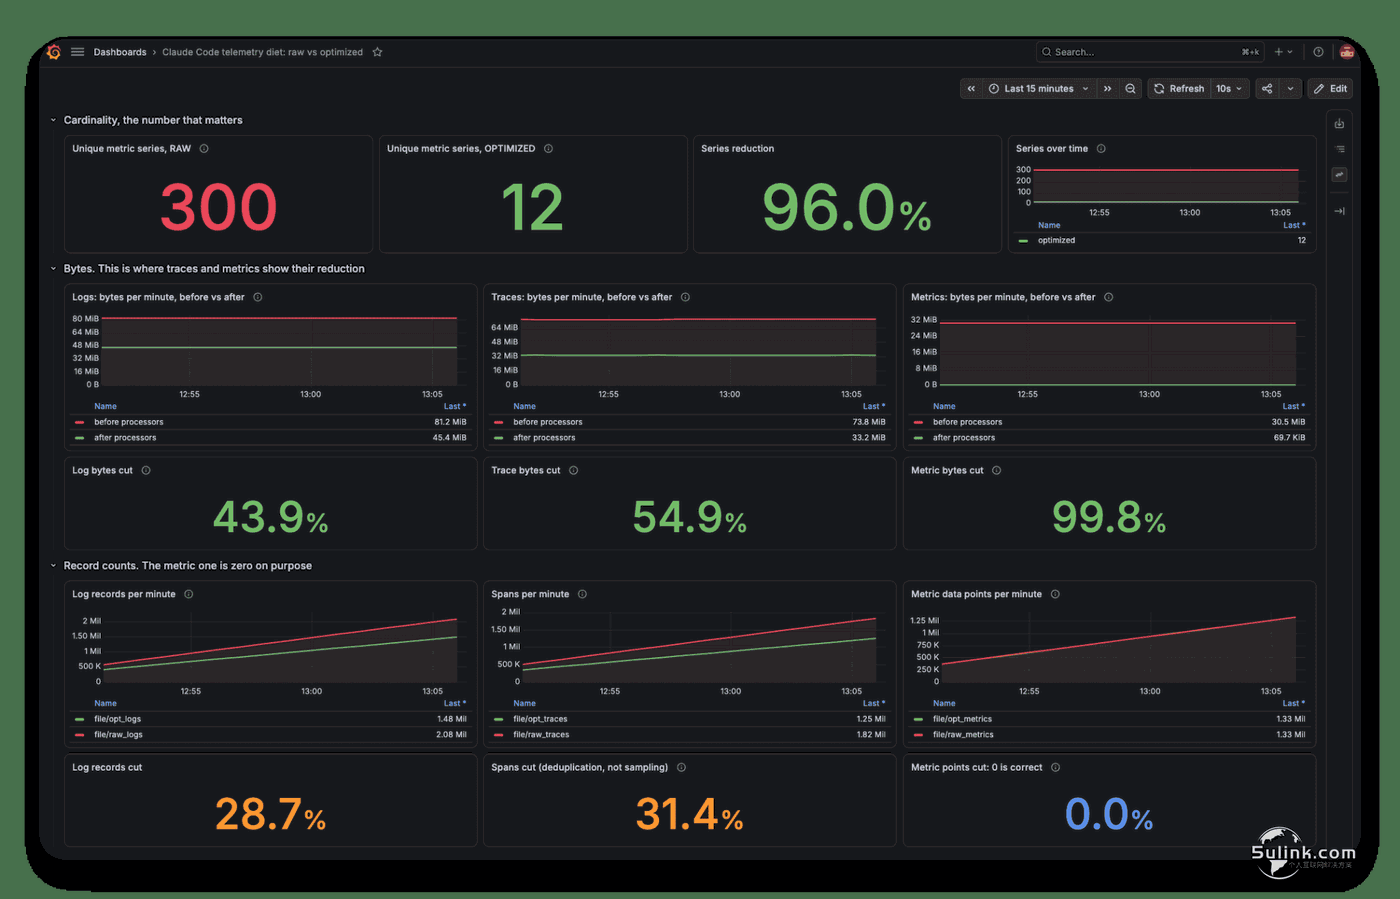
一个 OTLP receiver 吃进 Claude Code 的内部遥测,每类信号分成两条管线:raw 原始通道只带 batch 处理器,optimized 优化通道装上要加的处理器,六条管线全部落进同一个 Grafana LGTM 容器。raw 通道是对照组——同一个 receiver 喂两边,输入逐字节相同,对照才诚实。一个仪表盘同时读两边并排画:红线原始、绿线优化,看卡片数、每分钟字节数、记录数,两条线之间的差就是你省下的存储费。
生产环境里 raw 通道应该指向对象存储或直接砍掉,这里指向 Grafana 只是为了看差距。
日志:删事件、删字段、哈希、截断
删事件:api_request 只贡献模型名和请求 ID,其余字段别的信号里都有,整个事件删掉——约占日志记录的四分之一。
删字段:每条记录删 6 个属性,大头是 tool_parameters;prompt_length 和 response_length 留着,不看正文也能看体量趋势。
哈希与截断:session.id 和 user.id 哈希、error 截到 256 字符。注意哈希要截——完整 SHA256 是 64 字符,比原来 36 字符的 UUID 还长,每条记录还出现两次,作者第一次跑完日志字节不降反升,截到 16 个十六进制字符才对了。这一套下来,日志字节大约减半。
指标:把维度删掉,问题就不是字节是卡片数
每个数据点删 6 个属性后,300 条时间序列变 12 条,无论内容开关开没开。剩下的活是把会话聚合掉:Claude Code 导出 delta 时间性、Prometheus 要 cumulative,所以 delta_to_cumulative 必须放在管线最后;先按窗口攒 2 秒、把同名指标归到一个资源、给窗口内所有点同一时间戳再求和,然后才转换。优化后的总量与原始值误差在半个百分点以内。前提是全网只有一个 Collector 看到所有会话——负载均衡后面它得站在单一网关上。指标是字节降幅最大的信号:每个点上那 6 个属性占了载荷大头。
链路:修剪,别急着采样
链路是最大的流,也是大家最想第一个下采样刀的地方,作者用了一个过滤器加两个 transform 代替:
每个 span 都活着,ls -la 还看得全,40KB 的文件读就不行了——这就是目的。链路字节因此大约减半,且没有用采样。 真要再加一刀才上 tail sampling:保留错误、60 秒以上的慢链路,其余按 10% 概率采——但采样会把”把某人问的那次具体运行调出来”这个链路最核心的用途交易掉,Agent 交互动辄跑几分钟,tail_sampling 的 decision_wait 之后才决策,第三分钟才失败的调用永远赶不上判决。
证明你没丢掉需要的东西
质疑永远是那句”我们丢数据了”,那就验证:Collector 打开 detailed 自遥测,两条通道分别打标,仪表盘三张图——按 pipeline 分组的卡片数、每条管线的每分钟导出字节、每条管线的记录数。
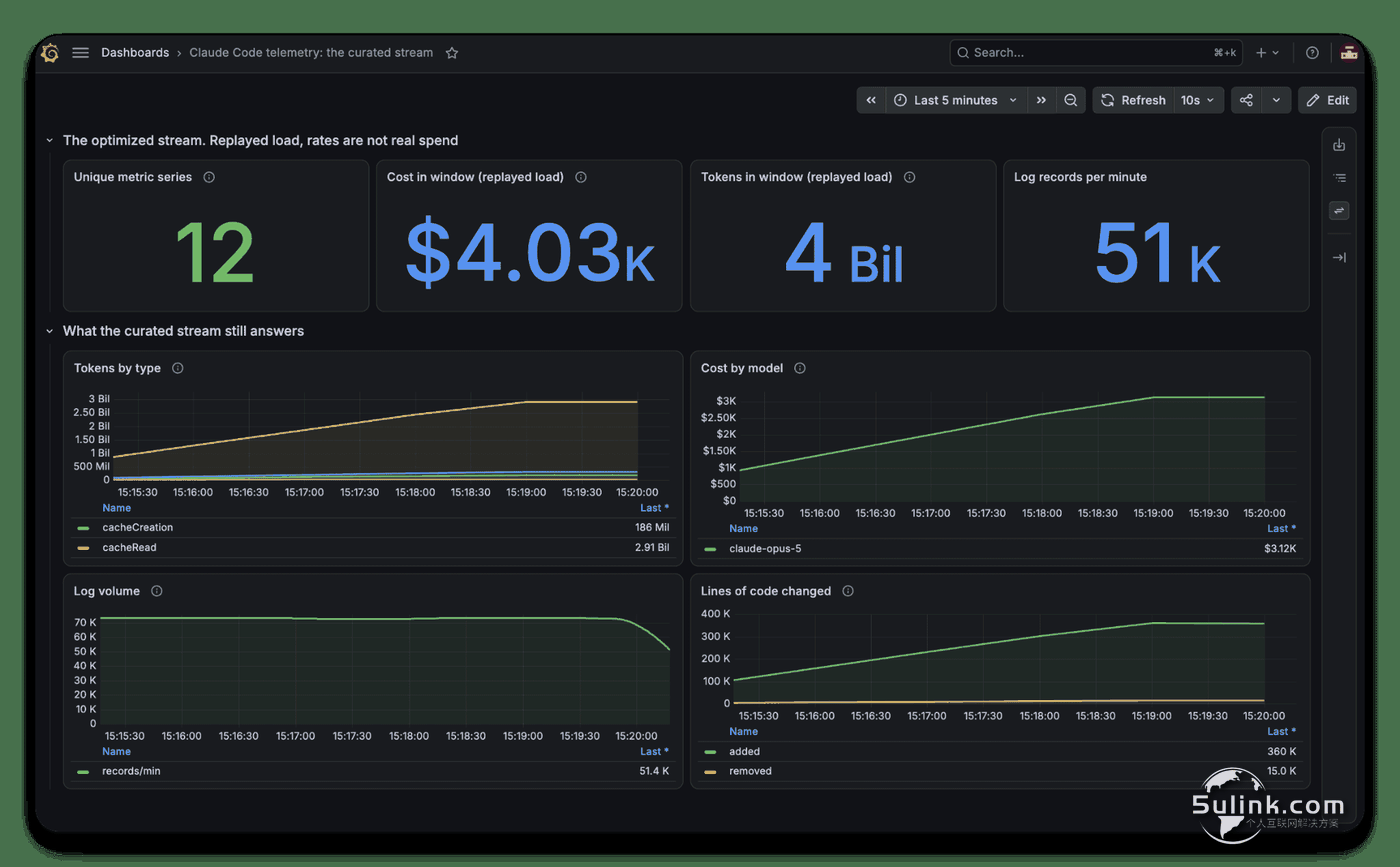
上排卡片数:原始 300、优化 12。真实舰队里红线随每个会话上爬,绿线是平的,因为已经没有按会话的维度可长。中排是每条信号每分钟字节,差值就是不再付的钱。下排是记录数:日志少了 api_request,链路少了成功的 tool.execution,指标是预聚合过的——没有一样是采样丢的。第二张仪表盘只读优化流,按类型看 token、按模型看成本、日志量、增删行数,12 条序列,每个面板都有数,六个问题全答上。
把 Agent 遥测当成”全是提示词、没法做仪表盘”是个误解——约束比想象窄。后端不需要逐字对话记录,只需要六个答案。
小夏点评
参考: