MI355X 单请求解码提速 3.3 倍:榨出交互速度的四个开关
推理这件事正在改变性质。吞吐榜单拼的是并发下的 tokens/s,但用户真正感知到的是单条对话里每一个 token 出来的速度——尤其是 agent 和多轮推理普及之后,”每次调用只来一个请求”是常态。AMD 这次在 ROCm 博客上把单请求(batch 1)场景的优化路径完整摊开:persistent megakernel、投机解码、低精度数据格式、跨 die 数据驻留四个开关一起拨,在单卡 MI355X 上把三个模型的解码速度拉到基线的 1.9–3.3 倍,并且每个数字都给了复现脚本。
先把结论放前面
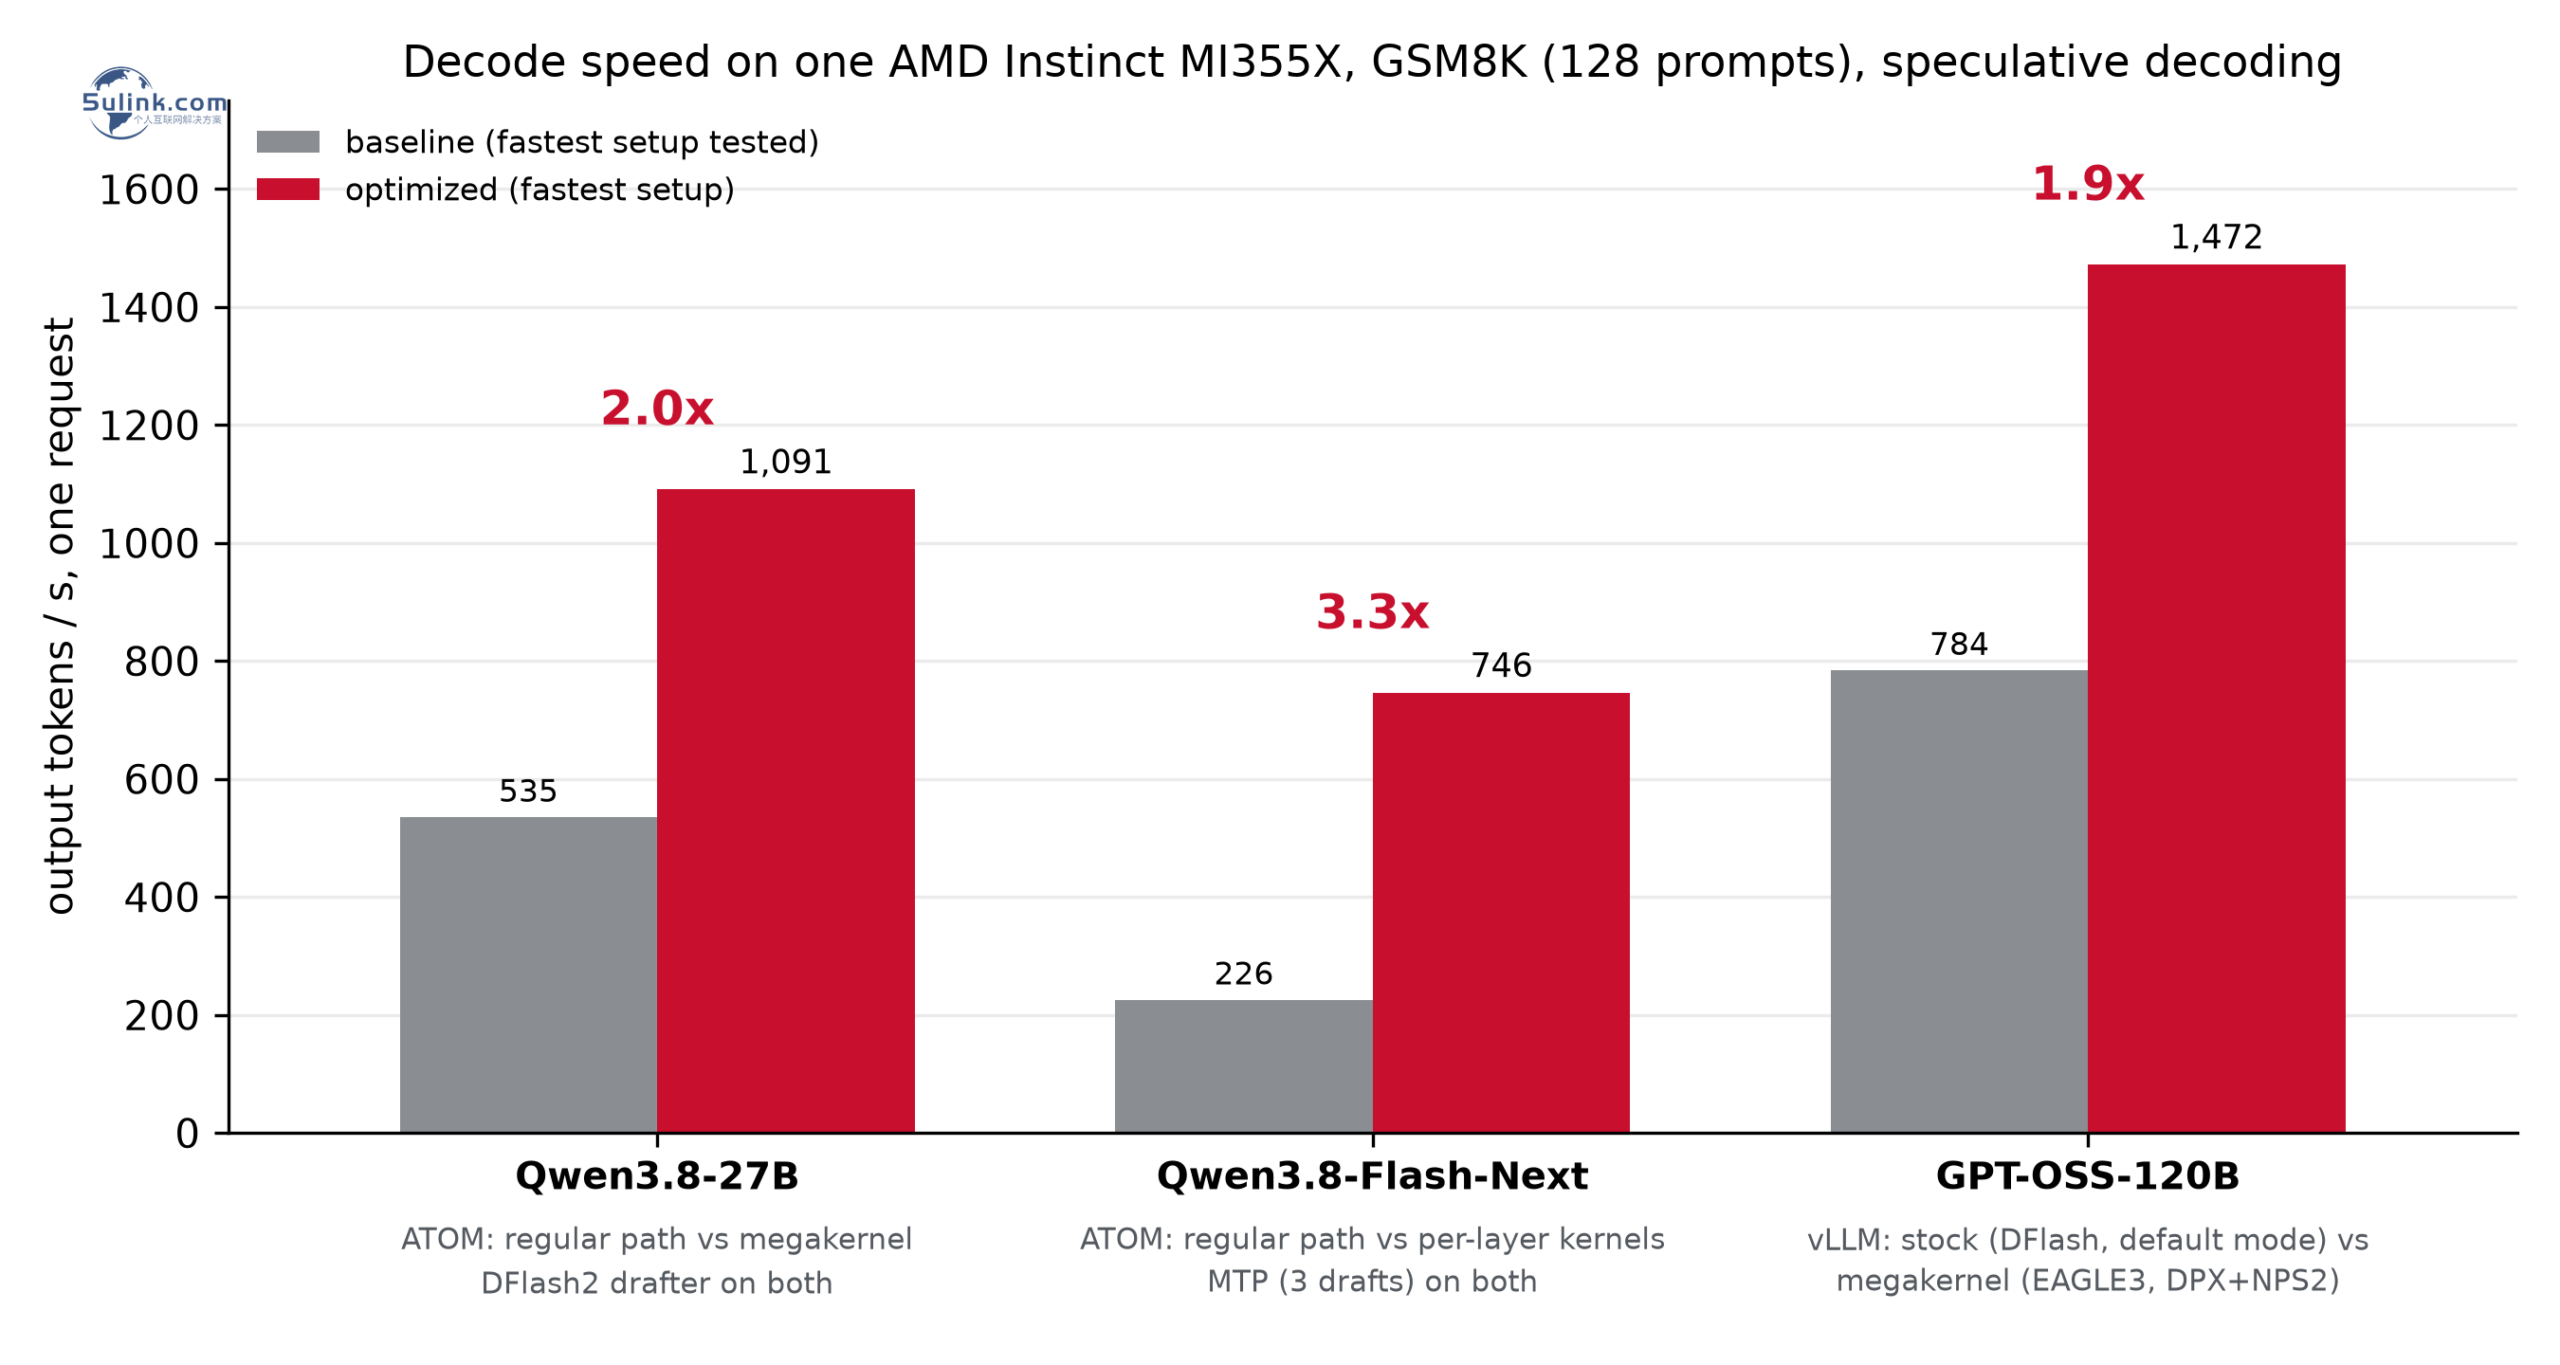
单请求、GSM8K、各自最快配置、带投机解码,实测结果:
| 模型 | 优化路径 | 对照基线 | 加速 |
|---|---|---|---|
| Qwen3.8-27B(ATOM,同权重同 drafter) | 约 1,100 tokens/s(GSM8K/HumanEval/MT-Bench:1,091/913/824) | 535/443/412 | 2.0x |
| Qwen3.8-Flash-Next(ATOM,MTP 3 drafts) | 约 750 tokens/s(每轮 4.27ms vs 基线 14.10ms) | ATOM 常规路径 | 3.3x |
| GPT-OSS-120B(vLLM 插件,完整配置对比) | 约 1,470 tokens/s | stock vLLM 最快配置 784 | 1.9x(同 drafter 口径 1.6x) |
还有一个来自芯片结构的红利:MI355X 是双 die 设计,每个 die 各带一半 HBM。以”每 die 一个逻辑设备”方式运行(DPX+NPS2)时,GPT-OSS-120B 的数据可以完全驻留在本 die 内存里,光数据放置就快 7.5–8%,与投机解码叠加能到 16–20%。
开关一:megakernel,把启动开销整批消掉
常规执行路径里,每一层的每个算子都是独立 GPU kernel,一个 token 要穿过几百个,每个都带启动和同步开销——单请求模式下没有任何并发能把这些开销藏起来。megakernel 的做法是persistent 化:每个计算单元驻留一个 workgroup,workgroup 之间直接通过内存交接数据,整个 forward pass 编成一个 kernel(Flash-Next 是每层一个,层间约 1.7µs 的边界是全场唯一的 grid 级同步)。
内部的细节更值得抄:大部分阶段边界是生产者-消费者交接——数据值和序号标签打包进一次 64 位写入,消费者只轮询自己需要的那个值;per-chiplet release word 把大部分轮询留在本地缓存;空闲计算单元在下一阶段输入到达之前预取权重。Flash-Next 的稀疏注意力对上下文逐块打分取 top 512,把打分拆成并行块再合并胜者后,25 万 token 上下文下一个稀疏注意力层从 262µs 压到 126µs——整个 250K 上下文下每 token 从 10.2ms 降到 3.0ms。
Qwen 系列的 megakernel 用 FlyDSL(Python DSL,编译到 AMD GPU 代码)写,起点是 HIP C++ 代码——AMD 明说这套路径经过”数百轮优化实验,工程师和 AI 编码代理共同完成”。
开关二:投机解码,让闲着的算力干活
单 token 解码时 GPU 大部分算力闲着:每步都要读全部权重只为产出一个 token。投机解码让小模型(drafter)先猜后面的几个 token,目标模型一次验证全部——每个 token 仍由目标模型决定,只是验证次数变少。Qwen3.8-27B 的实现里 DFlash2 drafter 每轮猜 7 个 token,GSM8K 上平均接受约 5.6 个;drafting、验证、接受、状态更新整条链被封成一个 GPU graph,全程不回 CPU。
两个方法论细节比数字更有价值。选 drafter 要量 tokens/ms,不能只看接受率——GPT-OSS-120B 上 DFlash 的 8-token 块接受率更高,但带置信门控的 EAGLE3(没把握就停止猜测)每轮短约 30%,整体反而更快。草稿长度也要分场景:数学这种步骤可预测的负载适合长草稿,密集对话文本额外接受率极低,一次猜 1 个反而最好。
开关三:低精度,直接压低每轮的地板
MXFP4 权重(每 32 个值共享一个缩放因子的 4-bit 格式)喂给 MI355X 的原生低精度矩阵指令,配合 MXFP8 激活,比 BF16 少读约 3.8 倍的权重要素字节。解码每轮都要读全部权重,所以权重读取时间是每轮耗时的地板,低精度就是在压低地板本身。但 AMD 自己也标了边界:基线跑的同样是 MXFP4 权重、远没贴到地板——是 megakernel 让每轮接近地板,投机解码把每轮摊到多个 token 上,三个开关是乘法关系不是加法。MXFP4 还有个实际收益:Flash-Next 和它完整的 26.2 万 token 缓存能装进单卡。
开关四:数据驻留,别每个读请求都跨 die
默认模式下所有 buffer 跨两个 die 分布,约一半的读取要走 die 间链路。DPX+NPS2 把一张物理卡暴露成两个逻辑设备,权重、KV 缓存、同步旗标全部留在本 die 内存。AMD 做了隔离变量的对照实验:同一个二进制,故意把每个 die 的权重搬到对面 die 的 HBM 里——每次跨 die 读权重,单个 token 解码时间拉长约 28%。
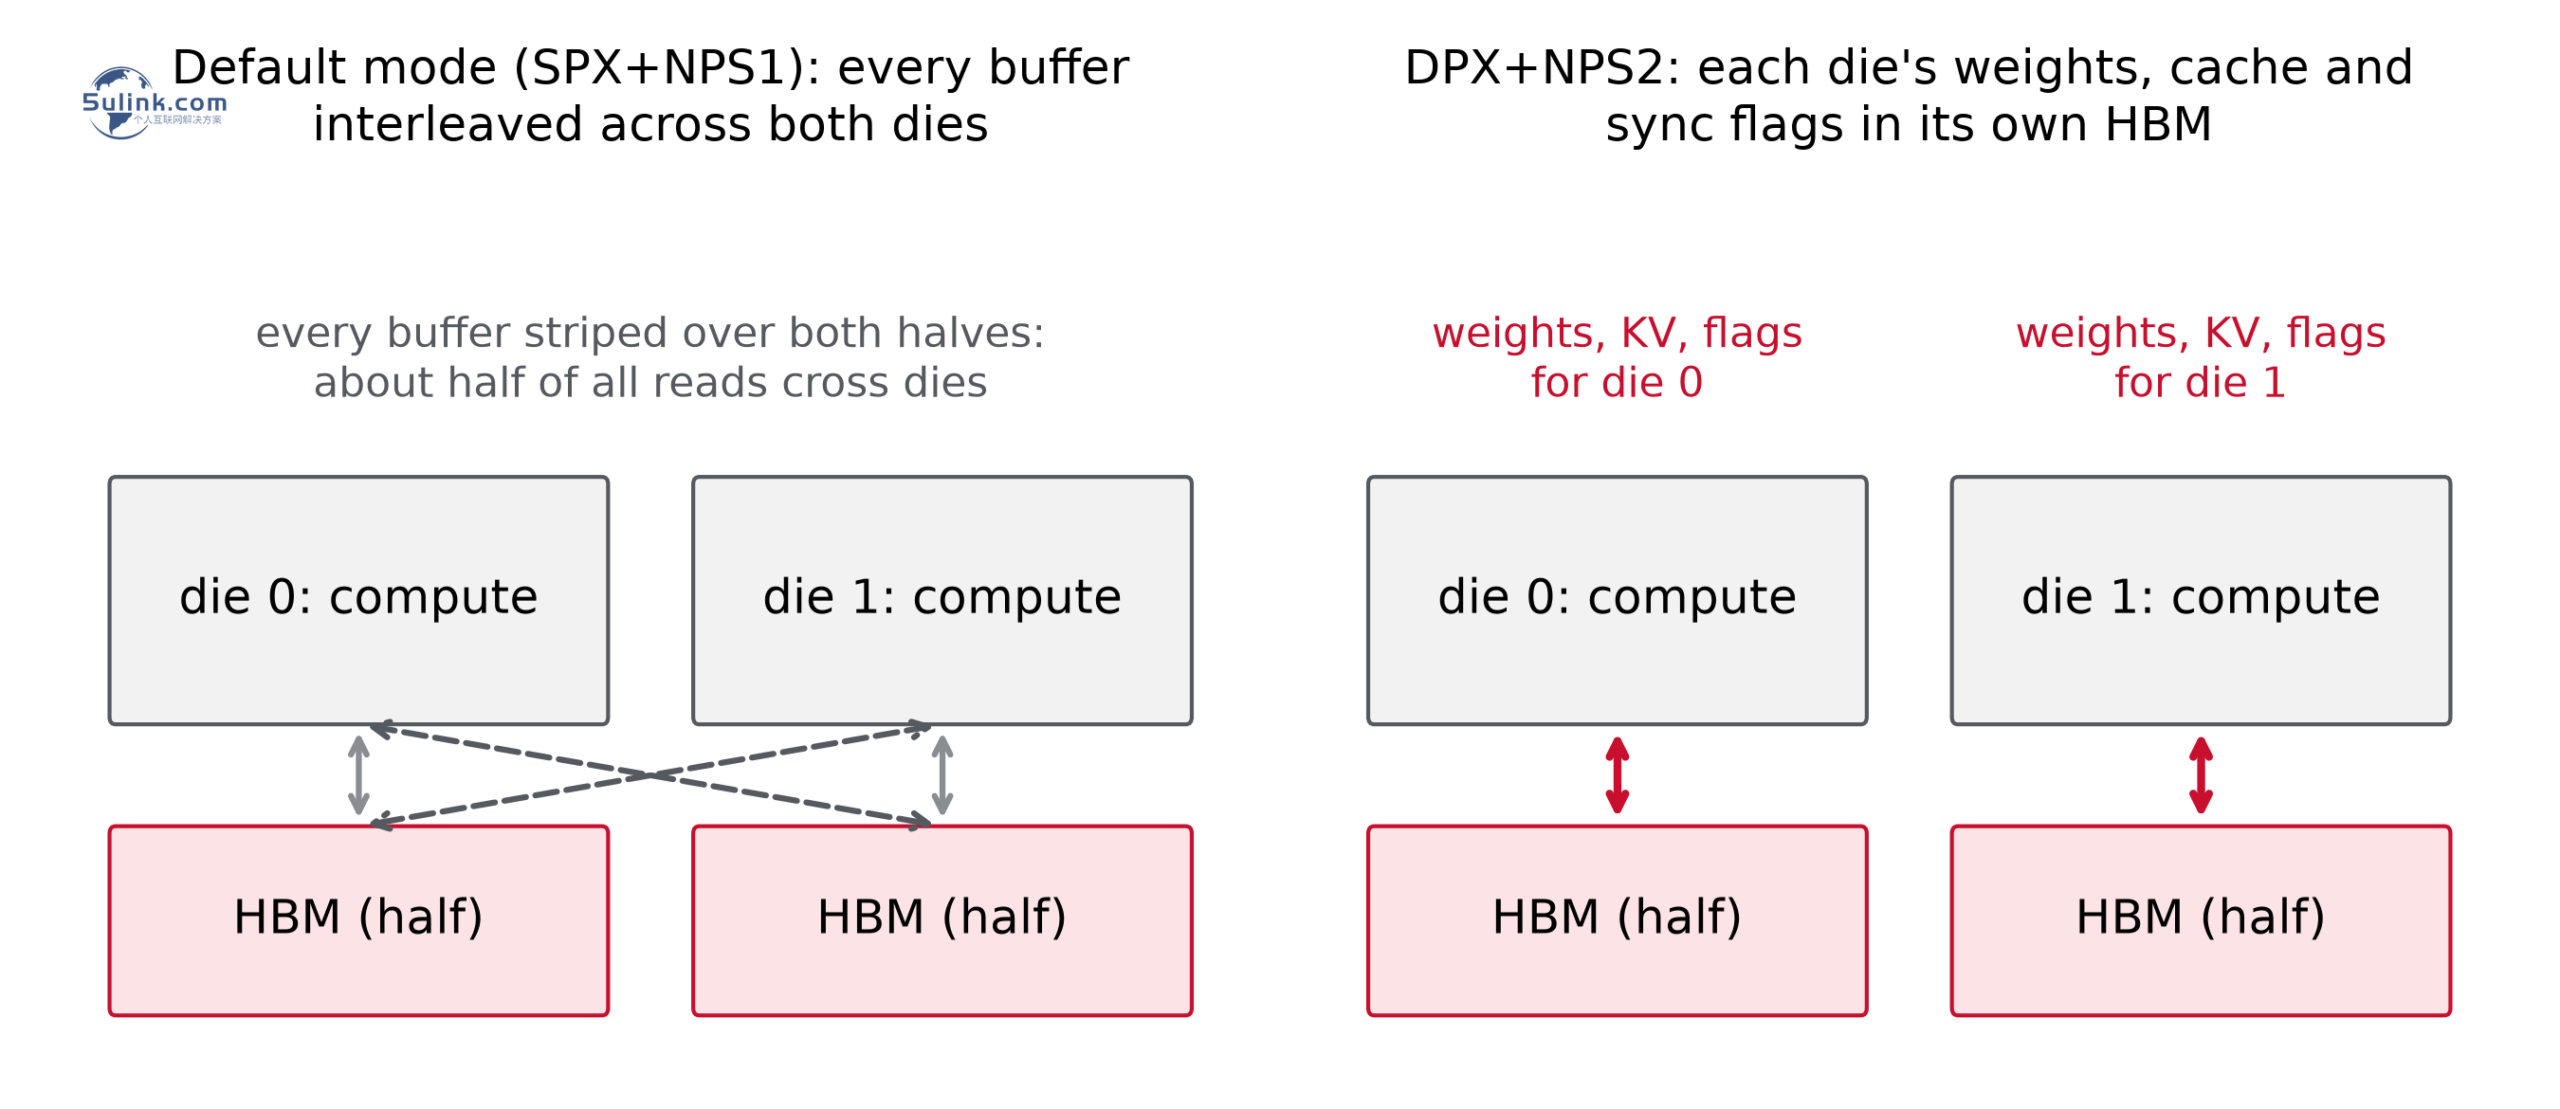
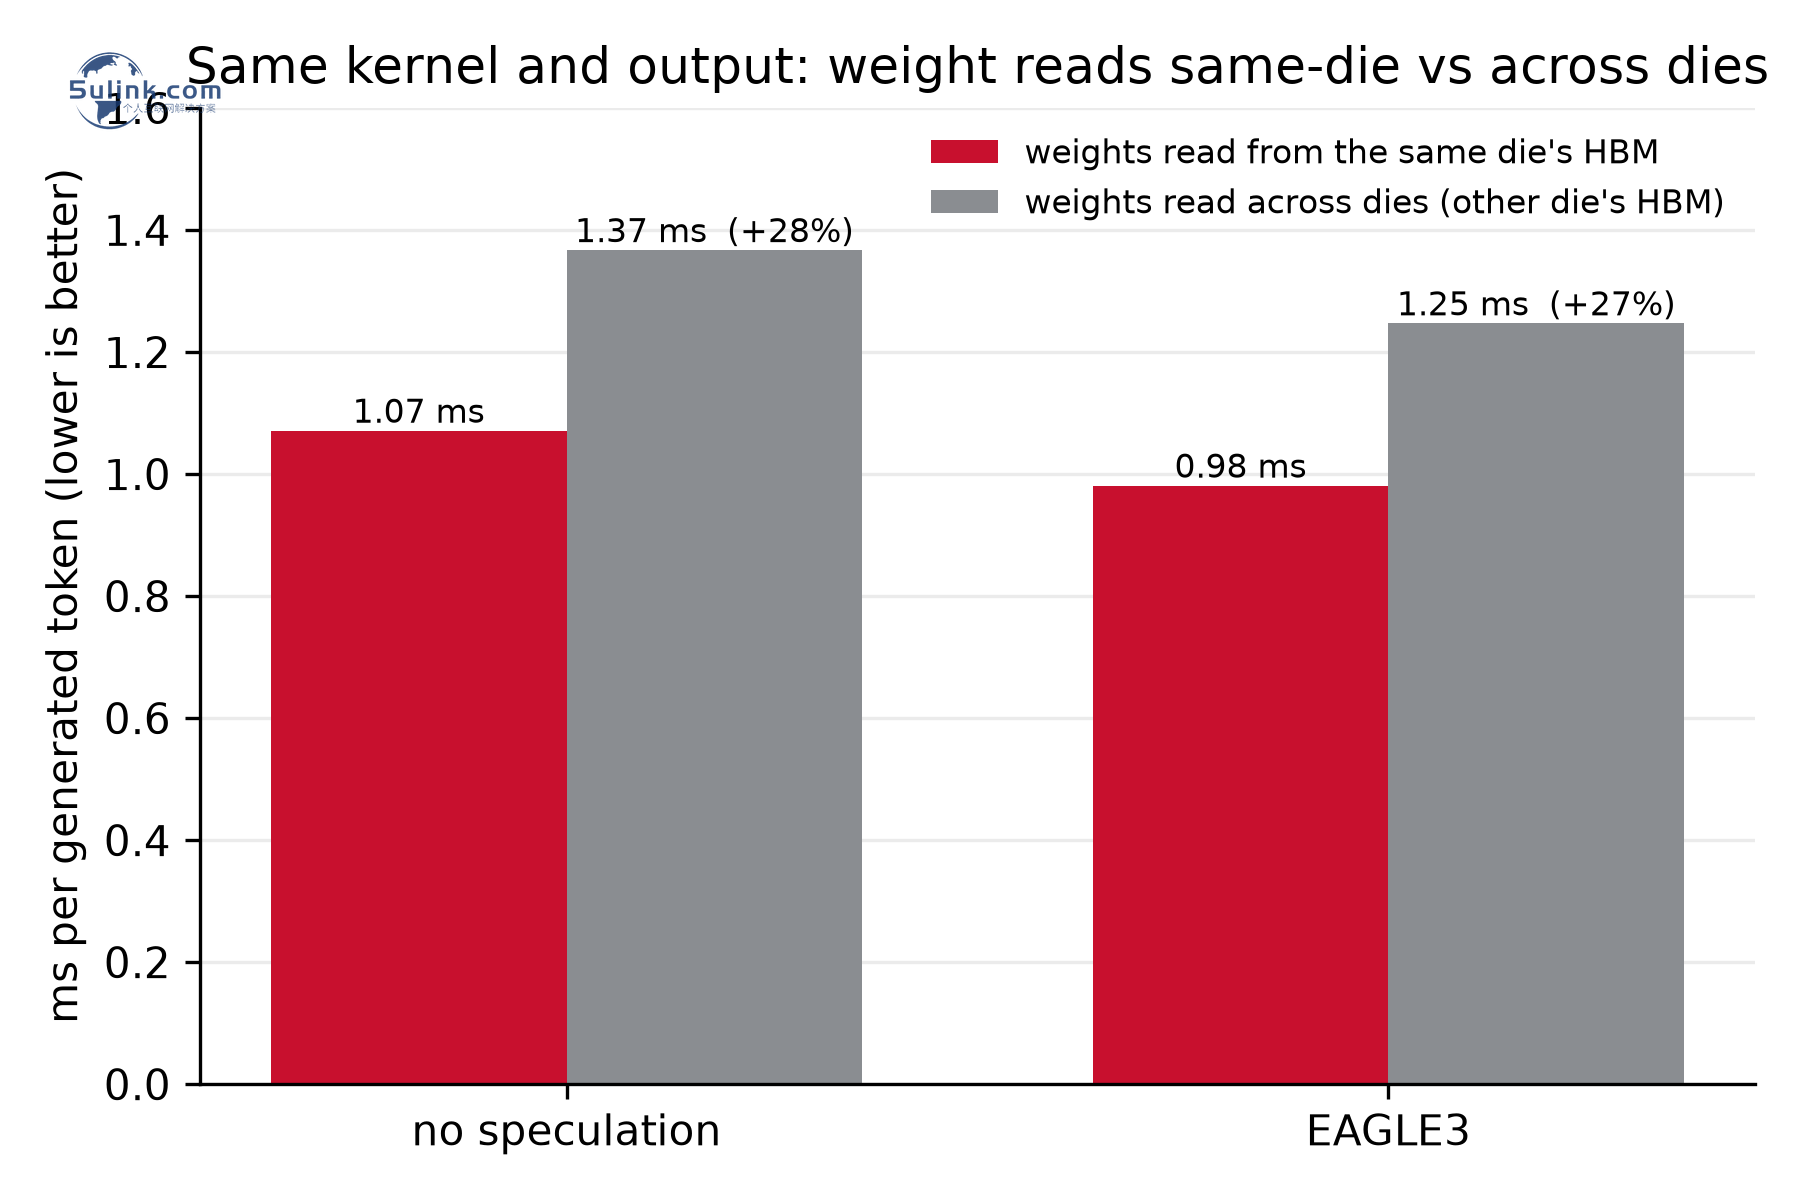
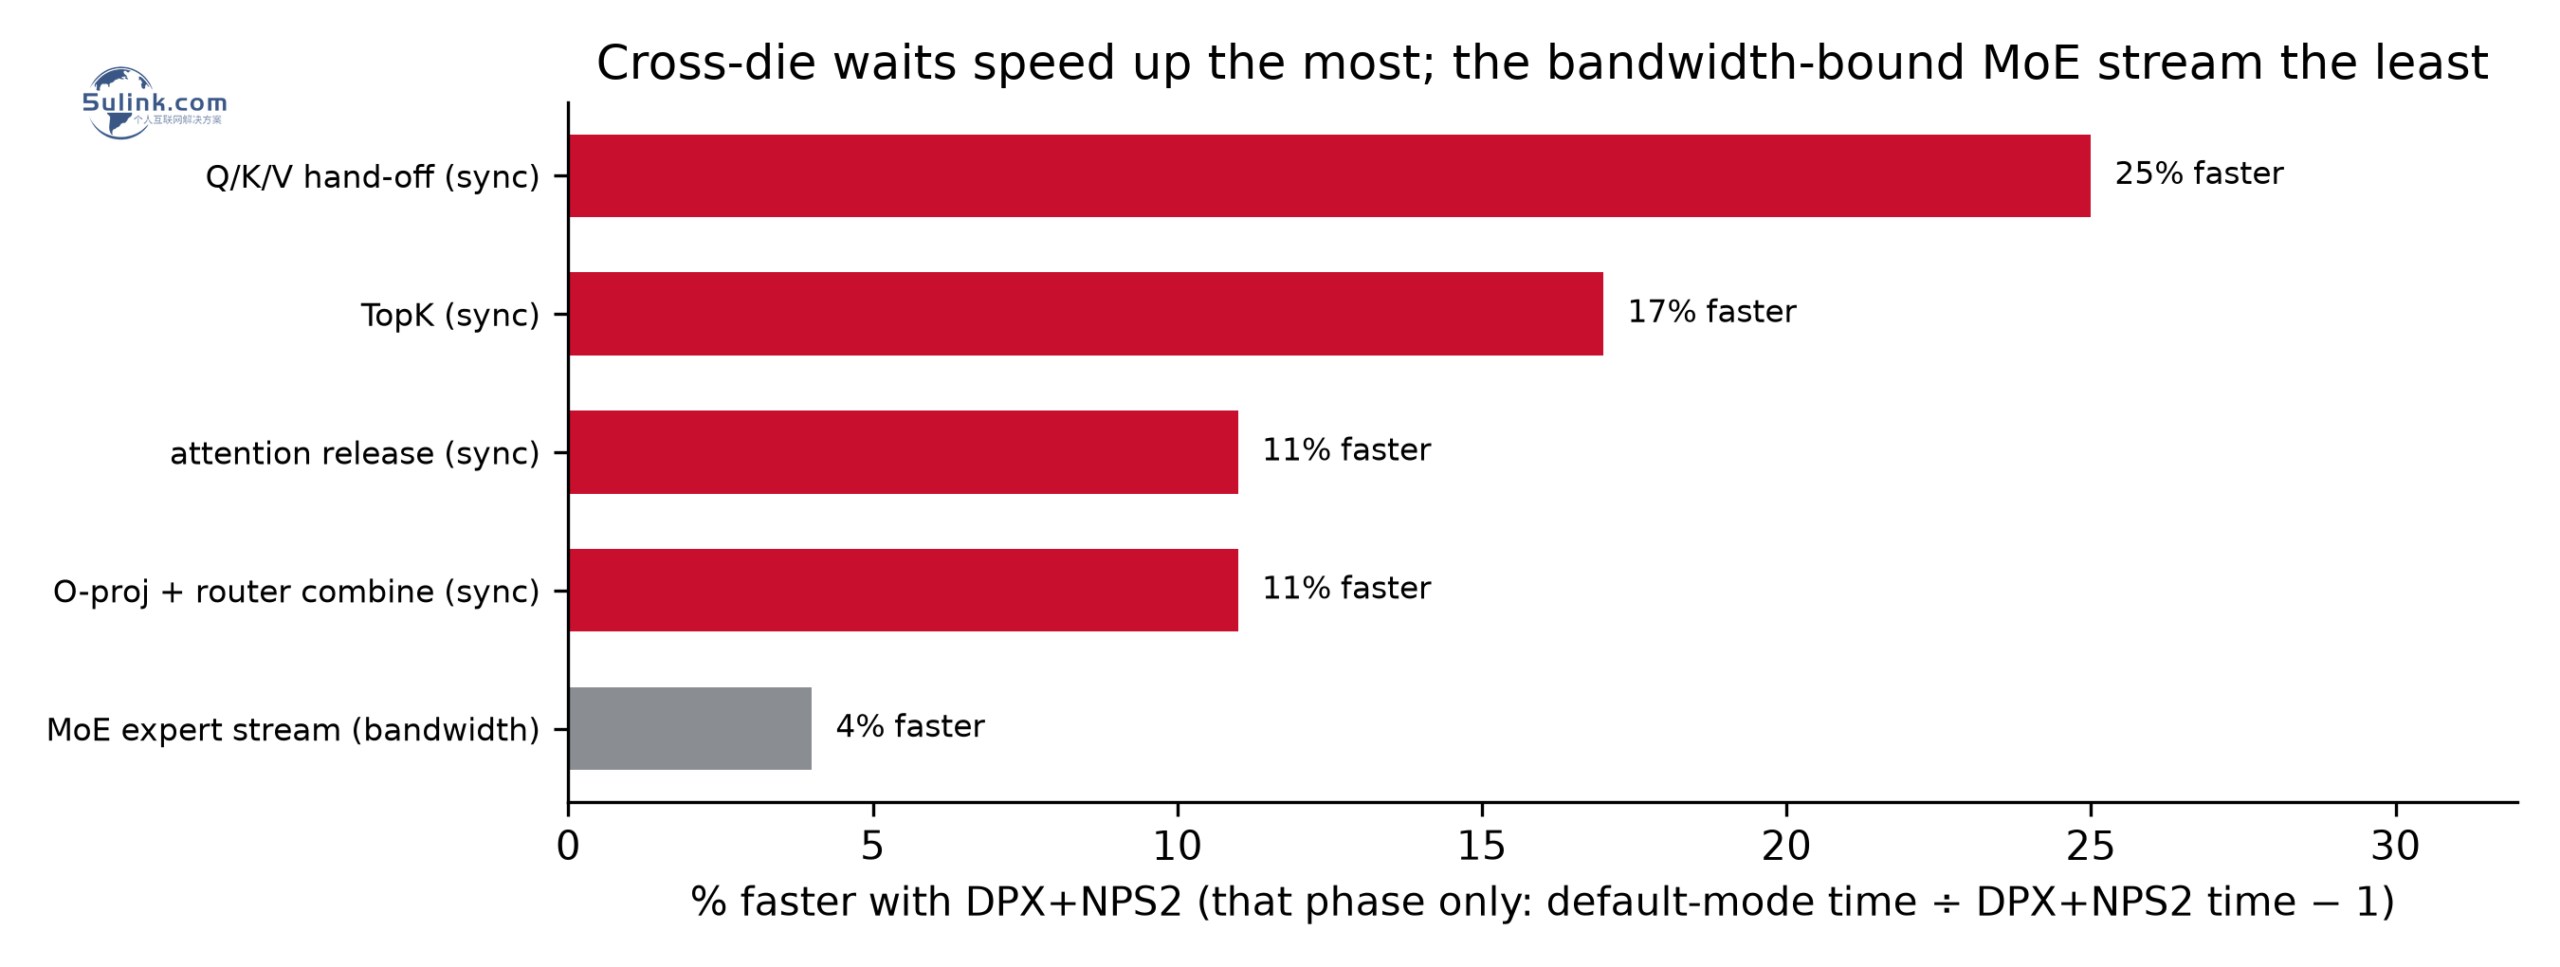
剖析显示关键路径上默认模式每层多花 1.4µs,其中 86% 花在搬数据、14% 花在阶段间等待。分步骤看,受益最大的正是”等对面数据”的环节:Q/K/V 交接快 25%,top-k 专家路由快 17%,输出投影合并和注意力释放各快 11%;而本来就被 HBM 带宽卡住的专家权重流只快 4%。驻留与投机还会互相放大:投机验证一轮要读更多专家(4 token 约 11.7 个/层 vs 2 token 的 7 个),对带宽依赖更深,本地内存的价值就更大——GSM8K 上驻留(1.08x)与投机(1.27x)叠加约 1.36x。
结果与质量核对
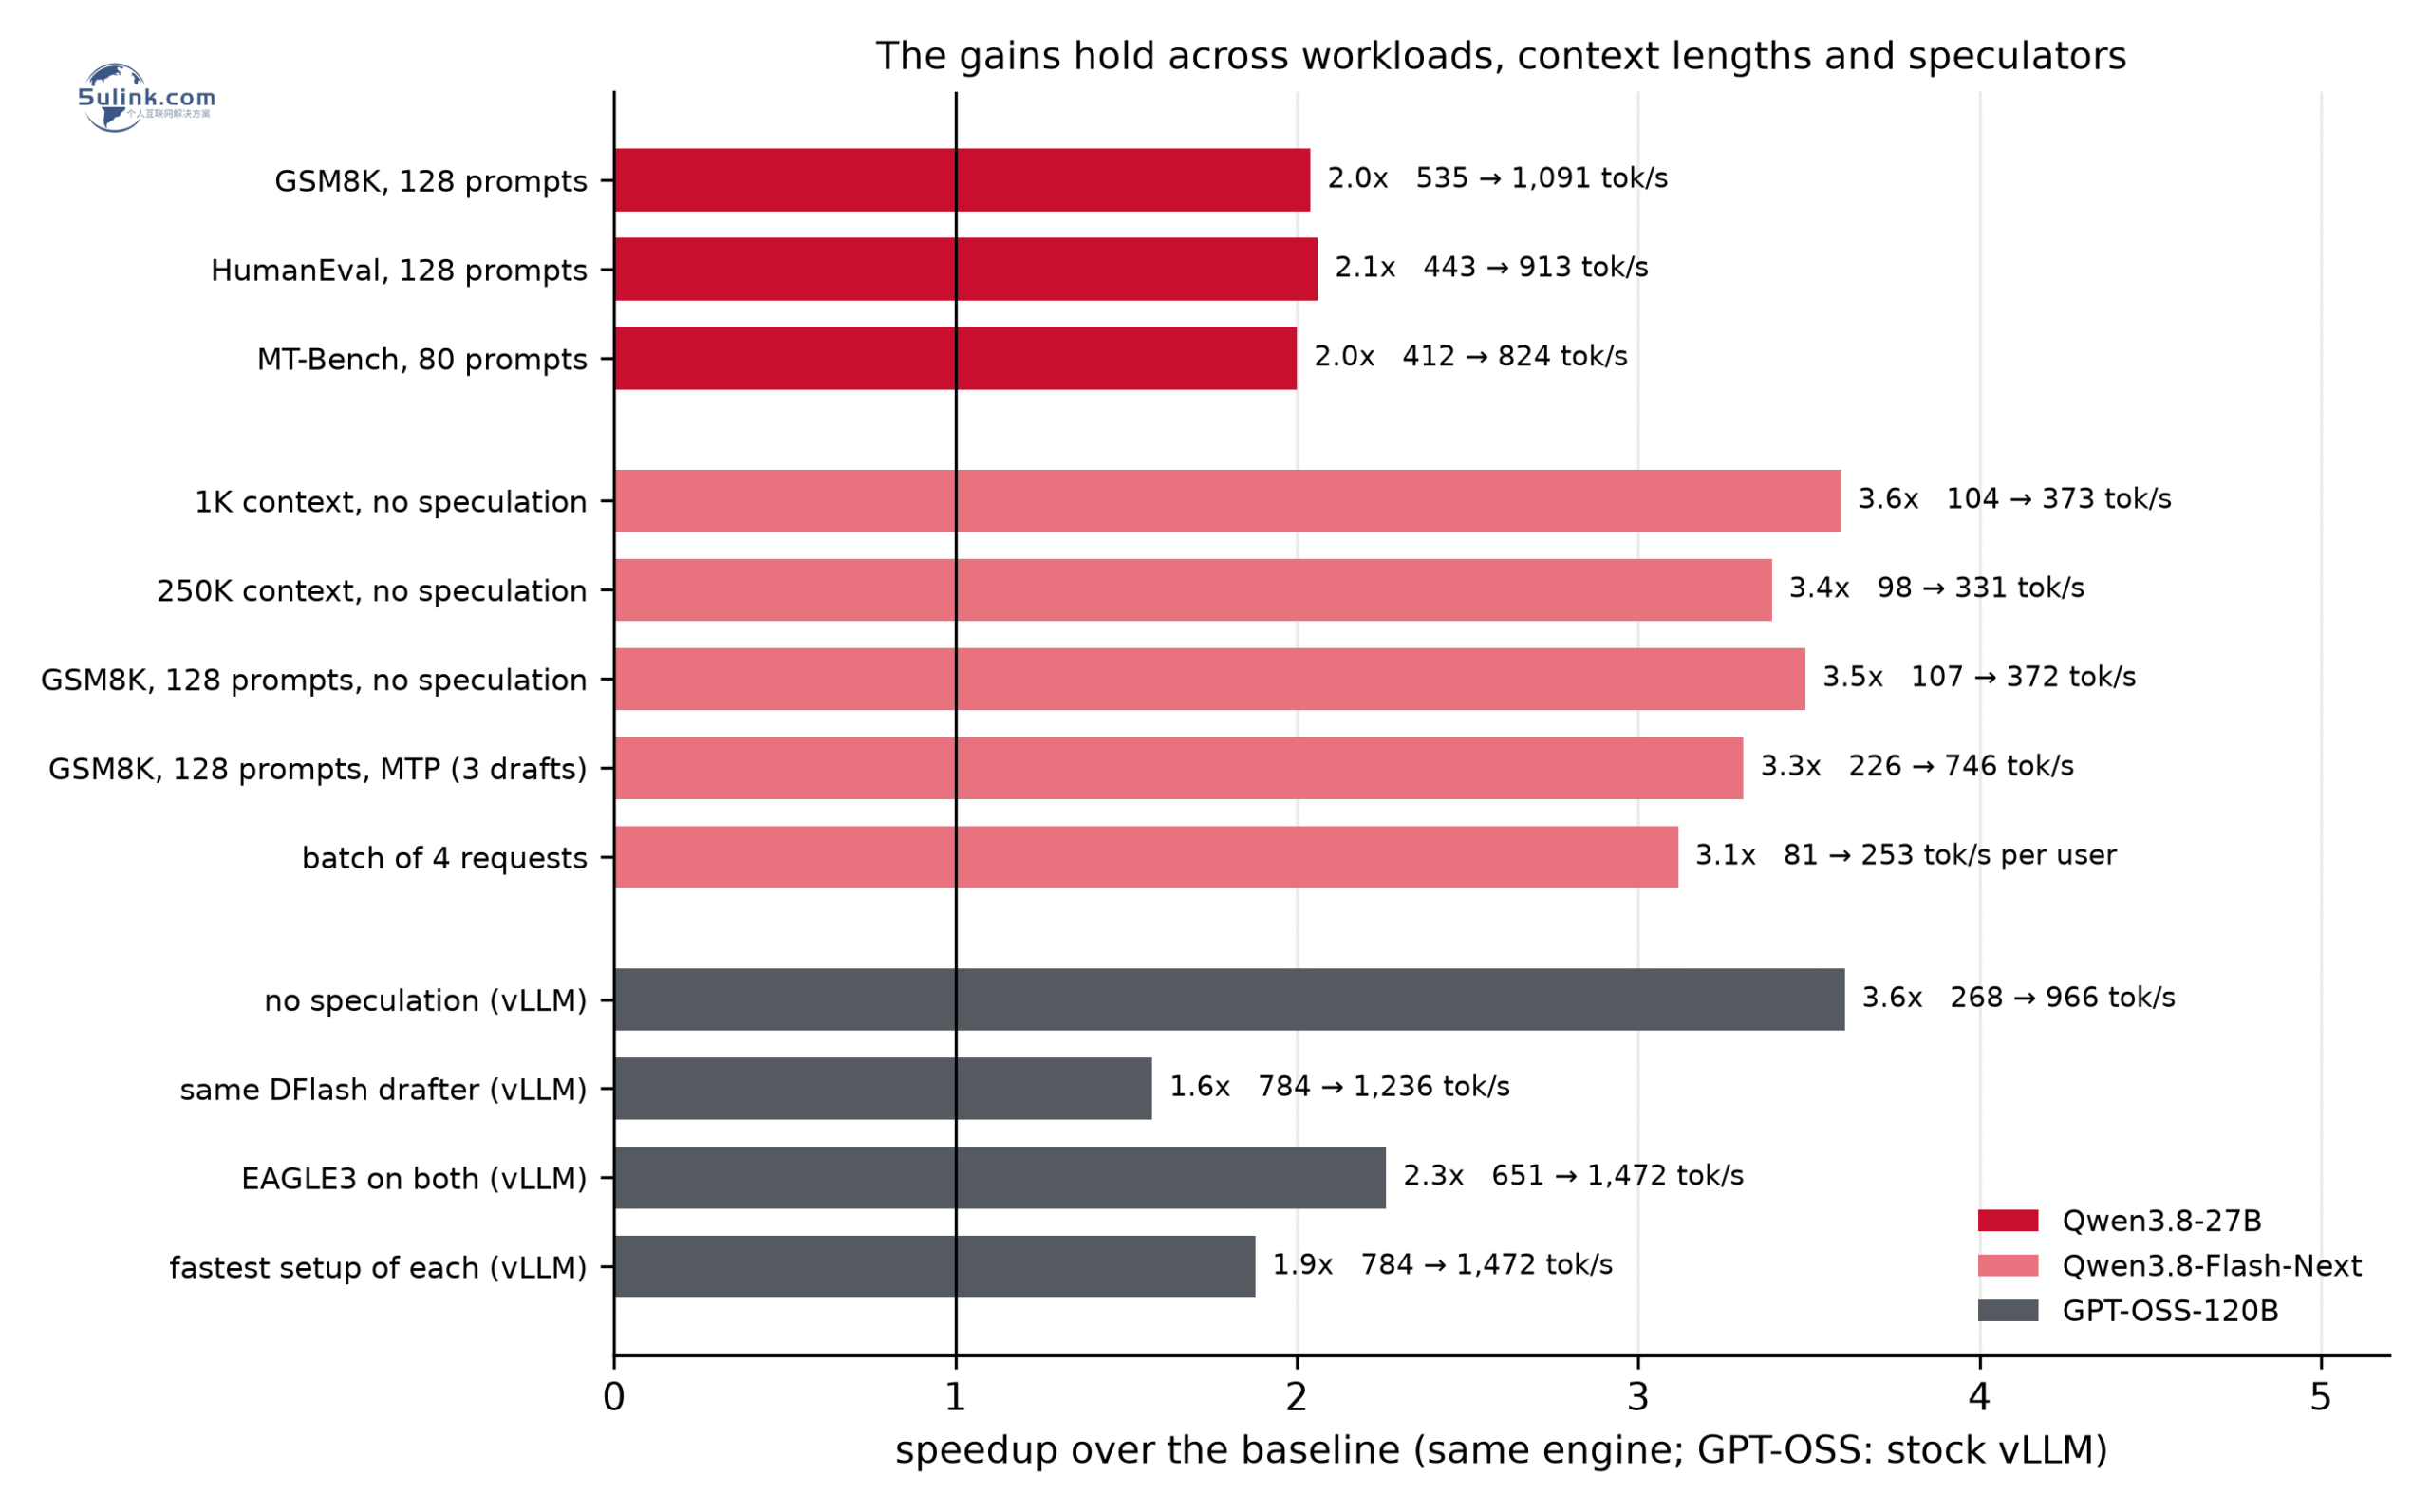
加速在推理、代码、聊天三类负载上都成立:Qwen3.8-27B 三个引擎同速(2.0–2.1x),1K 到 32K 上下文的轮时间只从 5.1ms 涨到 5.7ms;Flash-Next 无投机 3.4–3.5x、带 MTP 3.1–3.3x,1K 到 250K 上下文 3.4–3.6x,四请求并发时每用户仍有 3.1x;GPT-OSS-120B 无投机对 stock vLLM 3.6x,EAGLE3 口径 2.3x。
质量方面每个草稿 token 都由目标模型验证,且对照参考实现逐项核对:Qwen3.8-27B MXFP4 在 GSM8K、HumanEval、MMLU-Pro 上与 BF16 差距约 1 分,唯一明显让步是 GPQA-Diamond 低 3–5 分;GPT-OSS-120B 聊天口径 GSM8K 94.8–95.4% 对齐 vLLM,MMLU-Pro 74.4% vs 73.2%。别忽略方法论边界:5-shot 原始文本口径的 GSM8K 上,megakernel 无投机 42.8%、带投机 35.5–39.3%(AMD 注明分数随注意力 kernel 的上下文切分方式波动,还在排查);GPT-OSS 对比里两边的分区模式、精度、drafter 都不相同,是”完整方案对完整方案”的比较。这些坦诚的标注让数字更可信,而不是更减分。
小夏点评
- “单流速度正在变成产品功能”是这篇的题眼。 当 agent 调用的典型形态就是”一次一个请求”,吞吐榜单与体感延迟就是两套优化逻辑——AMD 把 batch-1 单独立项、逐条给复现脚本,说明单请求延迟已经从论文题材变成商用卖点,英伟达软件栈在这个指标上的每一轮公开对比都会被放在同样的聚光灯下检验。
- 四个开关里真正可迁移的是方法论:persistent kernel 消启动开销、生产者-消费者细粒度交接、跨 die 数据驻留、按 tokens/ms 而非接受率选 drafter——这是一整套”多 chiplet/多 die 架构榨最后一公里”的手法,任何一个内存分区分侧的加速器设计都能直接套用,与厂商用哪块卡无关。
- 对中国 IT 的含义:国内云厂商的对话式 AI 服务(智能客服、编码助手、agent 平台)拼到最后就是每 token 延迟,而国产加速卡普遍正在走向多 die/chiplet 封装——AMD 这套”数据留在消费侧 + 把验证摊厚”的路径几乎是现成的模板。同时要记住那句自我标注的警告:短答案基准对内核细节高度敏感,选型时必须用自己的真实负载复测,别把厂商(无论哪家)的 GSM8K 数字直接抄进决策 PPT。
参考
- 原文:AMD ROCm Blogs — Bringing Ultra-Fast, Interactive LLM Inference to AMD Instinct MI355X GPUs(2026-10-20)
https://rocm.blogs.amd.com/software-tools-optimization/megakernel-intro/README.html - ATOM(Qwen 路径与基准客户端):https://github.com/proaditya/ATOM/tree/qwen38-megakernels
- AITER(SGLang/vLLM 插件):https://github.com/proaditya/aiter
- FlyDSL:https://github.com/ROCm/FlyDSL