PyTorch 接上 FlyDSL:AMD GPU 迎来新内核后端,vLLM 端到端最高快 3 倍
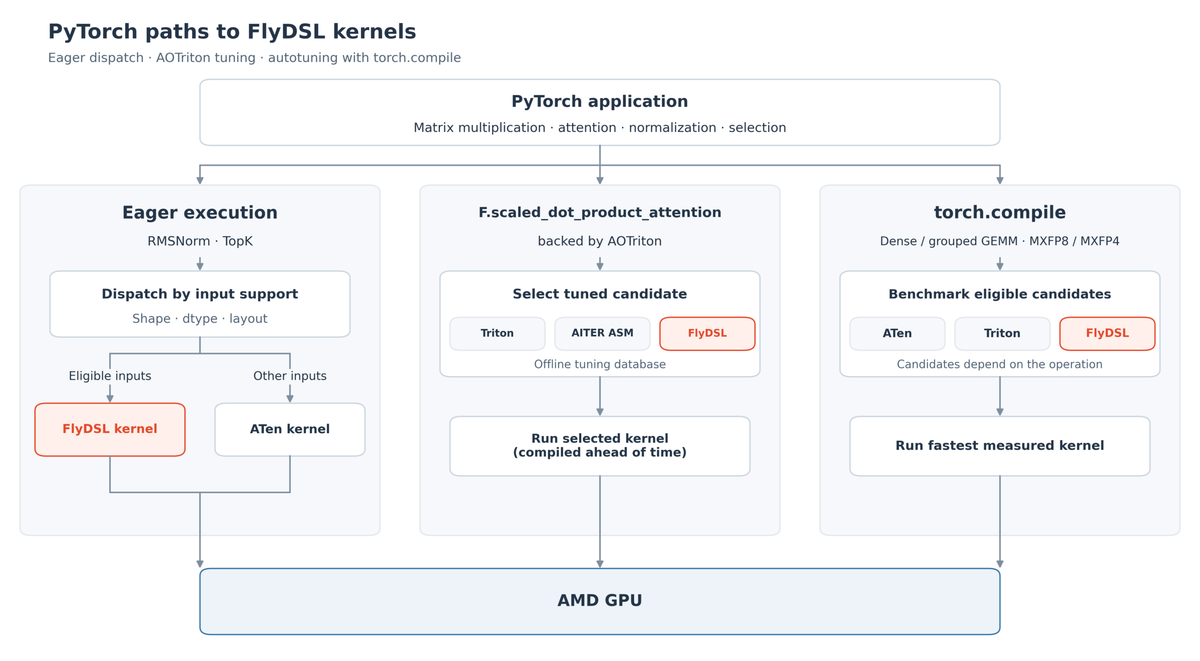
PyTorch 接入 AMD 的 Python 内核 FlyDSL:GEMM、注意力、RMSNorm 都能走新内核,vLLM 整请求最高快 3 倍,不改代码。

Share Life
PyTorch 接入 AMD 的 Python 内核 FlyDSL:GEMM、注意力、RMSNorm 都能走新内核,vLLM 整请求最高快 3 倍,不改代码。

狗云服务器优惠