1700 美元的 32GB 推理卡实测:单卡跑 Qwen3.8 二十 token 起步,约为 RTX 5090 四分之一吞吐
ASRock 这张 Creator 系列工作站卡,本质是把 RDNA 4 旗舰核心的 32GB 显存做成推理专用卡:双槽涡轮、尾部供电位、均热板 + PTM7950,专为多卡机箱设计,售价 $1700。同量级显存、PCIe Gen5 通道的 NVIDIA 方案基本都在它的数倍价位,这档位长期没人管。
硬件规格速览
| 项目 | 参数 |
|---|---|
| 架构 | RDNA 4 / Navi 48 |
| 计算单元 / AI 加速器 | 64 CUs / 128 |
| 显存 | 32GB GDDR6,带宽 640 GB/s |
| 加速时钟 | 2.92 GHz |
| FP8 稠密算力(矩阵) | **382.7 TFLOPS**(稀疏翻倍) |
| FP32 算力(向量) | 47.8 TFLOPS |
| 接口 / 功耗 | PCIe Gen5 x16 / **整卡 300W** |
| 供电位 | 尾部 ATX 12V-2×6,利于多卡 |
| 显示输出 | 4× DisplayPort 2.1a |
Qwen3.8-27B:并发是唯一的杠杆
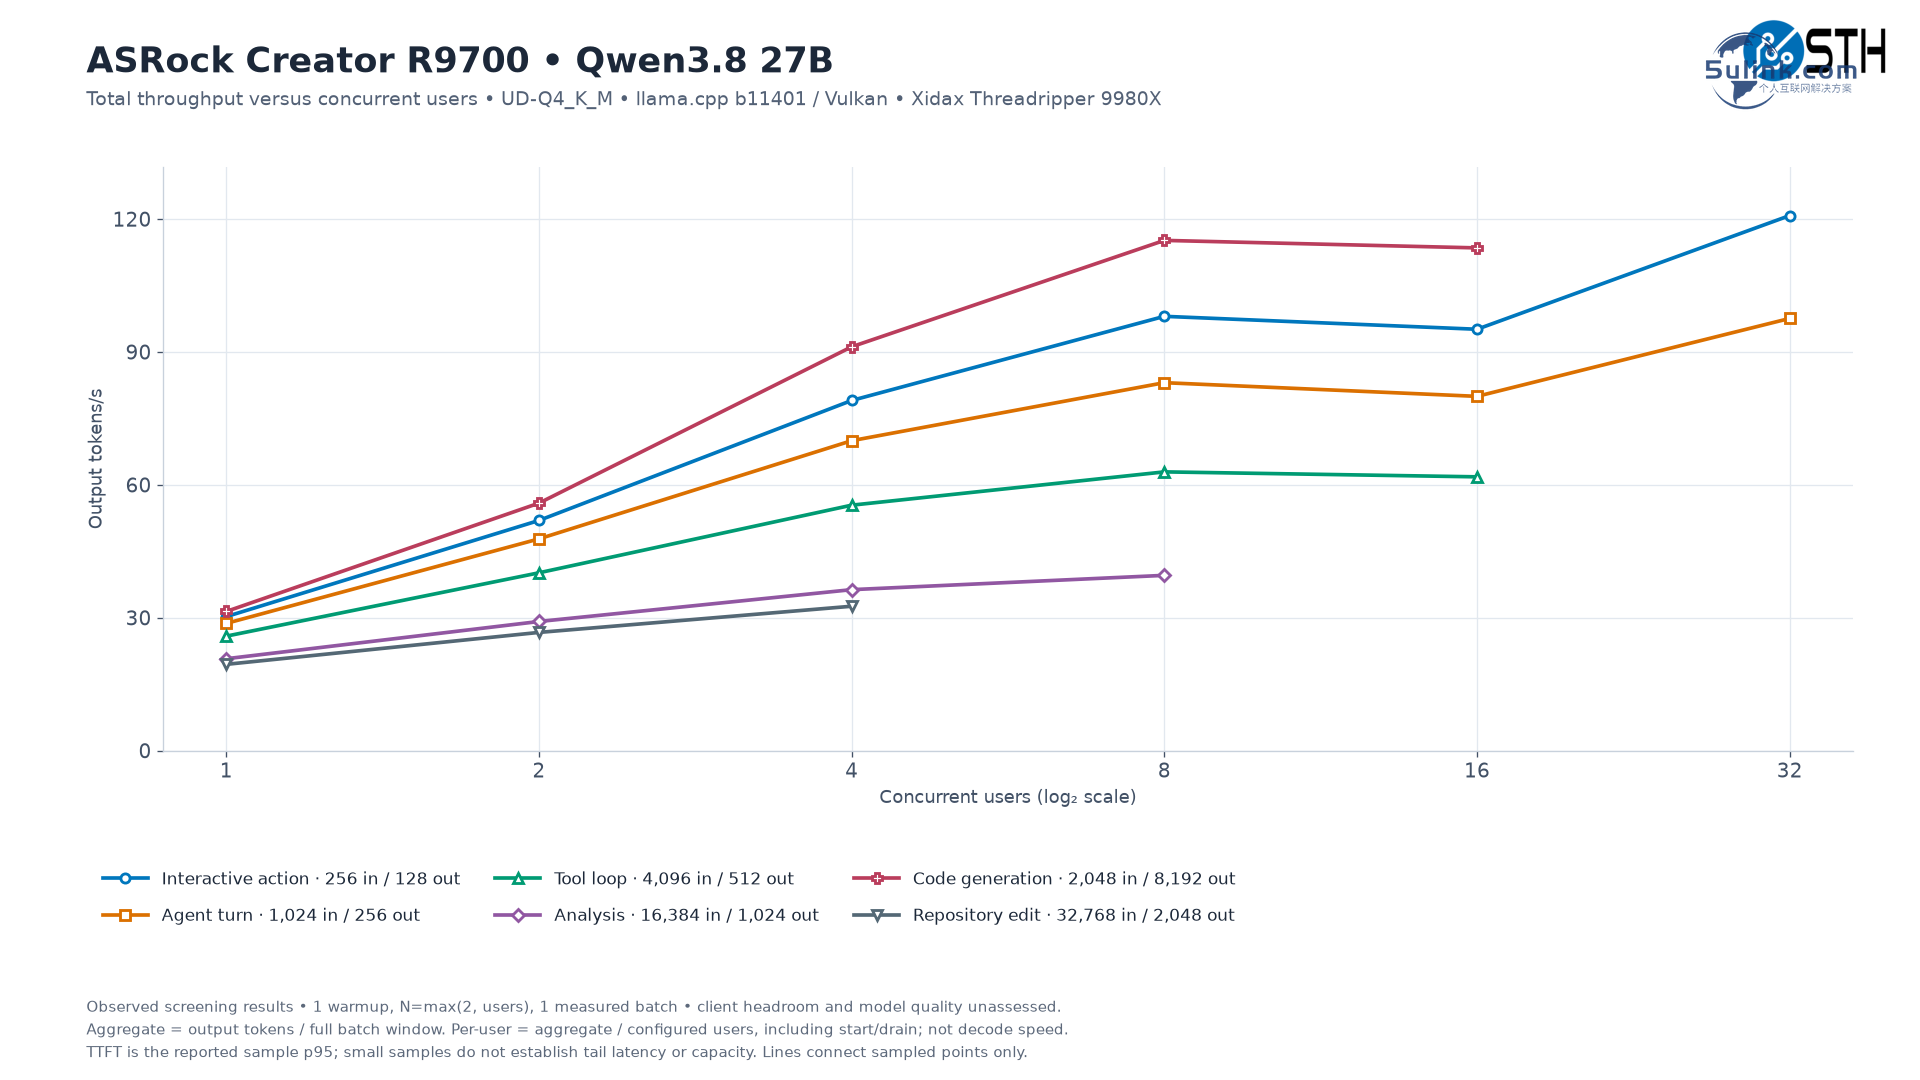
六类真实负载(代码生成、Agent 回合、工具循环、仓库编辑等)全部跑 4-bit 量化:单用户起步只有 20-30 tok/s,这个模型本身很重。随并发爬坡,代码生成一路冲到 113 tok/s @16 用户(3.6 倍),Agent 回合在 32 用户封顶 97 tok/s,最重的仓库编辑 4 用户只从 19 爬到 33。
代价写在 TTFT 上:到 32 用户,所有阶段首字延迟全部破 10 秒,分析和仓库编辑超过 100 秒。没有任何组合能让所有阶段都压进 10 秒内,4 用户是最接近”甜点”的位置。
Qwen3.6-35B-A3B:MoE 小激活参数的甜区
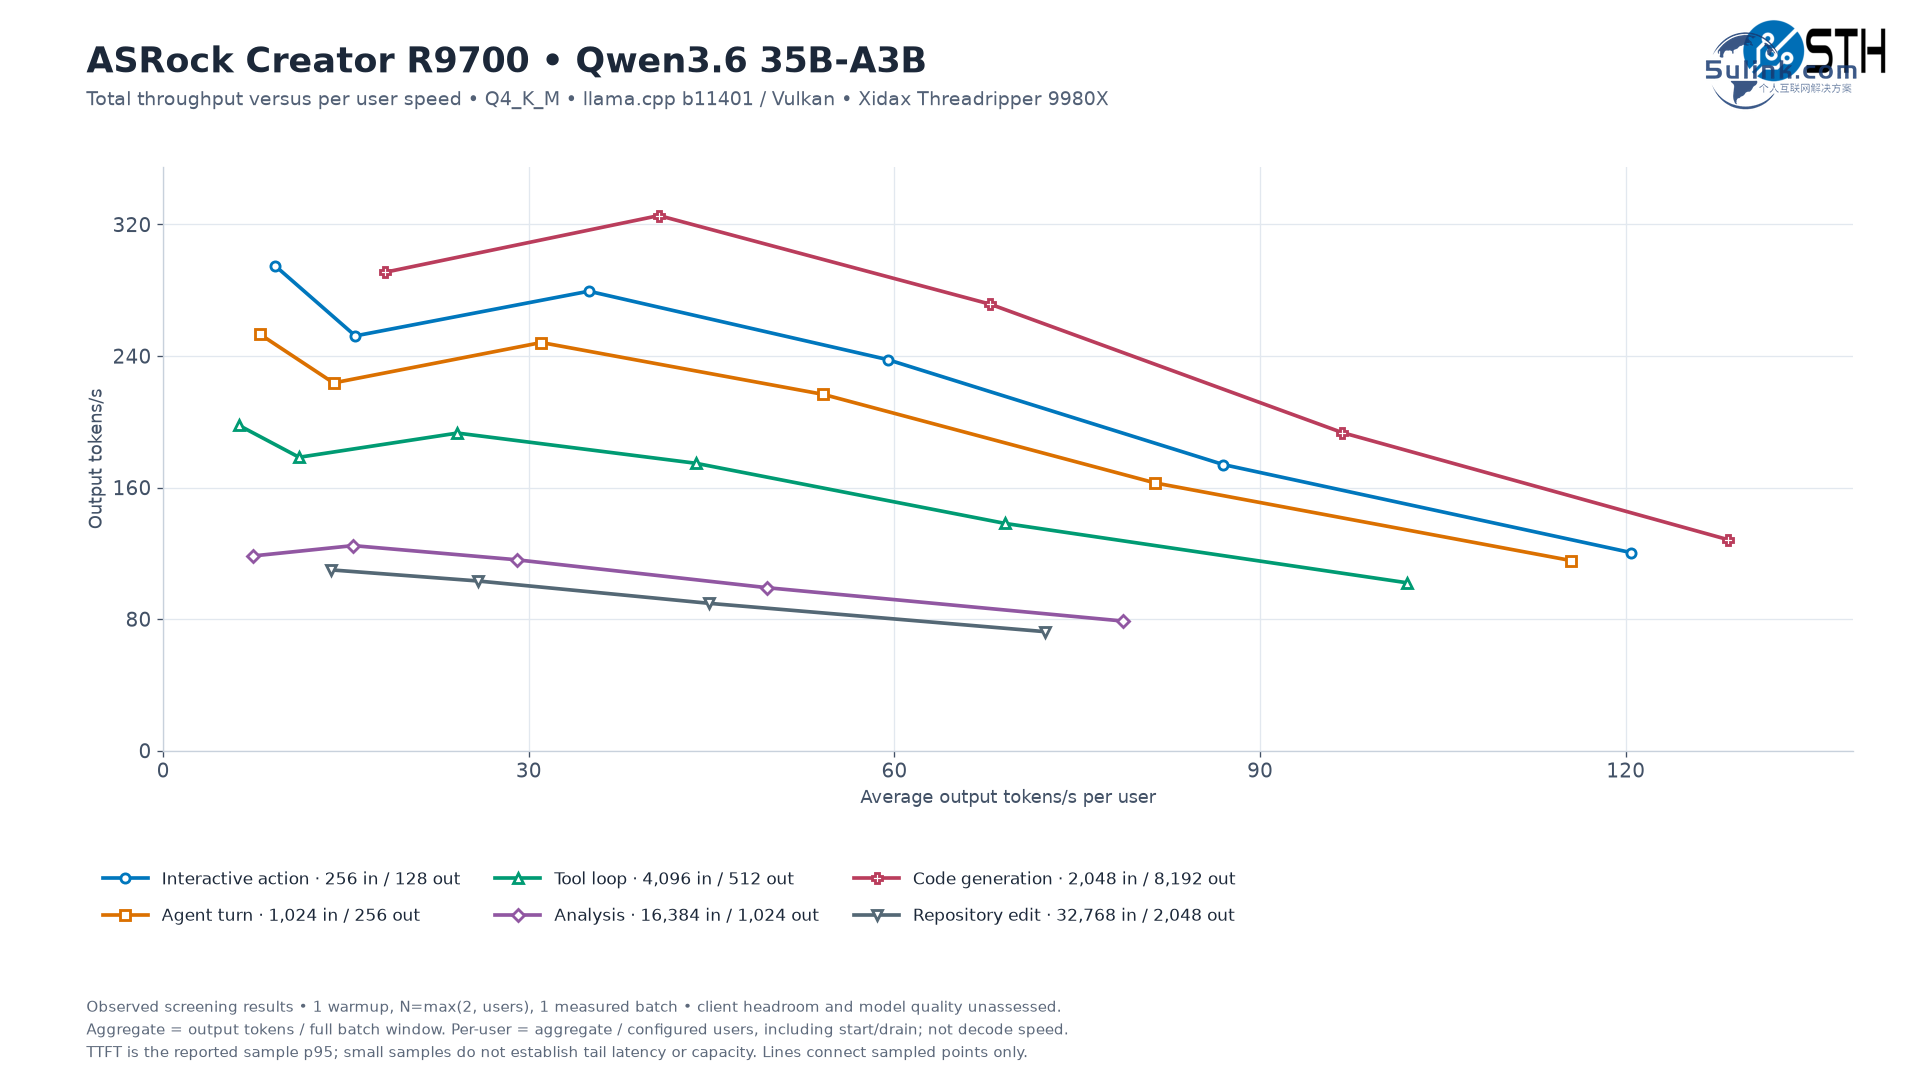
35B 总参、只有 3B 激活的 MoE,4-bit 量化后体验完全不同:所有阶段单用户起步 ≥75 tok/s,代码生成直接 128 tok/s;4 用户分析爬到约 105、工具循环约 155(+36%/+50%)。8 用户就能拿到这张卡绝大部分性能,人均稳在 30 tok/s 以上——16 用户附近反而出现全线回吐。
和 RTX 5090 的差距
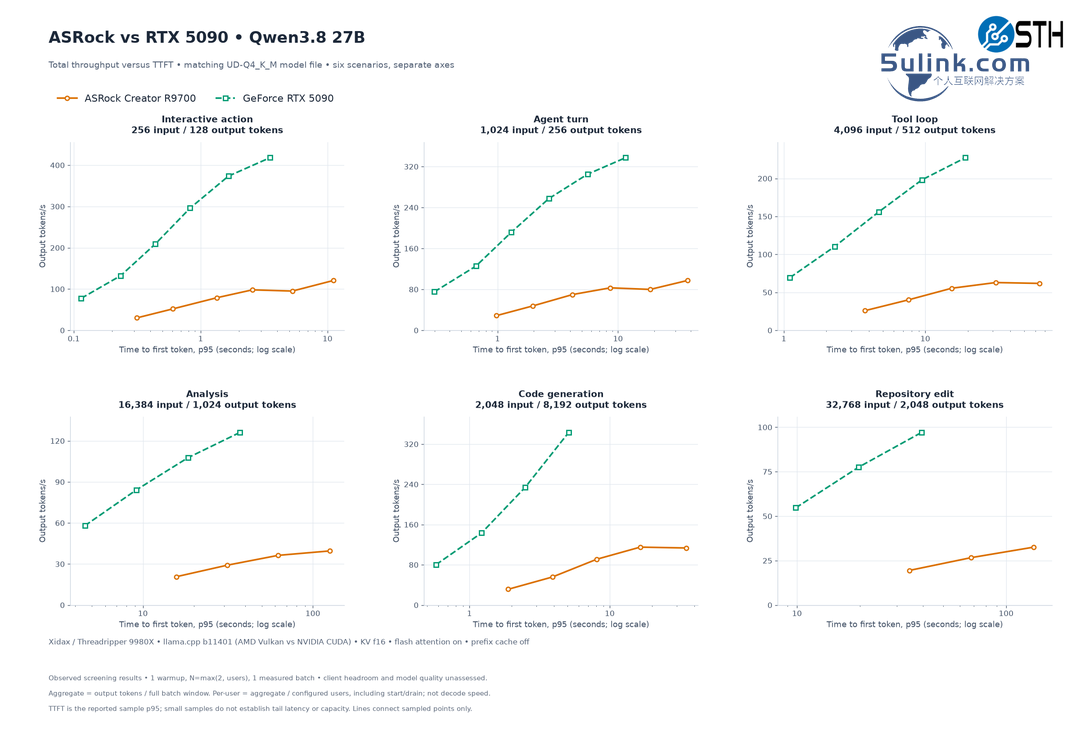
STH 用自家测试库横比了旗舰卡 5090:Qwen3.8 峰值吞吐差近 4 倍,Qwen3.6 收窄到约 3 倍、低并发时只有 2 倍。评测作者的判断很有意思——低并发场景 R9700 性价比突出。评论区 Jared G 建议换用 vllm-radiance 的 MXFP4 还能显著再涨,作者确认他们已经用 1-2 张卡测过 radiance,但框架变化太快,建议大买家先测自己的真实负载。