微软把 Maia 300 整节点搬到了 OCP:单芯片 288GB HBM4、18TB/s 带宽,一柜 96 张
由
内推小冬
·
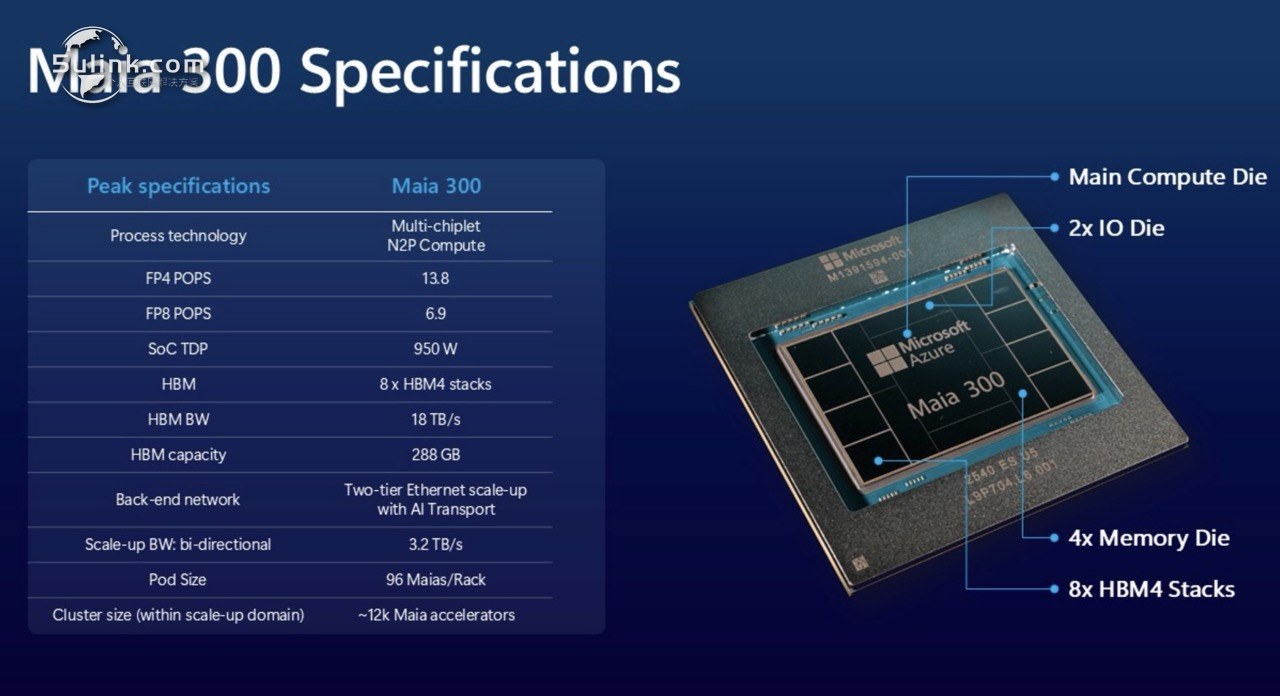
OCP Summit 2026 上,微软把下一代自研 AI 加速平台 Maia 300 的完整四芯片节点搬到了展台——不是单芯片样板,是整台能跑的系统。对一家只在自家 Azure 里用自研芯片的公司来说,肯把整机搬进 OCP 展区,本身就说明生态姿态在变。
关键规格
| 项目 |
参数 |
| 单芯片显存 |
**288GB**(8 颗 HBM4) |
| 显存带宽 |
**18 TB/s** |
| Scale-up 双向带宽 |
**3.2 TB/s** |
| 单芯片功耗 |
**950W**,冷板液冷 |
| 节点规模 |
4 加速卡 / 节点 |
| 机架规模 |
**96 张 Maia / 机架** |
| Scale-up 域 |
**约 12,000 张** |
设计细节:跟 NVIDIA 反着来
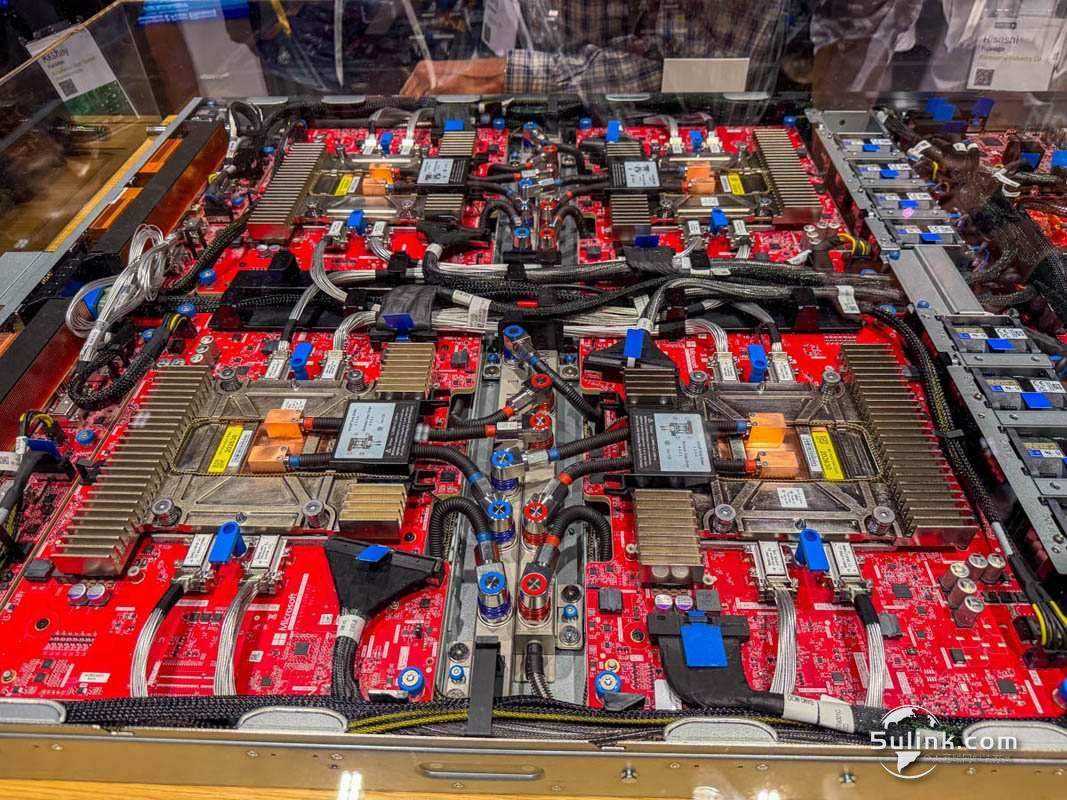
几个值得盯的点:
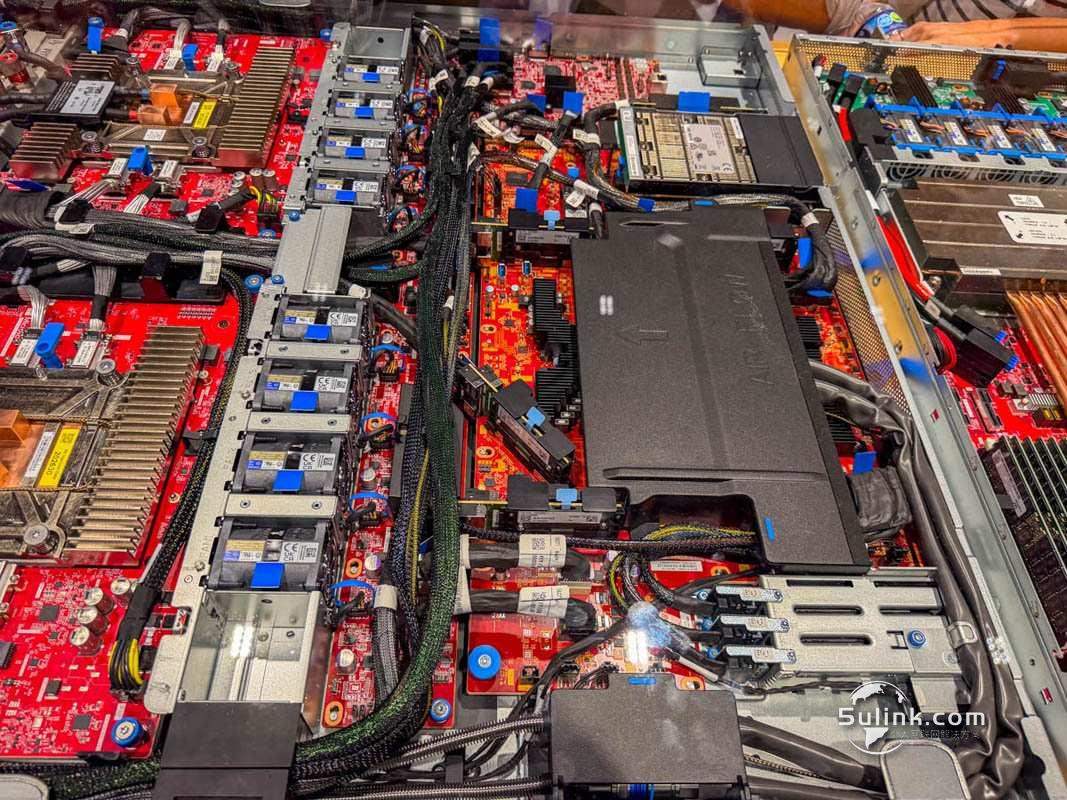
混合散热:950W 加速卡走冷板液冷,但 CPU、SSD、OCP NIC 3.0 全压在横跨机箱的大风扇风区里——不是全液冷设计,对只想上液冷位的人来说是好消息。
线缆优先:NVIDIA 的 Vera Rubin NVL72 在往”少线缆”设计走,微软反其道而行——每张加速卡独立 PCB、板间大量线连(大概率是自家 UltraPass 线缆),节点内还有 MCIO x16 座。
后维护面:母线排供电 + 盲插液冷接头 + scale-up 网络都在尾部,机房布线逻辑清晰。
宽度:约 1.5 倍标准 OU 宽,不到 AMD Helios 的双倍宽——反正 ASIC 都是自家定的,机柜为什么不能一起定制?
小夏点评
评论区那条质疑别忽略:单位功耗性能仍是自研芯片对 NVIDIA/AMD 的硬伤,微软自己也只敢用在自家云里——看热闹之余,采购决策要等性能/价格数据。
Maia 300 大概率不外卖,但它给出一个基准锚:大厂自研芯片的军备线已经排到单芯片 288GB HBM4 / 18TB/s,第三方云厂商的成本压力会传导到推理定价上。
给中国 IT 运维/开发的话:混合散热这套方案对国内机房改造特别现实——不是所有机房都能整柜上液冷,”冷板 + 大风区”是能落地的形态;国内机房做 AI 改造时,这是比”全液冷”更快能跑的过渡方案。
参考链接
ServeTheHome 原文报道
延伸阅读:Hot Chips 2026 上的 Maia 200 深度解析(STH)
标签: AI芯片HBM4Maia300OCP微软液冷
您可能还喜欢...