堆叠内存首批实测数据出炉:高通 HBC 每瓦带宽做到 HBM4 的 5 倍,2027 上半年送样
高通在 11 月 2 日官宣:HBC(High Bandwidth Compute,高带宽计算)架构的首轮验证已经做完。这项技术在 2026 年投资者日上首次公布,是高通数据中心 AI 加速器路线的核心一环——按照规划,它要在容量、性能、量产成本这三头上同时往前挪一步。这次最有价值的信息是:验证数据第一次落了地。
HBC 的关键改动:把计算 die 塞到内存堆的底部
传统 HBM 是”多颗 DRAM die 叠在一颗 base die 上,再通过超宽内存总线连回主控芯片”。HBC 的做法是去掉中间这一环——把 DRAM die 一层层堆到一颗小型计算 die 上,内存和计算直接贴在一起。
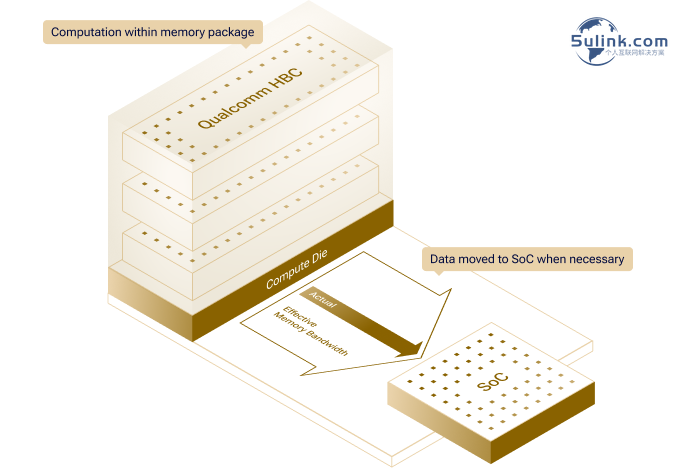
图:HBC 加速器堆叠结构示意(图源:Qualcomm 官方图 / ServeTheHome)
为什么要这么做,逻辑其实很朴素:搬数据是要耗电的,搬得越远越费。HBM 那段 die-to-die 距离虽然短,但也不是零;LPDDR5X 这类外置内存的距离更长。把内存压在计算 die 正上方后,这段开销基本抹平,省下来的功耗可以反哺芯片性能,或者让同样的功耗预算下能塞进更多芯片。
底部这颗计算 die 不是完整处理器,它承担的是内存带宽最吃紧的那部分操作,算完再把结果交回芯片中央的主计算 die——高通要的是”内存和计算能贴多近就贴多近”。
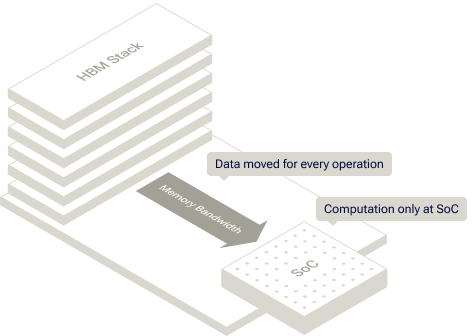
图:传统 HBM 路线——数据每前进一步都要跨出芯片(图源:Qualcomm)
成本这笔账:先进封装省掉一半复杂度
这部分容易被忽略,但对做采购和整机的人来说可能比性能更实在。
HBM 之所以离不开 CoWoS、EMIB 这类先进封装,是因为超宽内存总线必须把内存堆和计算 die 连起来。HBC 把大部分带宽需求吃在了堆内部,留给”堆到主芯片”这段的带宽需求小得多,于是这段连线可以用传统的 2D 有机基板来做,不必再上贵价封装工艺。
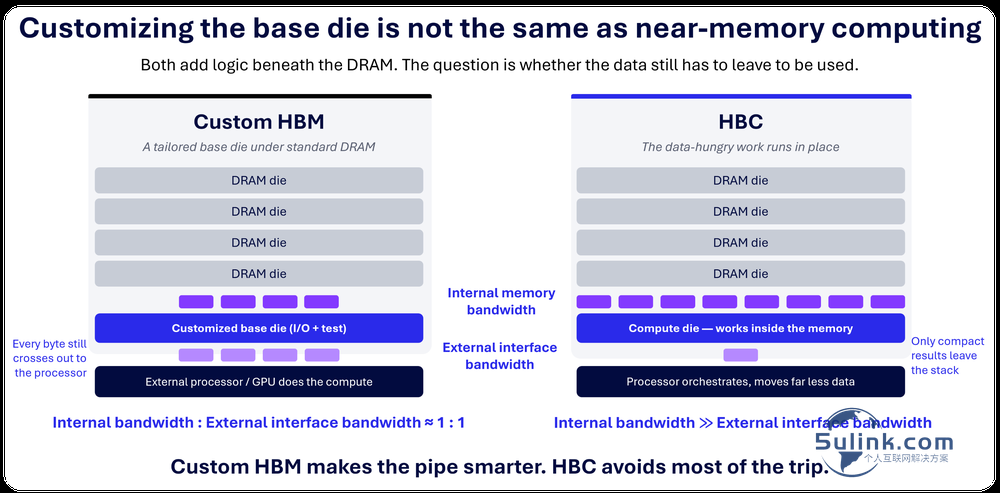
图:HBC 与 HBM 详细对比(图源:Qualcomm 官方图 / ServeTheHome)
但复杂度没有全部消失:多层 DRAM(在高通的方案里是晶圆级)通过 TSV 键合到另一颗 die 上,这本身就是难活儿。变化在于难度从”内存堆叠 + die 到 die 互联”两件难事,收缩成了”内存堆叠”一件。
另一处值得注意的取舍是颗粒选择——HBC 用的是 LPDDR5X 的 DRAM die,而不是 HBM 那种又薄又高速的专用 die。高通没有公布最终性能指标,但明确了一点:HBC 堆栈的容量预期已经高于当前 HBM4 方案。
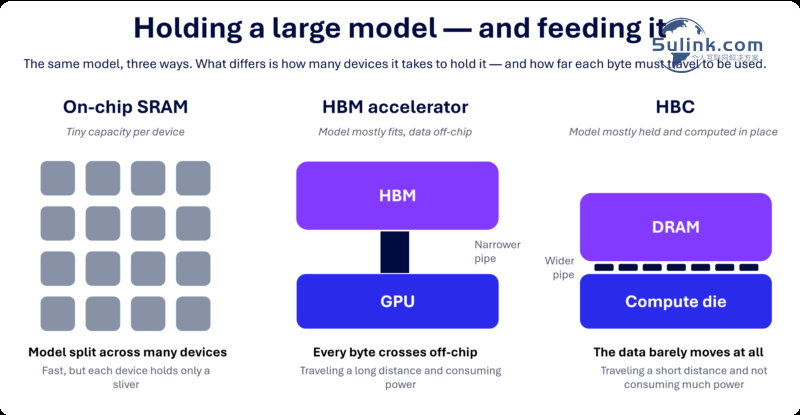
图:HBC 对 HBM 与片上 SRAM 的定位(图源:Qualcomm 官方图 / ServeTheHome)
高通的整套论证可以概括成一句话:比外置 LPDDR 快得多、逼近 HBM 的带宽,同时没有片上 SRAM 的容量天花板,也没有 HBM 的高成本。目标场景写得很直白——AI 推理,用更少的短板同时接住带宽和容量这两个需求。
首轮验证:2 层堆栈、三项结论
这次验证在圣地亚哥实验室完成,用的是一批早期样品搭在自动测试设备(ATE)上跑的。
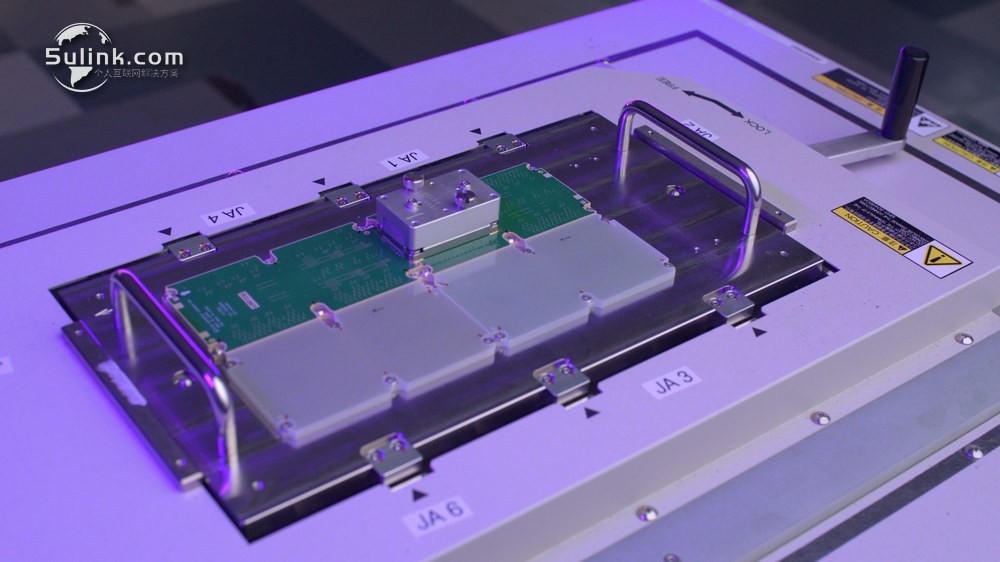
图:圣地亚哥实验室的 HBC ATE 测试台(图源:ServeTheHome)
必须打个折看的细节:这次测的是 2 层 DRAM 堆栈,量产版本是 4 层。也就是说完整尺寸的堆栈还没测到,下面的数字是”原理层”的实测,不是产品级终值。
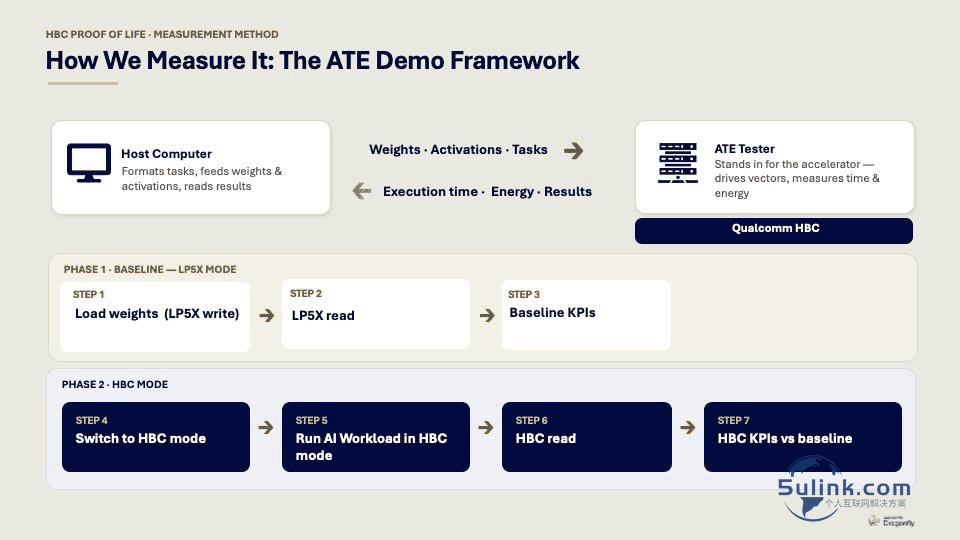
图:验证方法——分别按 LPDDR5X 器件与 HBC 器件口径测量(图源:Qualcomm 官方图 / ServeTheHome)
三项结果整理如下:
| 指标 | 首轮验证结果 | 备注 |
|---|---|---|
| 功能 | 跑通 | 先证明”这条路能走” |
| 能效(每瓦带宽) | >5× HBM4 | 按高通自报的 HBM4 规格口径;最初目标是 6×,略低于预期 |
| 内存带宽 | 18× 外置 LPDDR5X | 归类区间,未公布具体数值 |
| 测试堆栈 | 2 层 DRAM die | 量产为 4 层,完整尺寸尚未测试 |
| 热表现 | 已纳入验证 | 细节未披露 |
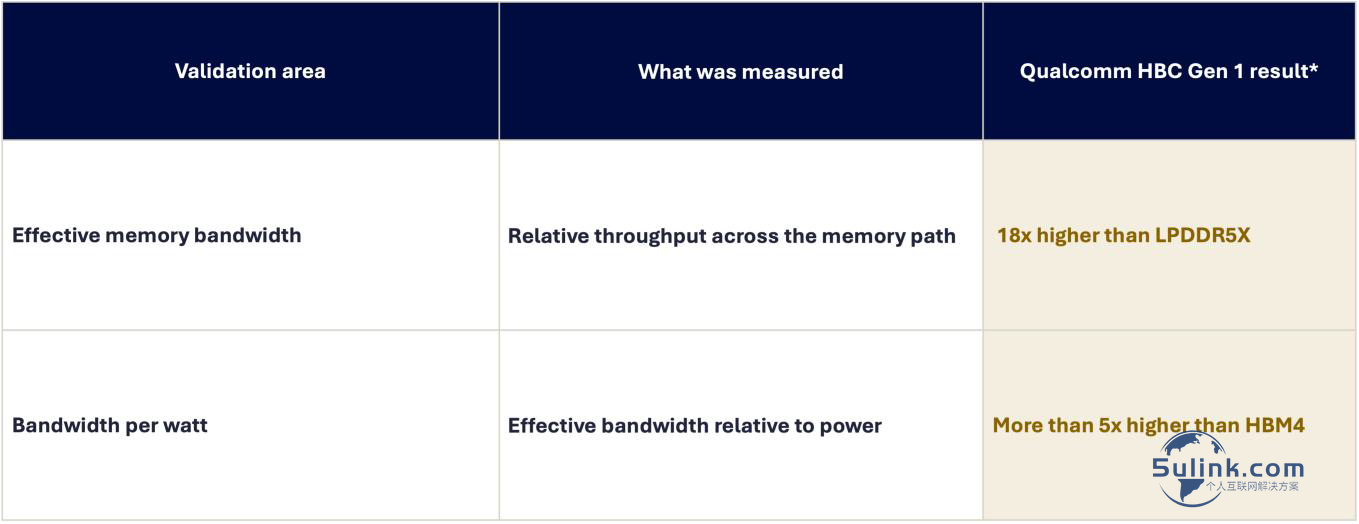
图:验证结论汇总(图源:Qualcomm 官方图 / ServeTheHome)
能效数字比最初的 6 倍预期低了一档,但如果这份表现能带到完整产品上,仍然是很可观的效率提升。
热设计是这次披露里最含糊、也最关键的一块。堆叠架构里把一颗更活跃的计算 die 放在最底下发热,热量往上一层层顶,这本来就是堆叠内存最难过去的坎之一。高通说验证包含热行为,但没给任何细节。
接下来:Dragonfly AI250 与它背后的账
按计划,Dragonfly AI250 是首款集成 HBC 的产品,它是今年那款 Dragonfly AI200 的继任者,也是后续高通 AI 加速器系列的共用底座。送样时间:2027 年上半年(原文标题与文末均为”next year / 上半年”,正文有一处写成 this year,疑为笔误)。
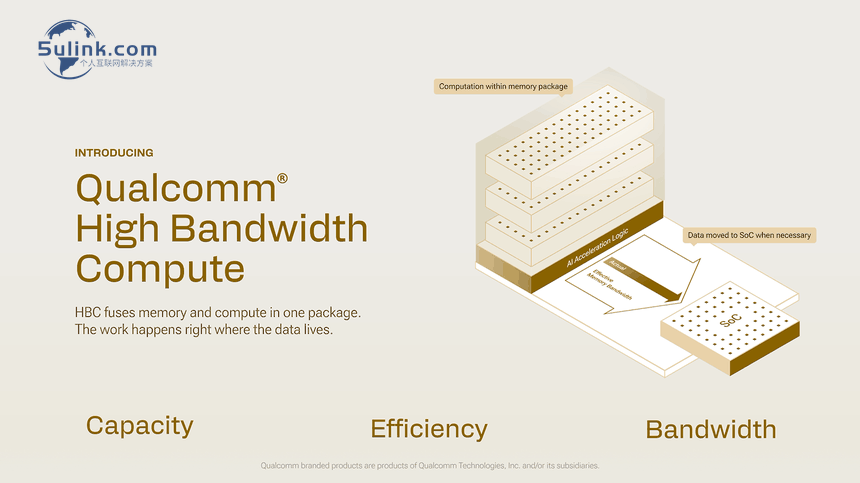
图:HBC 总结(图源:Qualcomm 官方图 / ServeTheHome)
高通没有给 AI250 的发布时间。此外 HBC 不打算只服务数据中心——高通此前说过要把它带到面向消费者的 Snapdragon 产品上,具体时间和型号还没定。
这笔账的最终落点是能效 + 总拥有成本:如果 HBC 成立,高通就能做出比同期方案更省电、也更便宜造的推理加速器,进而让这类芯片在大规模 AI 推理上比 GPU 更便宜地跑起来——甚至更便宜地买进来。
小夏点评
- 1. 这份验证数据要”打折看”,但方向是好的。 2 层样品跑出 5× 能效、目标本是 6×,说明堆叠层数上去之后热和功耗的账会更难算;4 层量产版才是第一次真正大考。高通愿意在这个阶段就把数据公布出来,本身就是给投资人和客户吃定心丸。
- 2. 真正有杀伤力的其实是封装那一段。 能把内存堆与主芯片之间的连线退回 2D 有机基板,等于把 CoWoS/EMIB 的产能压力和成本压力卸掉一半——在先进封装产能依旧紧张的当下,这条路线的吸引力不比带宽数字小。
- 3. 对中国 IT 运维与开发的启示:推理服务的成本结构里,显存带宽和封装成本正在取代算力成为真正的瓶颈项。高通这套”内存压在计算上 + 便宜基板”的组合,本质是想绕开 HBM 供给和先进封装两道卡口。国内做推理云、自建推理集群的团队,接下来一年多值得盯着 2027 上半年这个送样节点——如果 HBC 类产品真能把每瓦带宽做到这个量级,推理节点的功耗账单和采购账单都会跟着变。
参考链接
- – 原文(ServeTheHome,2026-11-02):https://www.servethehome.com/qualcomm-validates-hbc-stacked-memory-ahead-of-2027-dragonfly-ai250-sampling/
- – 相关前作(ServeTheHome,高通 2026 投资者日数据中心发布):https://www.servethehome.com/qualcomm-investor-day-2026-data-center-announcements-cpus-ai-accelerators-and-more/