生产环境别再上 MongoDB 仲裁节点了:三起真实事故里的“投票多数”和“写多数”
这篇文章出自 Percona 支持团队的一次内部讨论:把过去接手的真实工单摊开复盘之后,两位作者的结论相当直接——生产环境别再使用仲裁节点(arbiter)。他们并没有说这个功能坏了,而是说它带来的困惑,和今天大家实际跑 MongoDB 的方式已经对不上了。
仲裁节点当年解决的是”投票”,不是”数据”
仲裁节点从 MongoDB 早期版本(2010 年)就存在,设计目标很单纯:帮副本集凑够奇数张选票。团队想要奇数投票成员,又不愿意为此多养一台存数据的节点,于是仲裁节点登场——它很轻量,参与投票,不存数据,也不回放 oplog。
问题在于,这个设计回答的是一个投票问题,它从来没有回答过数据持久化问题,以后也不会。
在 MongoDB 3.x、4.x 时代,持久化从多个方向同时加固:WiredTiger 成为默认存储引擎、副本集协议升级到 pv1、readConcern 和 writeConcern 把”majority”变成一等公民、change streams、多文档事务、流控(flow control)、集群级默认读写关注。这些机制各自都在用某种”多数派”,而仲裁节点只在其中一种里算数。
| 多数派的种类 | 谁算数 | 仲裁节点算不算 |
|---|---|---|
| 选举投票多数 | 所有投票成员 | 算 |
| 写多数(writeMajority)/ majority 提交点 | 只有真正存数据的节点 | 不算 |
| 流控与 oplog 应用进度 | 只有真正存数据的节点 | 不算 |
对资深 DBA 来说这几层区分很清楚,对大多数使用者并不清楚。于是就会出现下面这些在支持工单里反复出现的场景。
案例一:选举一切正常,写入却几乎停摆
一个分片集群,三个分片,外加一个配置服务器副本集。每个分片是 7 个投票成员:一个数据中心(DC1)里 3 个数据节点,另一个数据中心(DC2)里 3 个数据节点,第三个数据中心(DC3)里放仲裁节点。配置服务器则是另一种搭法:6 个数据节点,每个机房 2 个,没有仲裁节点。
一个数据中心整体掉线。选举顺利完成,每个分片都选出了新主。几分钟后,每个分片的写入吞吐从大约 每秒 3000-4000 次 掉到 每秒 50-75 次。
应用侧走 mongos,用的是 { w: 2, j: true },每个分片也明明还有 3 个带数据的成员活着——为什么会塌?
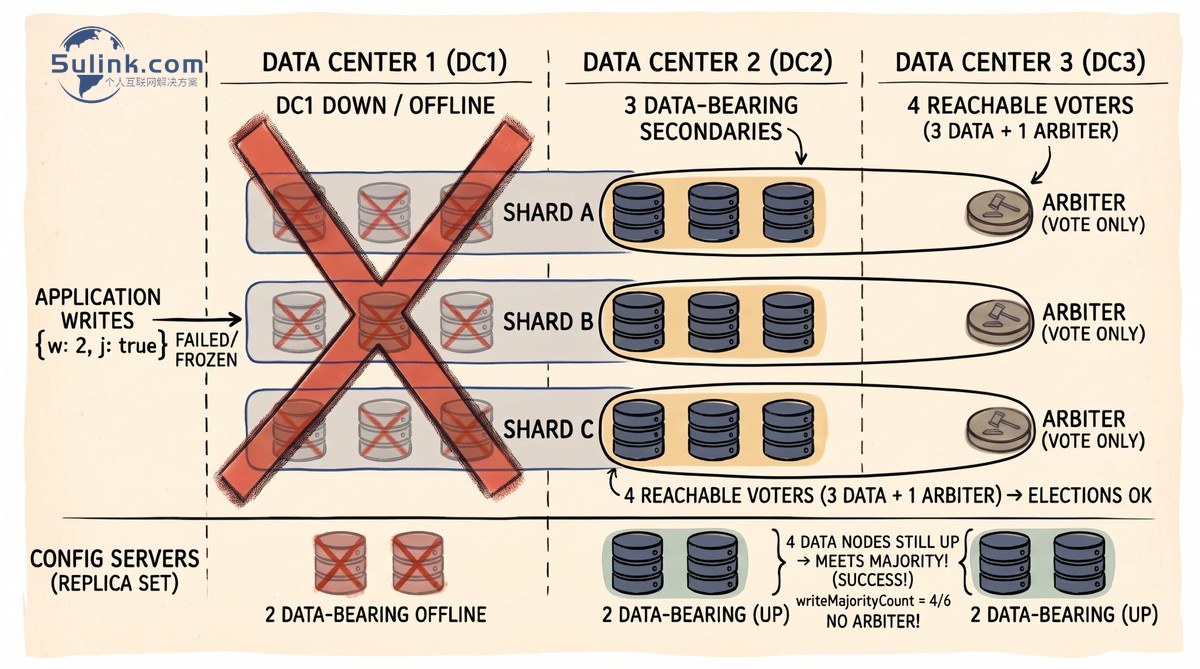
图:故障后的拓扑,仲裁节点在线但不存数据(图源:Percona 原文)
因为分片集群里有若干内部操作——包括刷新集合路由的那些——走的是带 majority 写关注的本地 no-op,它不看客户端写的 { w: 2 }。在 7 个投票成员、其中 1 个是仲裁节点的拓扑下,writeMajorityCount 等于 4。仲裁节点能投票,但它无法为一次数据写入确认。剩下 3 个可达的数据节点凑不满 4,majority 提交点就此冻结,那些刷新操作卡在一个约 60 秒的硬编码超时上。
配置服务器从头到尾没遇到这个问题:同样掉了一个数据中心之后,它的 6 个数据节点里还有 4 个活着,足够满足它自己的多数派。
3 个机房、6 个数据节点、1 个仲裁节点,纸面上是很强的拓扑。一次故障就把可用性拉了下来,因为真正要等的多数派需要 4 次数据确认,而仲裁节点不在其中。
案例二:流控来了,仲裁节点帮不上忙
另一个副本集:4 个数据节点加 1 个仲裁节点——一个机房 2 个数据节点,另一个机房 2 个数据节点,仲裁节点在第三个站点。
其中一个机房的两个 secondary 在延迟,最坏时落后约 1000 秒;主节点和另一个 secondary 状态正常。这时一个进行中的项目带来大量写入,主节点上的 oplog 生成量暴涨,并级联压到所有 secondary 上。
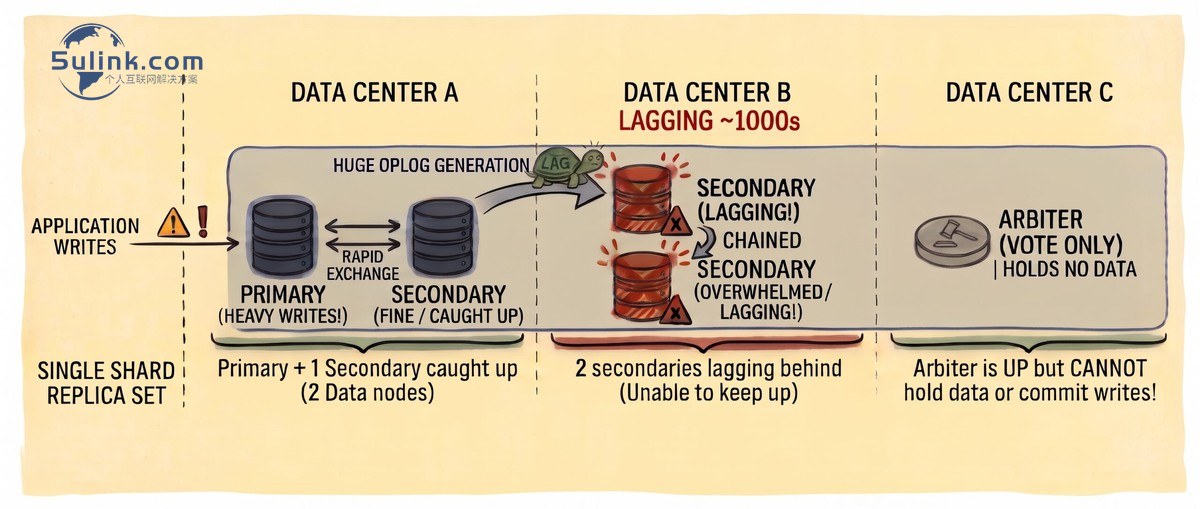
图:4 个数据节点里只有 2 个追得上,仲裁节点全程在线(图源:Percona 原文)
结果就是流控。4 个数据节点的副本集,提交点只有在至少 3 个数据节点把写入应用之后才会前进。当时追上的只有主节点加 1 个 secondary——2 个不等于 3 个,提交点停住,流控开始在主节点上给写入限速。仲裁节点全程在线,但它不存数据,所以永远不计入这一项。
案例三:P-S-A 上丢掉的一个小时
一个标准的 主-从-仲裁(P-S-A) 副本集。主节点选举优先级为 2,应用用 w: 1 写入。
主节点(N1)宕机,secondary(N2)顶上成为新主——这正是仲裁节点存在的意义。之后大约一个小时里,应用持续写入,而且这些写入都得到了确认。
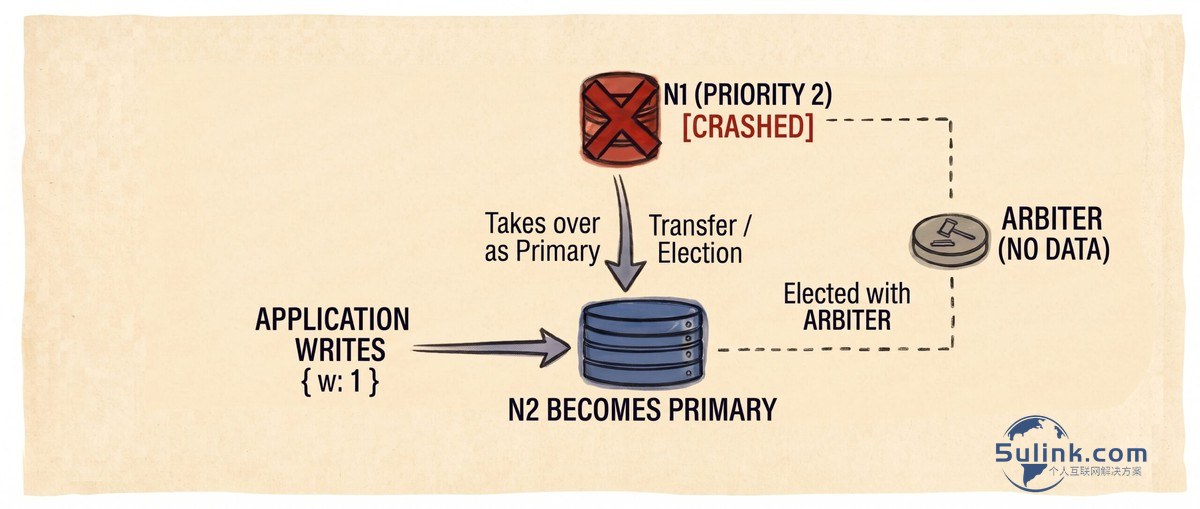
图:那一小时的写入只落在临时主 N2 上(图源:Percona 原文)
然后 N1 重新启动,副本集看起来一切正常——但那一个小时的文档不见了。
那些写入当时只存在于临时主节点 N2 上:仲裁节点不存数据,老主节点当时是宕机的,没有任何第三份拷贝。而在追赶阶段,N2 又下去了,N1 还没追平。N1 加上仲裁节点构成多数派,于是 N1 赢得选举、带着它当时的数据成为主节点。当持有那一小时写入的 N2 重新加入时,它领先于共同点,而共同点之后的那段 oplog 属于另一条历史——被回滚,去匹配一个从未见过这些写入的主节点。
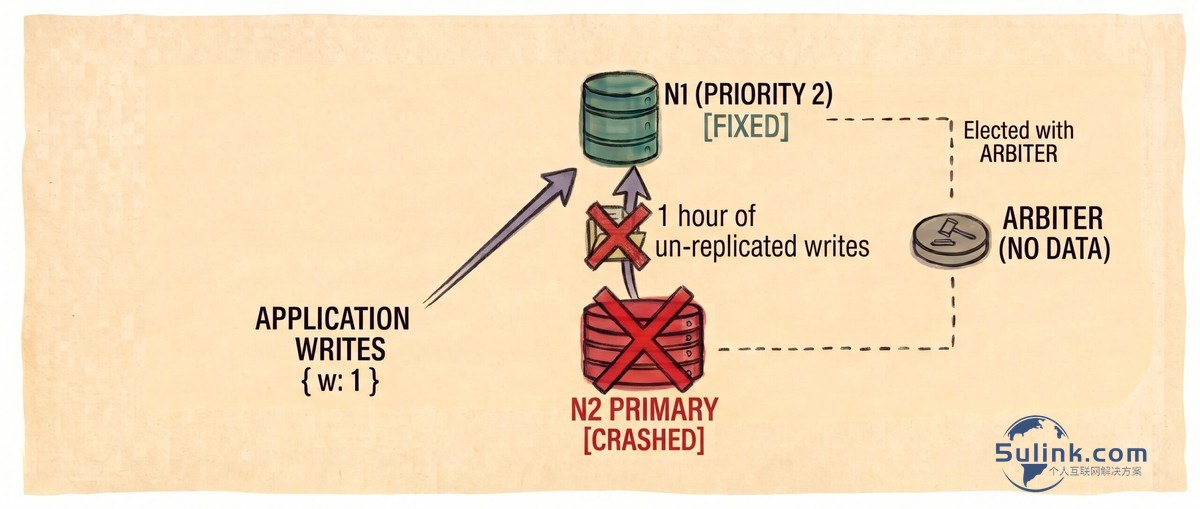
图:分叉与回滚,文档最终从磁盘上找回(图源:Percona 原文)
这些被回滚的文档其实还在磁盘上,以 BSON 形式躺在 dbPath 下的 rollback 目录里,数据就是这样找回来的——但副本集并没有把它们复制出去过。
如果第三个成员是数据节点而不是仲裁节点,故事会不一样:即使应用用 w: 1,一个活着且在复制的第三节点早就有了这些数据,它会领先于 N1、由它接任主节点,N1 从它这里追平之后再按优先级接管。
官方文档其实一直在叠警告
即使这些案例还不够有说服力,手册里同样的提醒已经堆了好几层:
| 文档建议 | 内容 |
|---|---|
| 优先使用数据节点 | 三成员副本集里 P-S-S 是推荐方案,P-S-A 只是成本兜底——冗余更弱,数据只有两份完整拷贝 |
| 不要同机部署 | 不要把仲裁节点跑在已经承载主节点或 secondary 的机器上,那台机器一挂,数据和选票一起没了 |
| 多个仲裁节点不推荐 | 从 MongoDB 5.3 起,副本集多仲裁节点支持默认关闭 |
| P-S-A 与 majority | secondary 不可用或落后时,majority 写关注会引发性能问题——P-S-A 只要有一个 secondary 出状况就够 |
| 分片键与事务 | 副本集含仲裁节点时不能用事务改分片键;跨多分片的事务只要碰到含仲裁节点的分片就会报错中止 |
| Atlas | 任何 MongoDB Atlas 层级都不支持仲裁节点 |
在已经部署了成千上万个集群的 Atlas 上,用仲裁节点替换数据节点本来是条现成的省钱路径。但权衡下来,这笔节省要付出代价:产品在用户面前失效的风险。
这笔成本账要重新算
仲裁节点过去是、现在也仍然是”用最低成本凑够奇数选票”的办法,但它从来不是获得持久性的办法,而过去十年这个产品一直在把持久性变成集群真正要等的东西。
一旦把风险和坑算进来,”省钱”这件事就开始往另一个方向倾斜:一个卡住的集群要损失多少——写入超时、拉起来的事故群、用户在仪表盘上看着一个 rs.status() 显示正常、对他们却已经不可用的产品。等你算清楚,往往已经晚了,而当初省掉的那个数据节点,才是账单上更便宜的那一行。
如果你已经是资深 MongoDB DBA,这些注意事项对你来说不是新问题,仲裁节点大概也不在你当前的头号麻烦里。对其他人,作者的建议是:生产环境避免使用仲裁节点。它造成的故障看起来不像选举问题,而这类故障恰恰是最难被发现的。
小夏点评
- 1. 这篇文章最有价值的地方,是把”多数派”拆成了投票多数和写多数两层。很多团队的拓扑评审只看投票数够不够、奇数还是偶数,而真正决定写入能不能提交的是能确认数据的那几个节点——这两套账在纸面上经常长得不一样。
- 2. 三起事故有一个共同结构:平时一切正常,故障发生的几分钟内才暴露仲裁节点”不算数”。P-S-A 拓扑的隐性代价是数据只有两份完整拷贝,而它换来的成本节省,通常抵不过一次事故群里的损失和排查工时。
- 3. 对中国 IT 运维和开发者的启示:国内用 MongoDB 的团队里,P-S-A 加仲裁节点是过去十年非常流行的”低成本高可用”方案,尤其在双机房场景。这篇文章值得当作一次拓扑体检清单——把每个副本集的 writeMajority 实际需要的确认数写下来,对照机房故障时还剩几个数据节点,比看监控面板更早发现问题。
参考链接
- – 原文:Why you should stop using ARBITERS in MongoDB(Percona Blog,2026-10-28,Jean da Silva / Sami Ahlroos)
- – MongoDB Manual:Replica Set Arbiter、Replica Set Architecture with Three Members
- – MongoDB Manual:Performance Issues with PSA Replica Sets、Concerns with Multiple Arbiters
- – MongoDB Manual:Shard Keys, Transactions and Arbiters