Agentic RAG 还是传统 RAG:2.8 轮检索、3–10 倍成本与 42% 精度增益的取舍
在企业里落地检索增强生成(RAG)的人,几乎都会遇到同一个岔路口:是把检索做成一条固定流水线,还是让它变成一个会自己规划的循环?
2026 年这个问题终于有了相对硬的数字支撑——不再只是架构图上的箭头,而是来自 Forrester、MarsDevs 等机构的对照测量:Agentic RAG 平均每个问题要跑 2.8 轮检索,在多跳查询上把检索精度抬升 42%,但代价是 3–10 倍的 token 成本和 2–5 倍的延迟。
本文以 Sphere 的生产实测长文为主源,用 StarMorph 的技术对比指南做模式与成本口径的补充,并额外标注了主源自身的商业立场——这一点在读这类对比文章时值得单独拎出来。
先把三种东西分清楚:它们不是同一层的竞品
主源开篇就点破了一个常见错误——把 ChatGPT、传统 RAG、Agentic RAG 当成菜单上的三个选项互斥选择。实际上它们是不同层次的东西,而且通常早已在同一个企业里同时运行,只是没被有意管理。
真正的问题不是”选哪个”,而是”怎么组合”。而组合的前提,是先看清每个层次在干什么。
ChatGPT 是一台通用引擎,但被误用。 到 2025 年底它约有 7 亿周活用户,对个人写邮件、总结备忘录确实好用。但在受监管的企业环境里,它变成了一个带着友好聊天界面的数据外泄通道——没有企业文档的原生连接,没有权限概念,没有「哪个文档回答了哪个问题」的审计轨迹。
而且更值得注意的是影子 AI 的规模:Netskope 2026 年《Cloud & Threat》报告发现 47% 使用生成式 AI 的用户通过个人账户使用,绕过了企业可见性、渗透到个人账户里;微软 2025 Work Trend Index 统计 75% 的知识工作者在工作中使用 AI,其中多数人用的是自带工具。
幻觉率并非已经解决。 通用生产流量中,ChatGPT 在开启思考模式下仍有 4.8% 的回答包含重大错误主张,关闭时是 11.6%(Suprmind 基准综合,2026 年 5 月)。OpenAI 的 HealthBench Professional(2026 年 4 月)显示 GPT-5 思考模式幻觉率 1.6%,对比 GPT-4o 的 15.8%——进步是十倍级的,但依然意味着每 60 个答案里有 1 个带着重大错误主张。
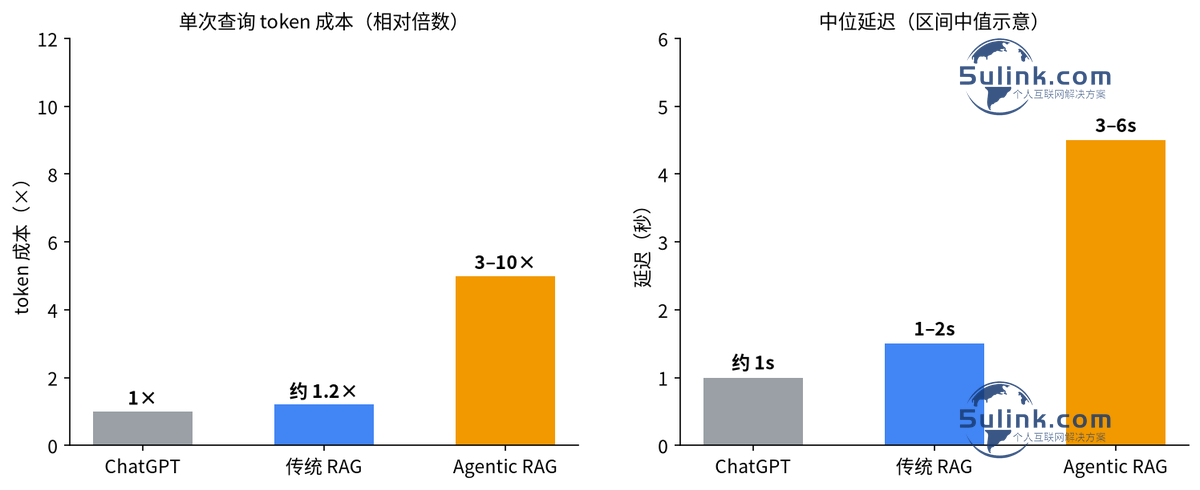
传统 RAG 是真正的生产主力。 文档切块、向量化、入库,查询时把问题向量化、检索最相近的片段、连同引用一起交给模型。它的优势非常具体:相比纯靠模型参数记忆,RAG 在开放式事实类任务上把幻觉降低 55–75%;它产出可审计的引用;它遵循源系统的权限;而这一切只需一次往返,生产级延迟通常在 1–2 秒。
Agentic RAG 是规划器加验证器。 固定的流水线被换成了一个自主循环:模型读问题,决定调用哪个工具(向量检索、关键词检索、SQL、图遍历、网页),检查返回结果,然后要么回答要么继续检索。能力集通常包括查询分解、纠错式重检索、多源编排,以及自我批判(给草稿打分再决定是否返回)。
数字部分:增益在哪,代价在哪
精度增益集中在多跳查询上
Forrester 的测量报告称,Agentic RAG 在多跳查询上的检索精度有 42% 的绝对提升——所谓多跳,就是答案需要跨文档综合,比如把三份单独看都不语义匹配的信息拼起来。
另有三项独立测量值得并排看:
| 测量来源 | 结论 |
|---|---|
| Forrester(2026-05) | 多跳查询检索精度绝对提升 42%;Agentic 系统平均每问 2.8 轮检索,约为单次检索的 3 倍 |
| arXiv 2511.18177(2025-11,SEC 10-K/10-Q/8-K 文件,150 题基准) | 向量型 Agentic RAG 对层次化节点式系统胜率 68%,延迟相当(5.2 秒 vs 5.98 秒),在 Agent 循环内加入 cross-encoder 重排带来 59% 的 MRR@5 提升 |
| StarMorph 技术指南 | DSPy 基准显示 ReAct Agent 在复杂任务上从 24% 提升到 51% 准确率 |
另一个常被忽略的差异是对歧义问题的处理。当用户问”去年研发总支出是多少”——这个问题可能指现金口径、权责发生制、资本化或费用化——传统 RAG 会返回语义最相似的那份文档;Agentic RAG 会先自己问出这个歧义问题,检索多个候选、逐一比较,然后要么给出最有依据的那个答案,要么反问用户澄清。
成本与延迟的代价是实打实的
同一份 MarsDevs 生产基准(2026 年 3 月)给出的数字是:Agentic RAG 的 token 成本是传统单次 RAG 的 3–10 倍,延迟倍数是 2–5 倍,而且 p95 更差——因为有些查询会打转六七轮检索。
StarMorph 的架构对照表给出了更细的价格带:
| 架构 | 延迟 | 质量 | 单查询成本 | 适合场景 |
|---|---|---|---|---|
| 朴素 RAG | 100–500ms | 基线 | $0.001–0.01 | 简单问答、聊天机器人、文档检索 |
| 进阶 RAG | 500ms–2s | 高 | $0.005–0.03 | 需要更高准确率的生产系统 |
| 模块化 RAG | 500ms–3s | 高 | $0.01–0.05 | 多领域企业 |
| Agentic RAG | 2–10s+ | 最高 | $0.01–0.10 | 复杂多跳推理、研究 |
| GraphRAG | 1–5s | 关系类最高 | $0.02–0.15 | 跨文档综合 |
| 自适应 RAG | 可变 | 优化 | 可变 | 混合负载(推荐) |
注意这张表里 Agentic RAG 的单查询成本区间是 $0.01–0.10。拿它乘以一个中型企业 FAQ 机器人的月查询量,就能立刻理解为什么”给每个查询都套 Agent 循环”是个危险主意——主源对此的形容是,一个 FAQ 机器人能烧出每月 5 万美元的 LLM 账单。
五种经典 Agentic RAG 模式
成本倍数的差异,其实来自你在循环里放了哪种”思考动作”。StarMorph 归纳了五种已经确立的模式:
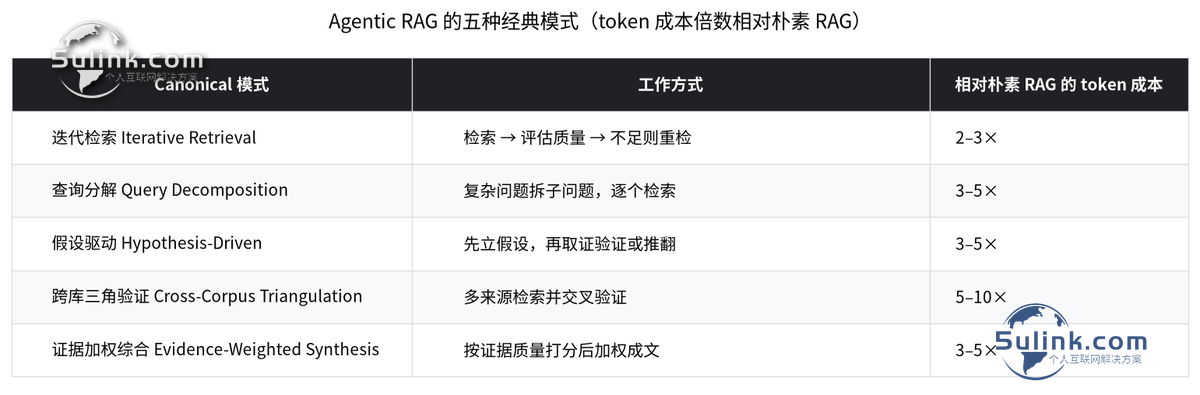
这五种模式的 token 成本倍数是相对朴素 RAG 而言的,各自适合的查询类型也不同——例如跨库三角验证(5–10×)适合需要多个来源互相印证的高风险问题,而迭代检索(2–3×)是成本最低的升级路径。
框架层面,LangGraph、LlamaIndex Agents、Microsoft AutoGen 和 CrewAI 都支持这些模式,其中 LangGraph 目前是生产级 Agent 循环最成熟的选项(支持工具路由与人在环)。
失败模式:没人提前警告你的三种
这是整篇文章里对运维最有价值的部分。Agentic RAG 引入了传统 RAG 根本不存在的失败模式。
级联错误。 Agent 第一轮检索到一篇不相关的文档,这份错误上下文进入第二轮的规划提示,把 Agent 带上一条它再也回不了头的路。等到答案生成出来,模型自信地回答着一个检索层从未提供依据的东西。
失控循环。 没有严格的迭代上限,一个找不到好上下文的 Agent 会一直尝试,燃烧 token 和延迟,直到超时或者返回一个劣化的答案。主源给的生产建议很具体:显式的最大迭代限制(通常 3–5 轮)加超时保护,否则一个模糊查询就能消耗掉一百个正常查询的预算。
评估者悖论。 用 LLM 给 LLM 的输出打分——Agentic 验证步骤让模型自我批判自己的草稿,做的正是这件事,而这个判断的质量受限于底层模型的质量。当同一个模型既生成又评估时,系统性偏差会累积而不是相互抵消。缓解办法是集成评估(不同模型互评)或者在冻结的黄金集上做人工抽检——两者都增加了厂商 pitch 里通常省略的成本。
生产落点:几乎没人跑纯 Agentic RAG
2026 年企业 AI 部署里最接近”公开的秘密”是:几乎没有人把纯 Agentic RAG 跑在生产上。成本太高、延迟太痛,而 80% 的查询根本不需要它。
真正的生产模式是自适应路由:一个轻量分类器模型先看每个问题,判断它是简单的(查单文档、单一事实、无歧义)还是复杂的(多跳、歧义、高风险),然后分路。多数主流 Agentic RAG 平台底下的默认就是这套——Advanced RAG 加混合检索加重排、Agent 循环只在简单路径拿不到足够上下文时才启动。
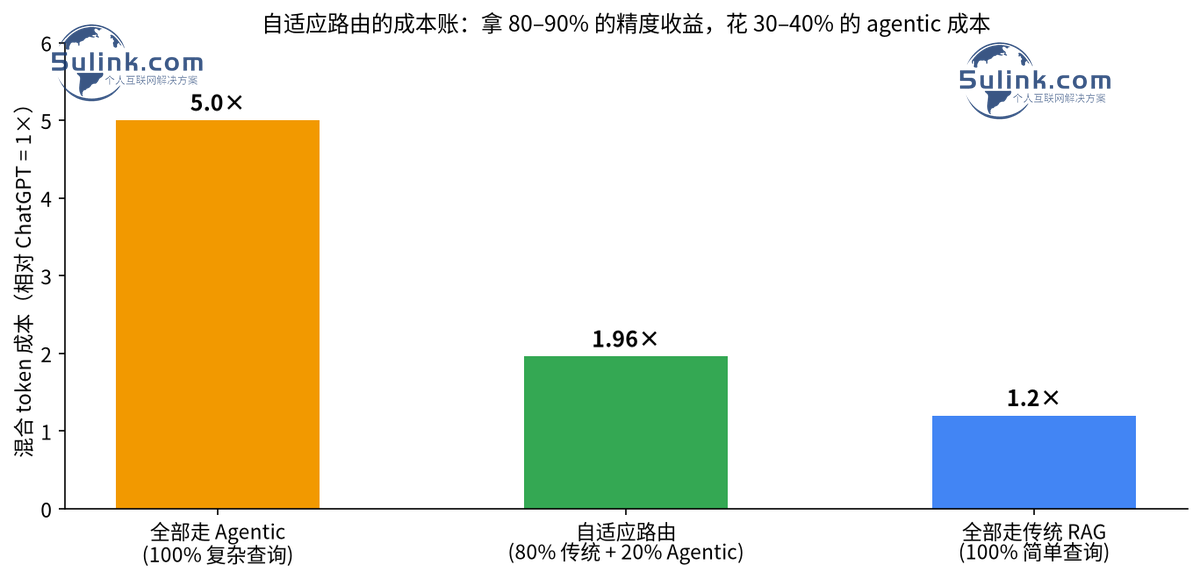
成本账很清楚:如果 80% 的查询走传统 RAG(1.2× 成本),只有 20% 走 Agentic 路径(5× 成本),混合成本大约是 1.96×——不到全部走 Agent 循环的一半成本,却仍然抓住了精度增益真正有价值的部分。生产基准的估计是:这套模式能捕获纯 Agentic RAG 80–90% 的准确率提升,只花其 30–40% 的成本。
关于主源的一个提醒
必须说明的是,本文主源 Sphere 是一家企业 AI 交付服务商,其文章末尾有明显的自家产品(SphereIQ)推介段落。上面引用的成本、延迟、精度数字本身引用了 Forrester、MarsDevs、arXiv 等第三方,但「私有 RAG vs 云 RAG」的对照表本质上是厂商立场——它把自家私有部署列为合规审查中”唯一能过”的那一栏。这个结论在受监管行业有现实依据,但读者应当把它读作利益相关方的论证,而不是中立评测。
同理,StarMorph 是技术博客,其架构表是作者自己的归纳口径,与 Forrester 的测量口径不完全一致,本文在引用时会分别标明来源。
选型决策:四个问题按顺序问
主源给出的决策顺序是合理的——跟着约束走,而不是跟着技术走:
- 1. 用户是公众还是你的员工? 对外场景(客户支持、知识库聊天)的准确率门槛和责任敞口都更高,这会把决策推向 RAG 而非 ChatGPT。
- 2. 典型查询需要一份文档还是好几份? 单文档(HR 政策、产品规格、FAQ)适合传统 RAG;多文档(研究、跨文档分析、合规调查)需要 Agentic。
- 3. 答错的代价多大? 客户支持里答错只是让人烦;医疗诊断或合规声明里答错是监管事件。赌注越高,越能承受单查询的溢价。
- 4. 什么法规管辖你的数据? 每一项都会叠加文档要求,从而决定哪些平台能过审、哪些卡在安全评审。
小夏点评
一、42% 这个数字必须带条件读:它衡量的是多跳查询的检索精度,不是整体问答准确率。 这是这类对比文章最常见的偷懒——把一个条件性指标包装成”Agentic RAG 精度高 42%”。真实含义是:在需要跨文档综合的难题上,多花几轮检索能换回明显的检索质量;但在单文档、单事实的查询上,这个增益基本不存在,反而付出了 3–10 倍的代价。所以正确的读法不是”要不要上 Agentic RAG”,而是”我的查询分布里多跳问题占多少“。如果你的客服工单里 80% 是”退款政策是什么”这种单文档问题,那么把 42% 当作决策依据就是典型的指标误用。
二、2.8 轮是一个平均值,不是一个上限——真正需要盯的是它的尾部。 主源提到 p95 更差的原因是有查询会打转六七轮,而失控循环加级联错误是两种截然不同的坏结局:前者是账单问题,后者是正确性问题。生产上唯一能同时管住这两件事的,是显式的迭代上限(3–5 轮)加超时保护加人工抽检黄金集。我见过不少团队上了 Agentic 循环却没设硬上限,结果不是效果不好,是账单先爆。任何要上 Agentic RAG 的项目,第一件要做的事是把 max-iterations 这个参数写进配置文件并纳入告警,而不是等出事再补。
三、给国内 IT 运维和开发者的启示:把”要不要 Agentic”这个问题,换成”路由器怎么写”。 三条具体建议:其一,先上自适应路由,而不是先上 Agentic RAG——用一个轻量分类器(甚至基于查询长度和关键词的启发式规则就能覆盖大部分判断)把简单查询挡在传统路径外面,这条路的成本曲线远比一步到位全量 Agentic 平滑,而且随时可以调阈值;其二,给 Agent 循环配一套”失败可观测”,而不是只配成功率监控——级联错误在监控上表现为”正常返回了答案”,不专门记录每轮的检索结果与自评分数就根本发现不了,这是国内团队做 RAG 时最常漏的一环;其三,成本护栏要按”最坏查询”设计而不是按”平均查询”设计——2.8 轮是均值,1.96× 的混合成本也是均值,真正的账单风险来自尾部,而尾部的控制手段就是迭代上限、超时、以及给模糊查询主动反问澄清而不是硬答。一个务实的验收标准是:先证明你的查询分布里确实存在足够比例的多跳问题值得 3–10 倍溢价,再去建那条昂贵的路径。
参考链接
- – 主源:Sphere《Agentic RAG vs Traditional RAG vs ChatGPT》(2026-05-19,Olga Kofanova;成本/延迟/精度数据来源标注为 Forrester 2026-05、MarsDevs 2026-03)https://www.sphereinc.com/blogs/agentic-rag-vs-traditional-rag-vs-chatgpt
- – 补充源:StarMorph《RAG Techniques Compared: A Practical Guide to Retrieval Augmented Generation in 2026》(2026-04-21;五种 canonical 模式与架构成本表来源)https://blog.starmorph.com/blog/rag-techniques-compared-best-practices-guide
- – 引用研究:arXiv 2511.18177,SEC 10-K/10-Q/8-K 文件上的 Agentic RAG 基准 https://arxiv.org/pdf/2511.18177
- – 引用数据:RAGAboutIt《5 agentic RAG metrics that surprised Forrester researchers》 https://ragaboutit.com/5-agentic-rag-metrics-that-surprised-forrester-researchers/
- – 引用数据:Netskope《Cloud and Threat Report 2026》(47% 的 genAI 用户使用个人 AI 应用口径)https://www.netskope.com/resources/cloud-and-threat-reports/cloud-and-threat-report-2026
- – 补充报道:Cybersecurity Dive《Risky shadow AI use remains widespread》(引述 Netskope 2026 版报告的 47% 口径)https://www.cybersecuritydive.com/news/shadow-ai-security-risks-netskope/808860