把服务器塞进桌下:MSI XpertStation WS300 实测,一台 GB300 桌面超算
MSI 这台 XpertStation WS300 是 STH 测过的第二台 NVIDIA DGX Station 系统(上一台是技嘉 W775-V10-L01)。这类机器的本质是:第一次把 NVIDIA 服务器级硬件 GB300 装进桌边塔式机箱,让开发者在本地跑 AI 负载。1.6kW 最大功耗、全套闭环液冷,一台塔式机塞进了能塞下的全部服务器硬件。
和前作一样,这次测试也没让单机孤跑:两台 DGX Station 通过 ConnectX-8 SuperNIC 组网,跑通了 800Gbps 聚合的 Blackwell Ultra 对 Blackwell Ultra RDMA。前 AI 时代的工作站把网络当附属品,而在这里,网络和液冷是这台机器的中心设计。
整机规格一览
| 项目 | 规格 |
|---|---|
| CPU | NVIDIA Grace 72 核 Neoverse V2(72C/72T) |
| GPU | NVIDIA Blackwell Ultra(B300 微调版) |
| 内存 | CPU 侧 496GB LPDDR5X(396GB/s);GPU 侧 252GB HBM3E(7.1TB/s) |
| 存储 | 2× M.2 2280(PCIe Gen6 x4)+ 2× M.2 2280(PCIe Gen5 x4) |
| 网卡 | 2× 400Gbps QSFP112(ConnectX-8)+ 10GbE(RJ45)+ 1GbE BMC |
| 显卡(可选) | NVIDIA RTX PRO Blackwell 2000/4000/6000 |
| 电源 | 1600W 80 PLUS 白金 |
| 机箱 | 塔式工作站,529 × 570 × 246 mm,重近 30kg |
| 系统 | Ubuntu 24.04 LTS + NVIDIA AI 开发工具链 |
外观:为散热和地面而设计
整机黑漆、不张扬,看不出是台 10 万美元级的系统。与技嘉那台前脸全封闭不同,WS300 的前脸是敞开的——三角网格后面就是机器内部,右侧罩着散热器,三把风扇往里抽风。MSI 把整个前面板让给了气流,所以接口全部挪到顶边:2 个 USB-C + 2 个 USB-A,全部 10Gbps,没有 USB4——GB300 平台本身不提供,想更快只能走双 400G QSFP112。
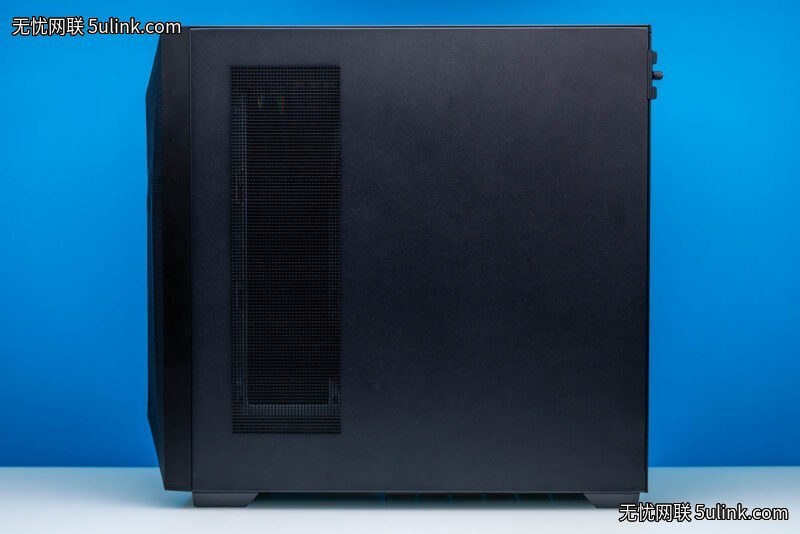
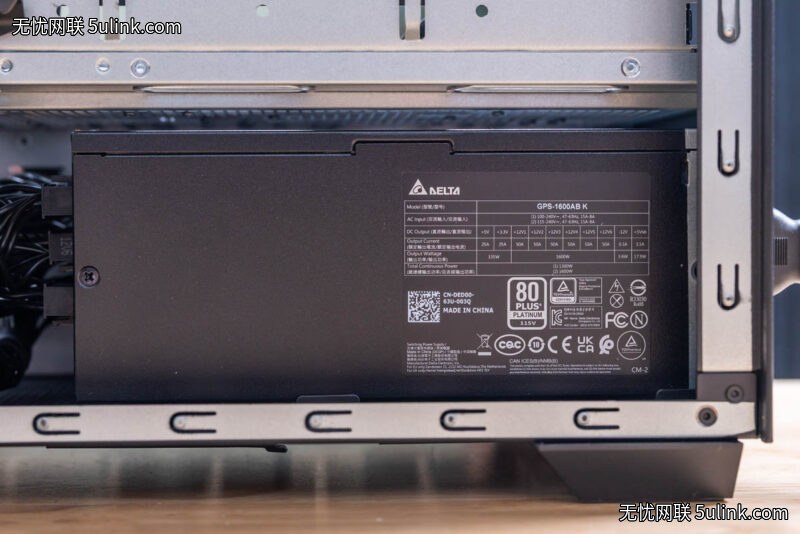
考虑到体积、重量和发热,MSI 明确把它设计成落地机:顶置电源键带绿色 LED,复位键做了深凹防误触。电源是 1600W 白金 Delta,需要 C19 电源线和 20A 独立电路——这台机器实际上要求专线供电。
内部:液冷回路比主板更抢眼
标准 ATX 机箱的好处是好拆:每侧一块侧板、一颗螺丝。左侧看过去,PCIe 插槽、M.2、冷板、液冷管路一目了然。
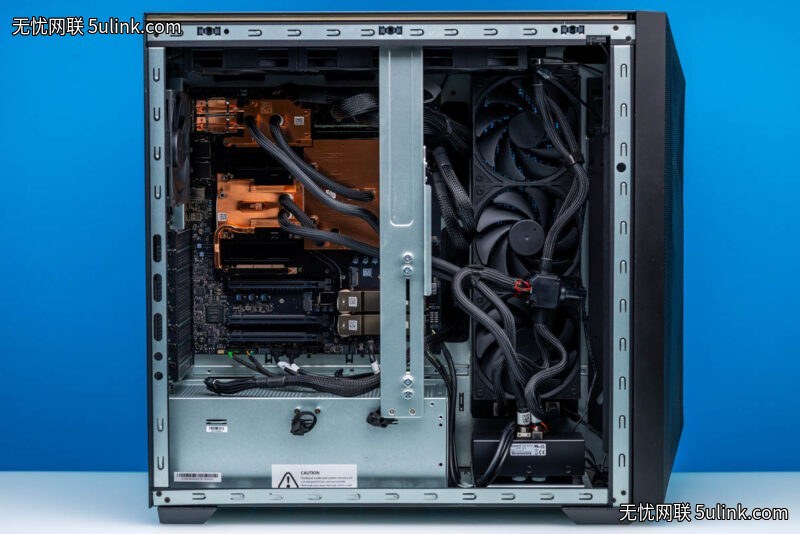
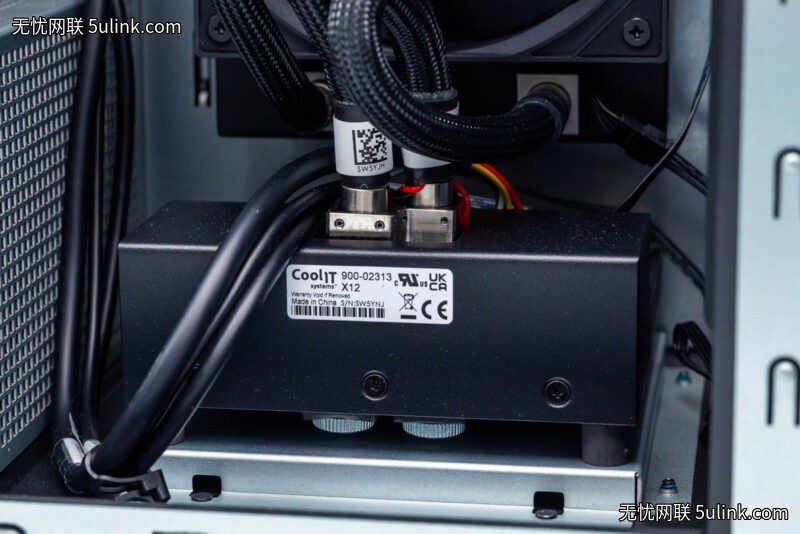
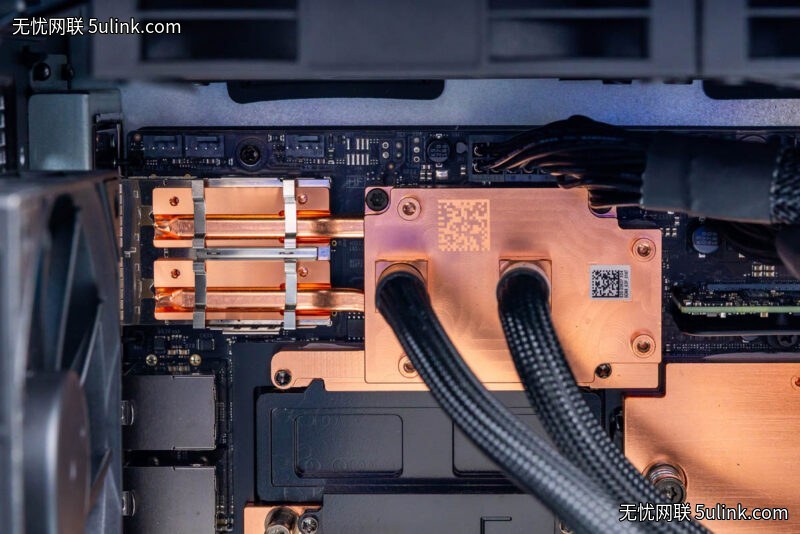
NVIDIA 强制所有 DGX Station 用液冷:冷板覆盖 Blackwell Ultra GPU、Grace CPU、ConnectX-8 网卡三颗大芯片,连 Grace 的 LPDDR5X SOCAMM 内存条都压在冷板下面——想拆内存基本等于放弃保修。回路是闭环设计,但更像精心组装的开环:前置泵+水箱(CoolIT 出品),两具 360mm 冷排分列右侧和顶部排气。注意:与技嘉不同,这台机器没有漏液检测托盘。
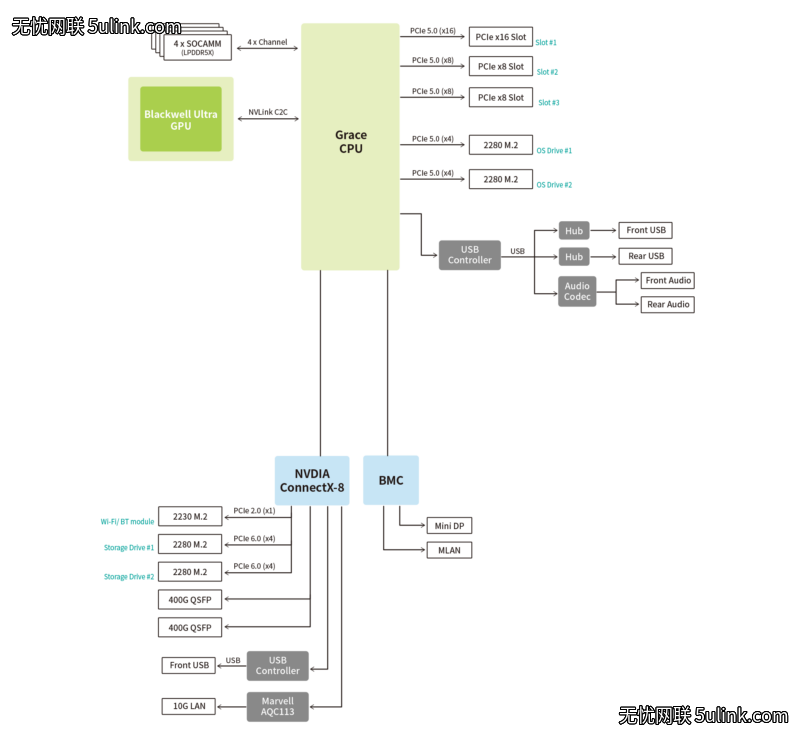
扩展方面:三条物理 x16 插槽(顶槽 Gen5 x16,下两条 x8),全部挂在 Grace 上;顶槽支持官方认证的 RTX PRO Blackwell 显卡(2000/4000/6000,Max-Q 鼓风版也在名单里),机箱里专门做了一根带活动支架的金属承重梁帮显卡分担重量。四个 M.2 2280 里有两个直连 CX8 的 PCIe Gen6 x4——让 GPU 可以绕过 Gen5 直接读固态。管理侧是 OpenBMC,带 HTML5 iKVM 和全套传感器遥测,按服务器方式运维。
拓扑:这台机器真正的信息量所在
GB300 超芯片 = Grace CPU + Blackwell Ultra GPU + ConnectX-8 SuperNIC。Grace 是 72 核 Neoverse V2(300W 功耗墙),512-bit LPDDR5X 总线拆成四条 128-bit SOCAMM;B300 GPU 启用 7 个 HBM3E 栈,算力上限 20 PFLOPS FP4 / 10 PFLOPS FP8。
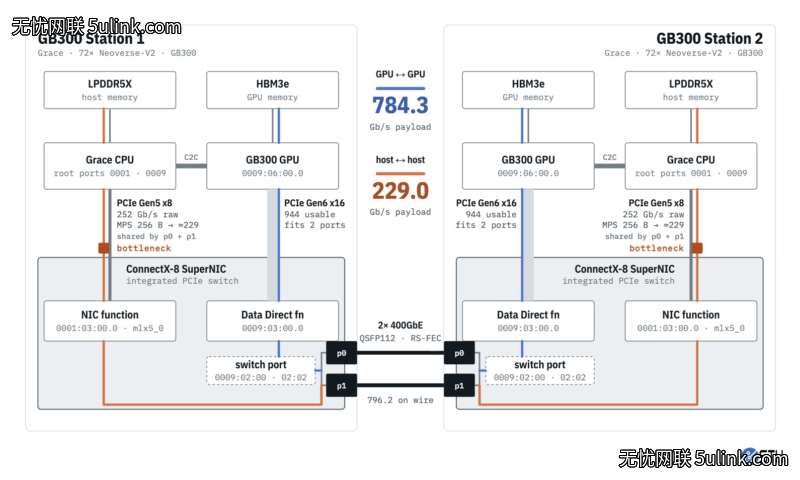
实测链路带宽揭示了设计意图:
| 链路 | 规格 | 实测 |
|---|---|---|
| GPU → CX8 | PCIe Gen6 x16 | 968Gbps |
| CPU → CX8 | PCIe Gen5 x8 | 228.9Gbps |
| GPU 对 GPU RDMA(双 400G) | 双轨聚合 | 784.3Gbps |
| CPU 对 CPU(双 400G) | 受 Gen5 x8 限制 | 229.0Gbps |
GPU 到网卡是全场最快链路,足以喂饱两条 400GbE;CX8 上还挂着两条 Gen6 M.2(GPU 可按 30GB/s 满速读取)。STH 的原话是:在这套拓扑里,Grace 几乎成了”第三配角”,CX8 才是 GPU 最重要的帮手。跑 RDMA 时能看到 392-400Gbps 的单轨流量,CPU 占用只有约 1.4%(还是轮询造成的)。
性能:CPU、GPU 与 C2C
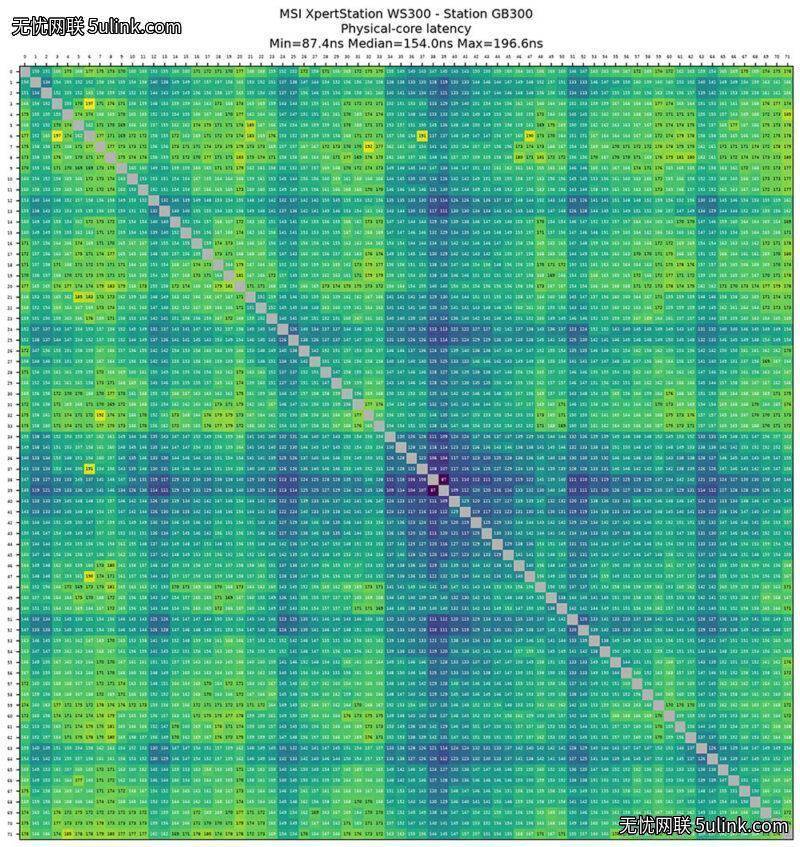
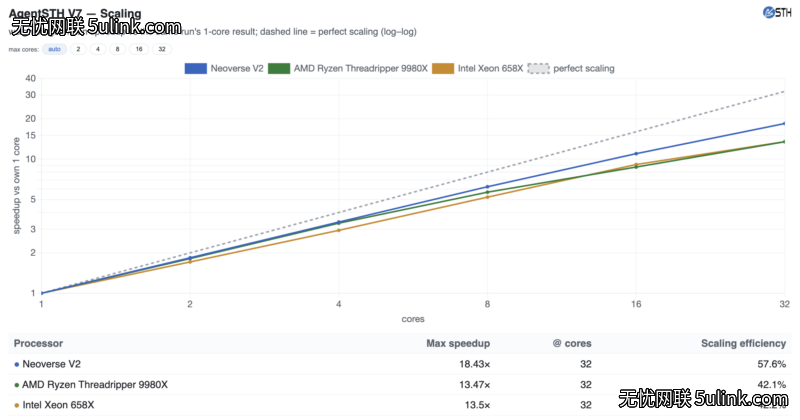
Grace 是单片设计,核间延迟图非常规整;lmbench 内存延迟符合平台惯例。在 AgentSTH V7 上,300W 功耗墙的 Grace 单核跑不过高主频 x86(Threadripper、Xeon 658X 有 SMT 加持),但扩展性反超:在 1-32 核区间稳定压过对手——AI agent 实际常用 2-4 核,Grace 的架构在这个区间效率很高。三台 DGX Station 横评差距在 ±2% 以内。
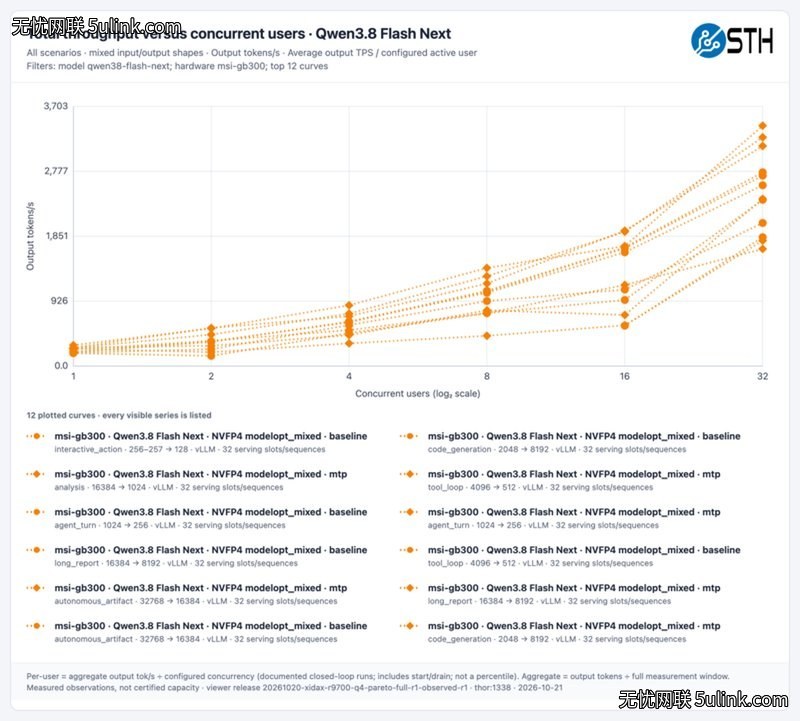
GPU 侧,STH 用优化后的 Qwen3.8 Flash Next 对比一年前的 GPT-OSS-120B,做了”一年前后”对照——结论是模型更大更快了,值得投入的机器要能陪你用更久。多种工具调用场景在 c=32 并发下吞吐突破 3000 tokens/s 且还在爬升,MTP(多 token 预测)对结果帮助明显。
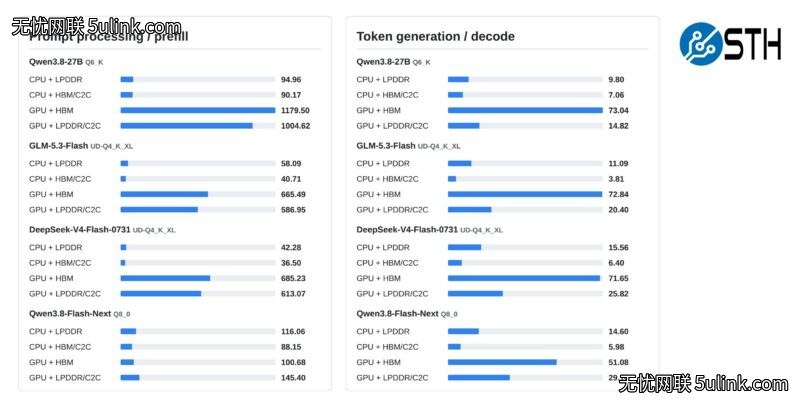
C2C 实验是实用信息:把模型权重放 LPDDR5X、经 C2C 喂给 GPU,比让 CPU 用自己的本地 LPDDR5X 直接跑更快;反过来,prefill 这种算力型阶段跨 C2C 表现好,但 decode 阶段一定要用 HBM。Grace 单侧内存带宽已超过 GB10、Strix Halo 这类统一内存方案——用 LPDDR5X 扩容量、用 HBM 做解码,是这套架构的正确用法。
功耗与噪音
GPU 功耗墙 1.3kW、CPU 300W,整机上限就是电源的 1.6kW;待机功耗不低于 250W。低负载噪音 37-40 dBA,满载 46-49 dBA——能把 1.6kW 的设备做到”可以放桌边”本身就是工程成果。STH 特别提醒:预算内再加一块 RTX PRO 6000 会让原有部件紧张,除非真要渲染桌面,否则慎加。
收尾判断
STH 三台实测后的结论:WS300 单机、组网都零故障,性能与 DGX Station 平台预期一致;装机、装系统、整套生命周期在 Arm 上已经完全跑顺(他们甚至完整走了一遍串口恢复+重装)。如果非要挑刺,是机箱——散热功劳很大,但”看起来不够贵”。更重要的是观念:这类机器理想状态是 24×7 运行、按服务器管理,公司里买两台以上就该规划 400Gbps 网络——每个工位预布两根 MTP-12 光纤,800Gbps 组网才有意义。
小夏点评
- 这台机器的核心资产不是 GPU,是拓扑——GPU 直连网卡的 Gen6 x16(968Gbps)决定了它能从单机长到集群;单台 252GB HBM 只是入场券,两台组网才是这套设计的完整形态。
- 1.6kW 是硬预算:电源封顶后,加显卡、加盘都在挤 GPU/CPU 的功耗。这类”工作站”本质是服务器,采购时按机房标准(专线电路、噪音、24×7)评估,别按办公桌标准。
- 对中国 IT 运维/开发者的启示:国内团队开始采购 DGX Station 级设备做本地推理和小规模训练,落地时最容易低估的是电力和网络——20A 独立电路、400G 光模块、跨工位光纤布线都要提前预算。多台部署时先布 MTP 光纤再谈性能,否则这台机器最值钱的部分(RDMA 组网)直接归零。
参考链接
- 原文:https://www.servethehome.com/msi-xpertstation-ws300-review-nvidia-dgx-station-gb300/
- 前作(技嘉 DGX Station 首测):https://www.servethehome.com/gigabyte-w775-v10-l01-hands-on-bringing-nvidia-gb300-deskside/