量产硬件到货,规格随之改口:NVIDIA 把 Rubin 的 HBM4 带宽和 NVLink 都往下调了
2026 年第四季度开局,NVIDIA 和合作伙伴正处在 Vera Rubin 的量产爬坡段——头部云厂商已经开始把首批 NVL72 系统开放给客户。产品线走到量产这个节点,NVIDIA 也把出货规格最终定了下来。而这份”定稿”和一年前发布会上的宣传数字相比,动了两处:单卡 HBM4 内存带宽和 NVLink 带宽都往下调了,Scale-out 网络带宽反而加了。
单卡 Rubin:算力守住,带宽让路
| 指标 | 原宣传 | 出货 | 变化 |
|---|---|---|---|
| NVFP4 推理 | 50 PFLOPS | 50 PFLOPS | 不变 |
| NVFP4 训练 | 35 PFLOPS | 35 PFLOPS | 不变 |
| INT8 | 250 TOPS | 250 TOPS | 不变 |
| TF32 | 2 PFLOPS | 2 PFLOPS | 不变 |
| 显存容量 | 288GB HBM4(8×36GB) | 288GB HBM4(8×36GB) | 不变 |
| 显存带宽 | 22TB/s(8×2048@10.75Gbps) | 19.2TB/s(8×2048@9.375Gbps) | -11% |
| NVLink(Scale Up) | 3.6TB/s | 3.0TB/s | -17% |
| 网络(Scale Out) | 0.4TB/s | 0.45TB/s | +12.5% |
表:Rubin GPU 宣传规格 vs 出货规格
带宽这一笔要拆开算:原计划每颗 HBM4 堆跑在 10.75Gbps/pin,现在落到 9.375Gbps/pin,单针掉 1.375Gbps,约 11%。这个数字仍然很激进——HBM4 规范把每堆总线宽度从 1024 bit 翻倍到 2048 bit,但官方规范只要求跑到 8Gbps/pin(比 HBM3E 的主频还略低)。NVIDIA 原来那个 10.75 是明显超出规范的,即便降下来这一档,也仍然高出一截。
作为对照,对手 AMD 的 MI455X 上 HBM4 只跑 7.6Gbps/pin。NVIDIA 目前没有解释为什么调整内存带宽规格。合理的推测落在”做不到”上——内存控制器速度、内存堆速度、堆的良率和(能跑到目标频率的堆有多少),或者这几样加在一起。不管原因是什么,结果很明确:客户手里可用的显存带宽变少了,这会计入性能。
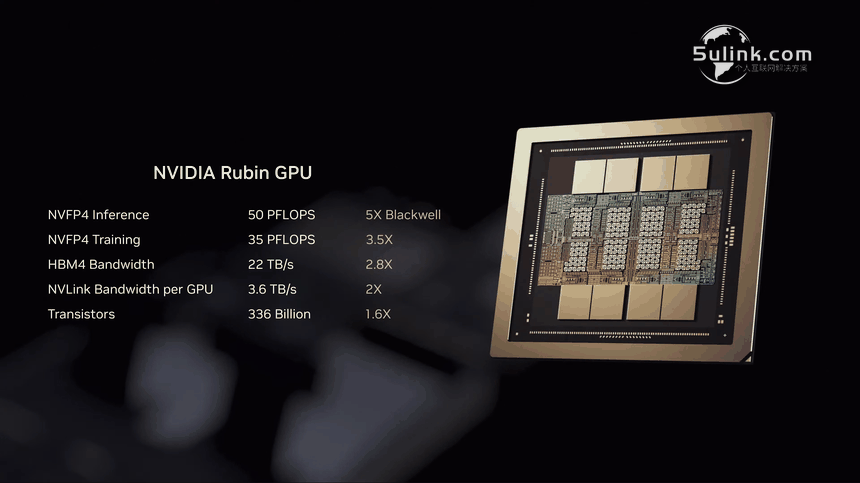
图:NVIDIA CES 2026 主题演讲现场的 Rubin GPU(图源:ServeTheHome)
NVLink 这边同样缩水:原宣传每颗 Rubin GPU 有 3.6TB/s,现在定在 3.0TB/s,少 600GB/s(17%)。NVLink 一直是 NVIDIA 用来把一堆物理 GPU 攒成”逻辑上一颗”的手段,历来也是把物理极限榨得最狠的地方。
反过来的那头是网络:单卡 Scale-out 带宽从 400GB/s 提到 450GB/s。除此之外其余规格不动——纸面算力仍按 FP4 推理 50 PFLOPS、FP4 训练 35 PFLOPS 交付,说明频率和显存容量这两项目标都守住了。
NVL72 整机柜:跟着单卡同步缩水
| 指标 | 原宣传 | 出货 | 变化 |
|---|---|---|---|
| NVFP4 推理 | 3600 PFLOPS | 3600 PFLOPS | 不变 |
| NVFP4 训练 | 2520 PFLOPS | 2520 PFLOPS | 不变 |
| INT8 | 18 POPS | 18 POPS | 不变 |
| TF32 | 144 PFLOPS | 144 PFLOPS | 不变 |
| 显存容量 | 20.7TB HBM4 | 20.7TB HBM4 | 不变 |
| 显存带宽 | 1580TB/s | 1400TB/s | -11% |
| NVLink(Scale Up) | 260TB/s | 216TB/s | -17% |
| 网络(Scale Out) | 28.8TB/s | 32.4TB/s | +12.5% |
表:Vera Rubin NVL72 宣传规格 vs 出货规格(PFLOPS 列见文末说明)
机柜级的数字是跟着单卡同步换算的:累计显存带宽从 1580TB/s 掉到 1400TB/s,净少 180TB/s;显存容量维持 20.7TB HBM4 不变。NVLink 域从 260TB/s 降到 216TB/s,17% 的降幅与单卡的 3TB/s 对得上。
NVL72 唯一的好消息是拿到了和单卡一致的网络加成——原本 28.8TB/s,现在提到 32.4TB/s(双向)。也就是说,对 Scale-out 网络依赖重的大型部署,现在能用的带宽比最初的预期更多。
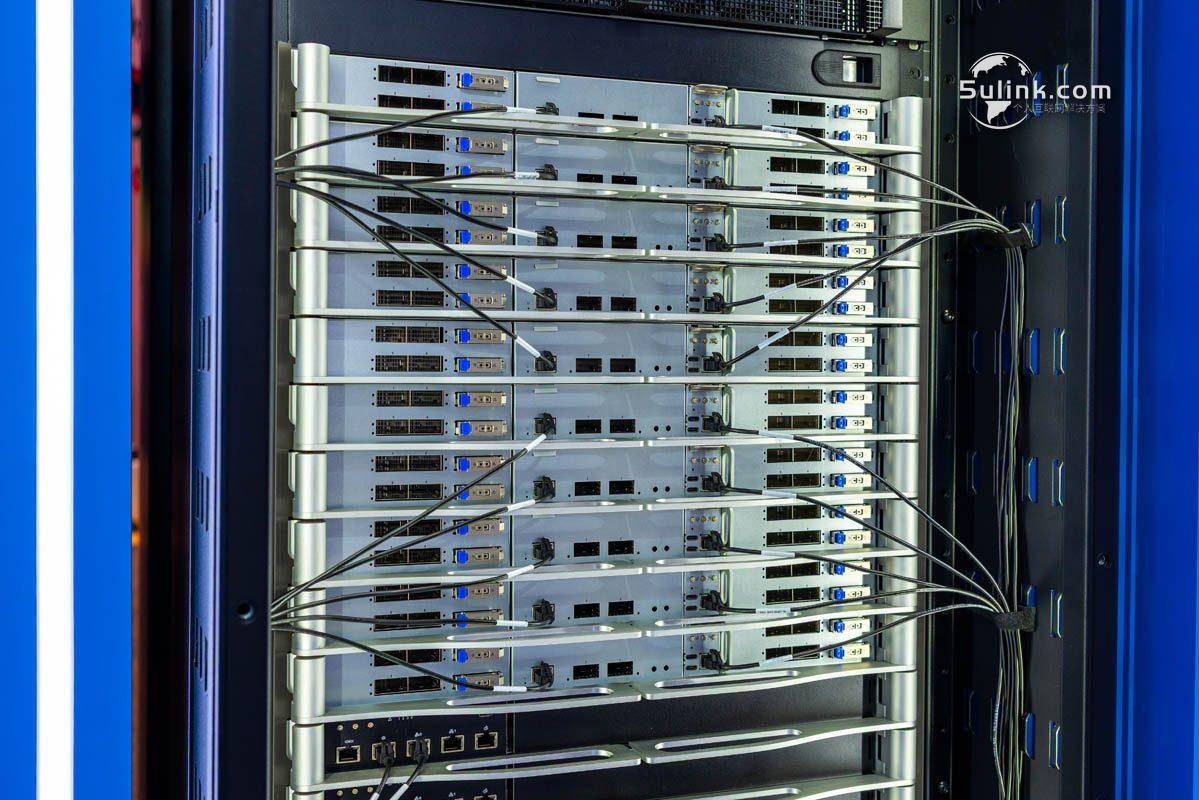
图:Gigabyte GTC 2026 展台的 Vera Rubin NVL72 整机柜(图源:ServeTheHome)
HGX Rubin NVL8:这一档挨的打最重
| 指标 | 原宣传 | 出货 | 变化 |
|---|---|---|---|
| NVFP4 推理 | 400 PFLOPS | 400 PFLOPS | 不变 |
| NVFP4 训练 | 280 PFLOPS | 270 PFLOPS | -3.6% |
| FP8 训练 | 140 PFLOPS | 130 PFLOPS | -7.1% |
| TF32 | 16 PFLOPS | 16 PFLOPS | 不变 |
| 显存容量 | 2.3TB HBM4 | 2.0TB HBM4 | -13% |
| 显存带宽 | 176TB/s | 130TB/s | -26% |
| NVLink(Scale Up) | 28.8TB/s | 24TB/s | -17% |
| 网络(Scale Out) | 1.6TB/s | 1.8TB/s | +12.5% |
表:HGX Rubin NVL8 宣传规格 vs 出货规格
NVL8 是唯一在内存容量上被动刀的 Rubin 产品:从 2.3TB 降到整 2.0TB,少 300GB(13%)。这一改的连锁反应很值得琢磨——原来 2.3TB 意味着每台机器里 8 颗 Rubin 都得是”满配 288GB”;而按 2.0TB 走,每颗只需要 250GB 左右就够了,换句话说每颗 GPU 只用上 8 个 HBM4 堆里的 7 个。
于是 NVL8 吃到了整个 Rubin 家族里最狠的带宽削减:不是降 11%,而是降 26%,约 46TB/s。单卡口径落到 250~252GB 容量、16.8TB/s 带宽。
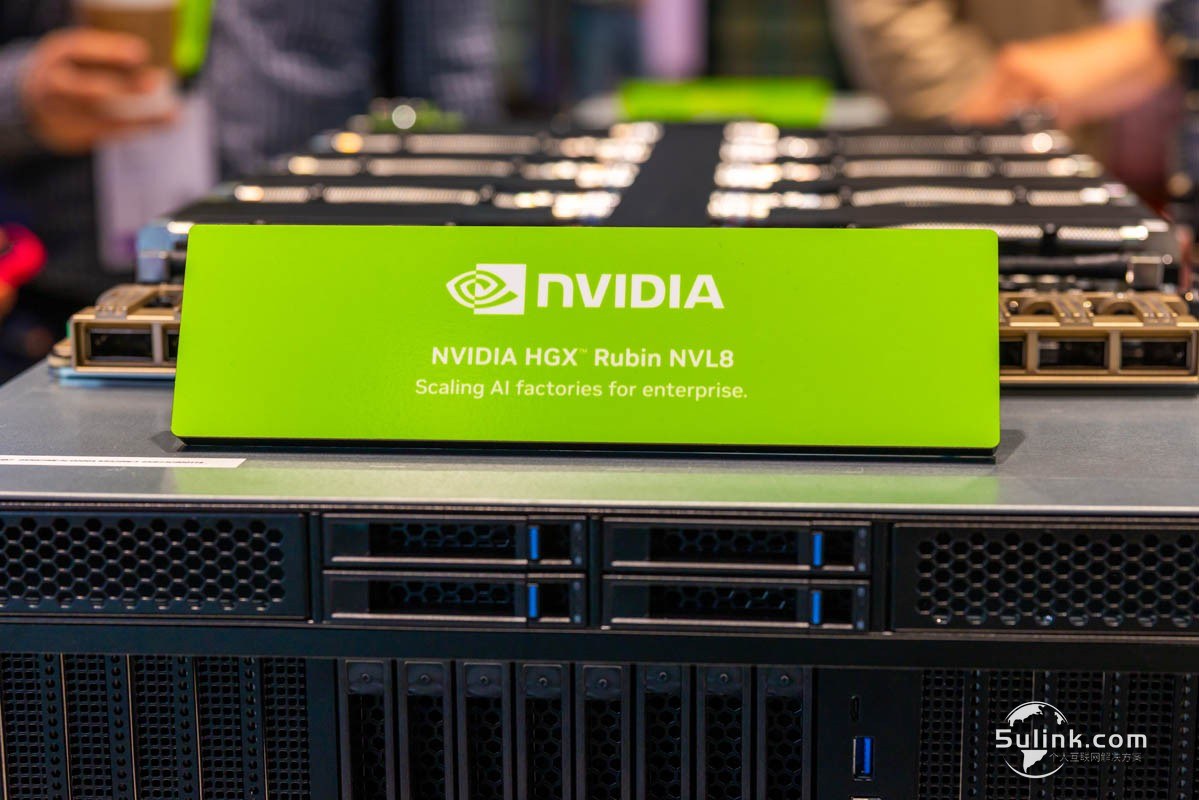
图:Aivres GTC 2026 展台的 HGX Rubin NVL8(图源:ServeTheHome)
推理算力守住 400 PFLOPS(FP4),但 FP4 训练从 280 降到 270 PFLOPS、FP8 训练从 140 降到 130。网络同样吃到家族加成,从 1.6TB/s 提到 1.8TB/s。
这些改动对两种 HGX NVL8 以及基于 NVL8 的 DGX 系统一并生效——HGX Rubin NVL8(Rubin + x86)和 HGX Vera Rubin NVL8(Rubin + Vera)用的是同一套 GPU。
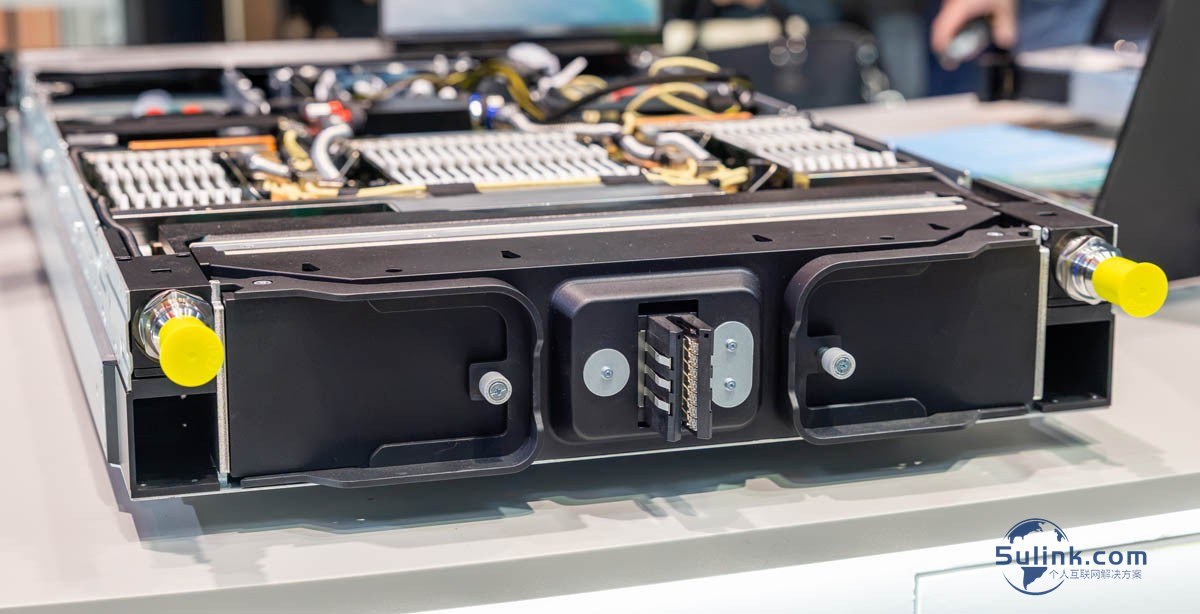
图:Aivres OCP Summit 2026 展出的 2U 液冷 HGX Rubin NVL8 计算托盘(图源:ServeTheHome)
小夏点评
- 1. “7 个堆栈跑 2.0TB”这条比任何百分比都更有信息量。 满配 die 只启用 7 个 HBM 堆,等于用产能和良率换出货量——能这么改,说明 NVIDIA 对今年要交多少张卡的目标,比”每颗都必须满配”更重要。做集群采购的人应该按出货规格算账,别再用发布会那张表。
- 2. 一次很典型的”算力不动、周边重排”再平衡。 算力(FP4 50/35 PFLOPS)和容量都按承诺交付,让出去的是内存带宽和 NVLink——这两项恰恰是长上下文推理和大 EP 训练最容易堵的地方。Scale-out 反向加了一档,也透露出这批系统的实际工作负载画像:跨机网络比机内互联更吃紧。
- 3. 对中国 IT 运维/开发的启示:国内拿到的 Rubin 会是同一份出货规格,训练和推理的实测吞吐都会按这张表重算。真正需要重新评估的是依赖内存带宽和 NVLink 的工作负载——大 batch 推理、长上下文服务、跨卡通信密集的 RL 训练,收益预期要往下压一档;而跨节点带宽敏感的部署(比如多机推理网关、分离式 Prefill/Decode)反而多出 12.5% 的余量。另外 NVL8 每卡少掉的那个堆栈,意味着 8 卡机可用的显存池比宣传少了 13%,做模型尺寸规划时这个缺口要提前留出来。
参考链接
- – 原文(ServeTheHome,2026-10-31):https://www.servethehome.com/nvidia-updates-rubin-gpu-specs-as-first-production-hardware-arrives/
- – 最早发现规格变动的报道(IT Home):https://www.ithome.com/1/017/812.htm
- – 相关前作(ServeTheHome,AMD MI455X 深度解析):https://www.servethehome.com/amd-instinct-mi455x-deep-dive-cdna-5-marks-the-next-era-of-instinct/5/
- – Oracle 关于 Vera Rubin 规模化交付的公告:https://www.oracle.com/news/announcement/ai-world-nvidia-and-oracle-expand-nvidia-vera-rubin-to-multi-gigawatt-scale-2026-10-27/
> 备注:NVIDIA 官方页面在 2026 年 9 月就已把 Rubin 系列的数字改成新版(IT Home 最早注意到);本次改口并非违约,NVIDIA 此前一直标注这些数字为”初步值、可能变动”。另外原文 NVL72 表格的 PFLOPS 列在评论区被读者指出前后不一致、作者本人已确认笔误,本处的算力行沿用原文表格原值,标注存疑,建议以单卡规格表为基准换算。